Análise Exploratória de Dados
Aula 04 — Módulo 1: Análise Exploratória
Heitor Ramos
Módulo 1 · Análise Exploratória
Antes de resumir uma base, precisamos descobrir o que suas linhas realmente significam.
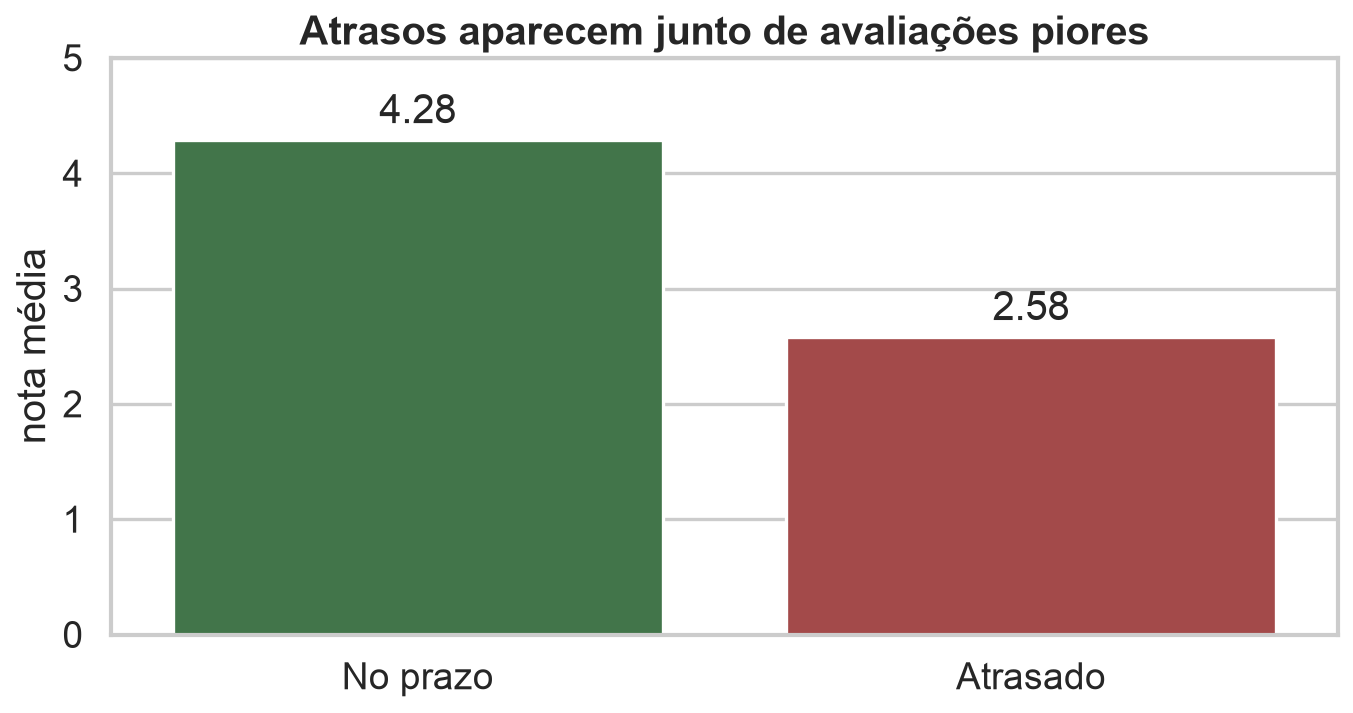
Um atraso aparece na avaliação?
Código do gráfico
"atrasou" )["nota" ].mean()
Resultado descritivo, não causal. Atrasos podem estar associados a outros problemas do pedido.
A base da aula
Brazilian E-Commerce Public Dataset by Olist
cerca de 100 mil pedidos no conjunto original;
compras realizadas entre 2016 e 2018;
clientes, pedidos, itens, pagamentos e avaliações;
dados comerciais anonimizados;
amostra didática reprodutível de 20 mil pedidos nesta aula.
Fonte: Kaggle — Olist Brazilian E-Commerce .
O que queremos compreender?
Como estrutura, prazo de entrega e experiência do cliente aparecem nos registros da plataforma?
Não tentaremos prever nem afirmar causalidade. O objetivo é aprender a transformar registros em evidência descritiva confiável.
Uma linha muda de significado entre tabelas
orders
Uma linha = um pedido.
order_items
Uma linha = um item dentro do pedido.
payments
Uma linha = uma parcela ou forma de pagamento.
reviews
Uma linha = uma avaliação registrada.
Principais tabelas e chaves
orders20.000
order_idcustomer_id
customers20.000
customer_idpedido → cliente
order_items22.735
order_id + order_item_iditem → pedido
payments20.979
order_id + payment_sequentialpagamento → pedido
reviews19.921
review_idavaliação → pedido
Há mais itens que pedidos e menos avaliações que pedidos. Essa diferença já revela granularidade e ausência.
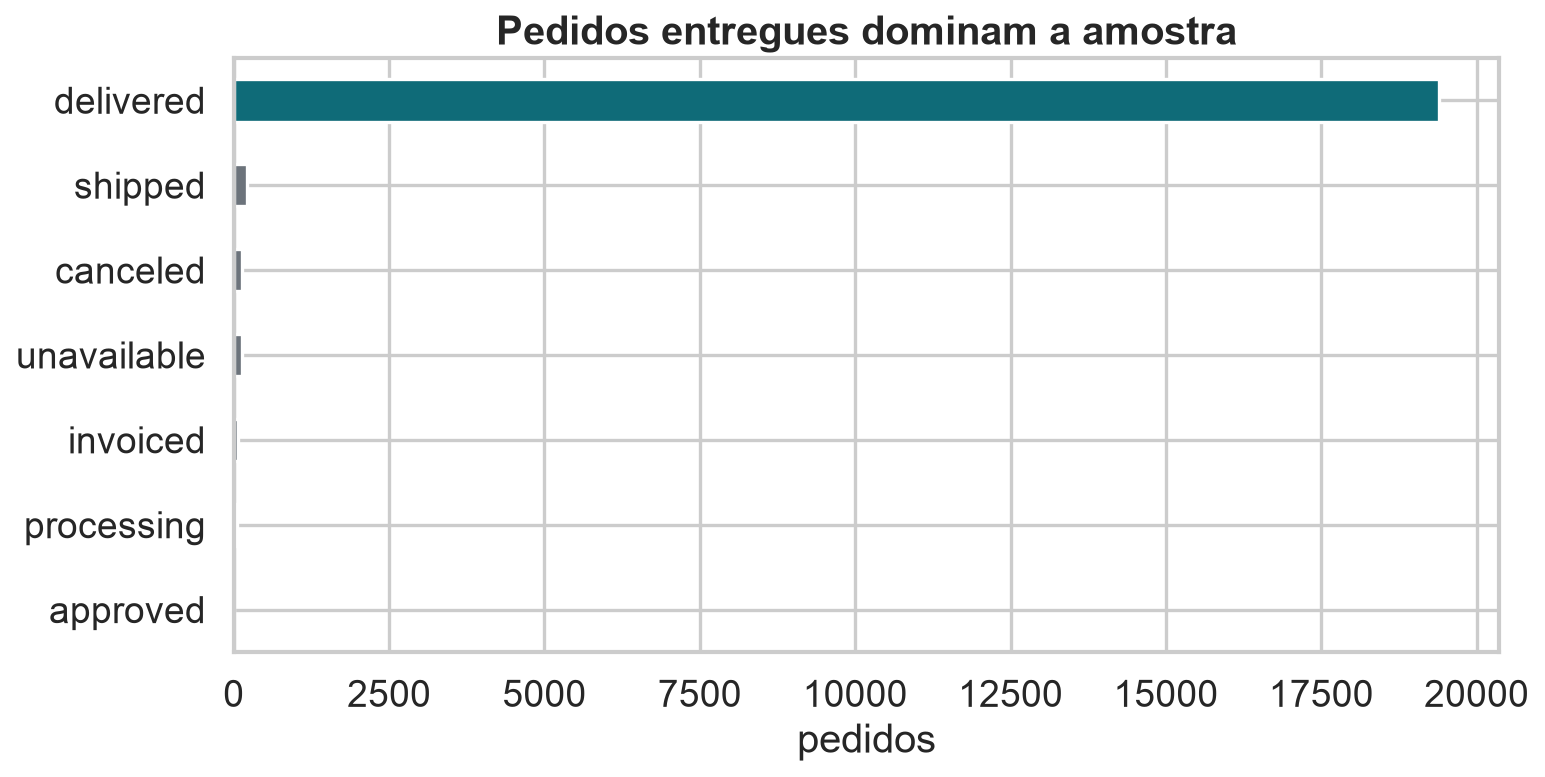
Entregues dominam a amostra
Resultado: aproximadamente 97% dos pedidos estão marcados como entregues.
Código do gráfico
"order_status" ].value_counts().plot.barh()
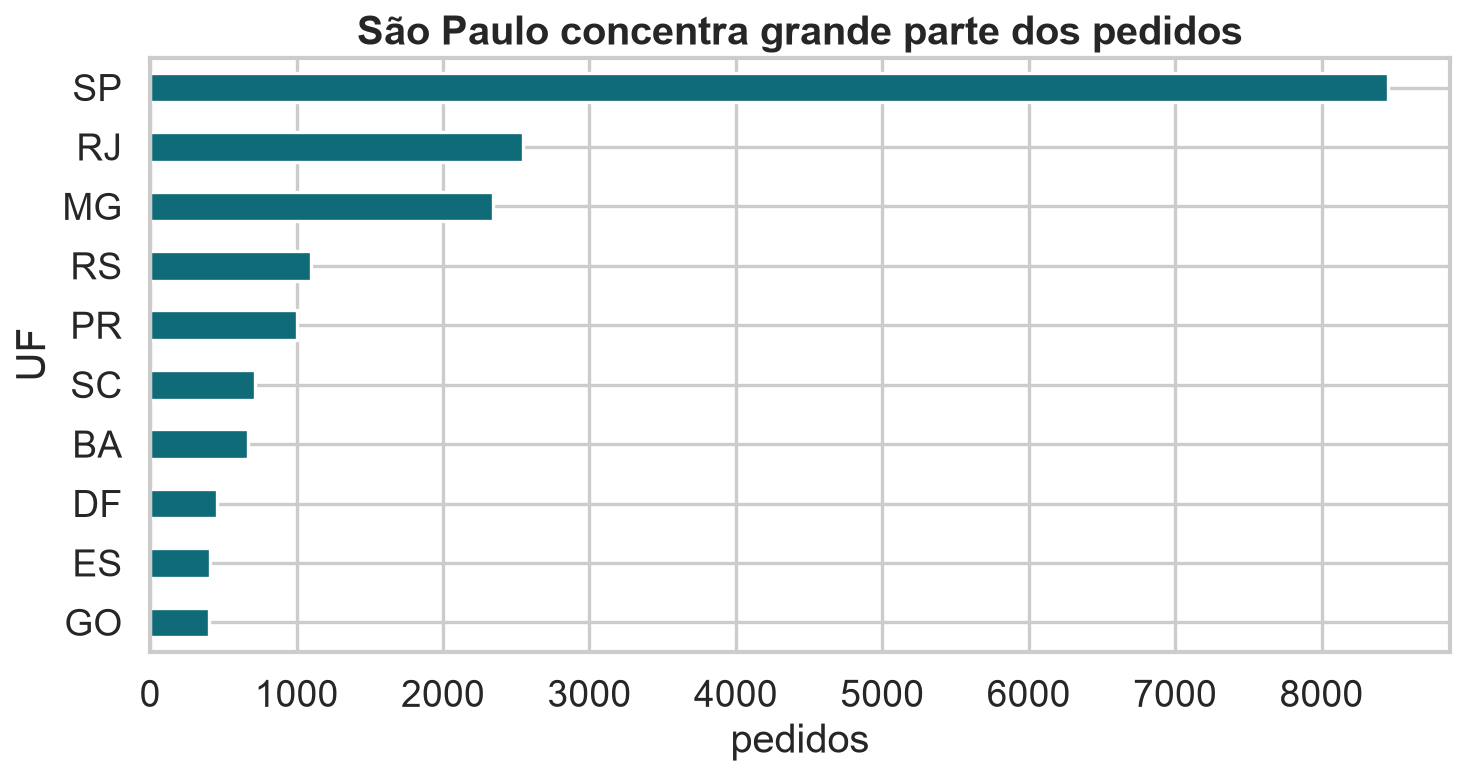
A distribuição geográfica é desigual
São Paulo responde por cerca de 42% dos pedidos da amostra.
Código do gráfico
"customer_state" ].value_counts().head(10 ).plot.barh()
EDA é investigação, não decoração
John Tukey popularizou a análise exploratória como uma forma de descobrir estrutura antes de formalizar modelos.
Uma visualização é útil quando muda a próxima pergunta que fazemos aos dados.
Cinco lentes para investigar uma base
Estrutura · como os registros se organizam?
Granularidade · o que representa uma linha?
Escopo · quem e o que ficaram de fora?
Temporalidade · quando cada variável foi registrada?
Corretude · os valores respeitam as regras do domínio?
EDA ocupa o centro do ciclo
flowchart LR
  A["Pergunta"] --> B["Coleta"]
  B --> C["Limpeza"]
  C --> D["EDA"]
  D --> E["Modelagem"]
  E --> F["Comunicação"]
  D --> A
  D --> C
A exploração frequentemente nos faz voltar à pergunta ou à limpeza.
Estrutura começa pelos arquivos
Uma base pode chegar como:
CSV ou TSV;
JSON;
planilha;
banco relacional;
API;
logs ou eventos.
O formato físico não define a unidade de observação nem garante qualidade.
Dados retangulares facilitam operações
Em uma tabela retangular:
linhas representam observações;
colunas representam atributos;
células guardam valores;
nomes de colunas descrevem variáveis.
Retangular é uma forma conveniente, não uma propriedade natural do fenômeno.
Chaves conectam tabelas
flowchart LR
  C["customers<br>customer_id"] --> O["orders<br>order_id"]
  O --> I["order_items<br>order_id + item"]
  O --> P["payments<br>order_id + sequência"]
  O --> R["reviews<br>review_id"]
Uma chave deve identificar linhas ou permitir uma ligação com cardinalidade conhecida.
Granularidade responde “uma linha de quê?”
"order_id" ].is_unique"order_id" ].is_uniqueorder_id identifica pedidos em orders, mas se repete em order_items.
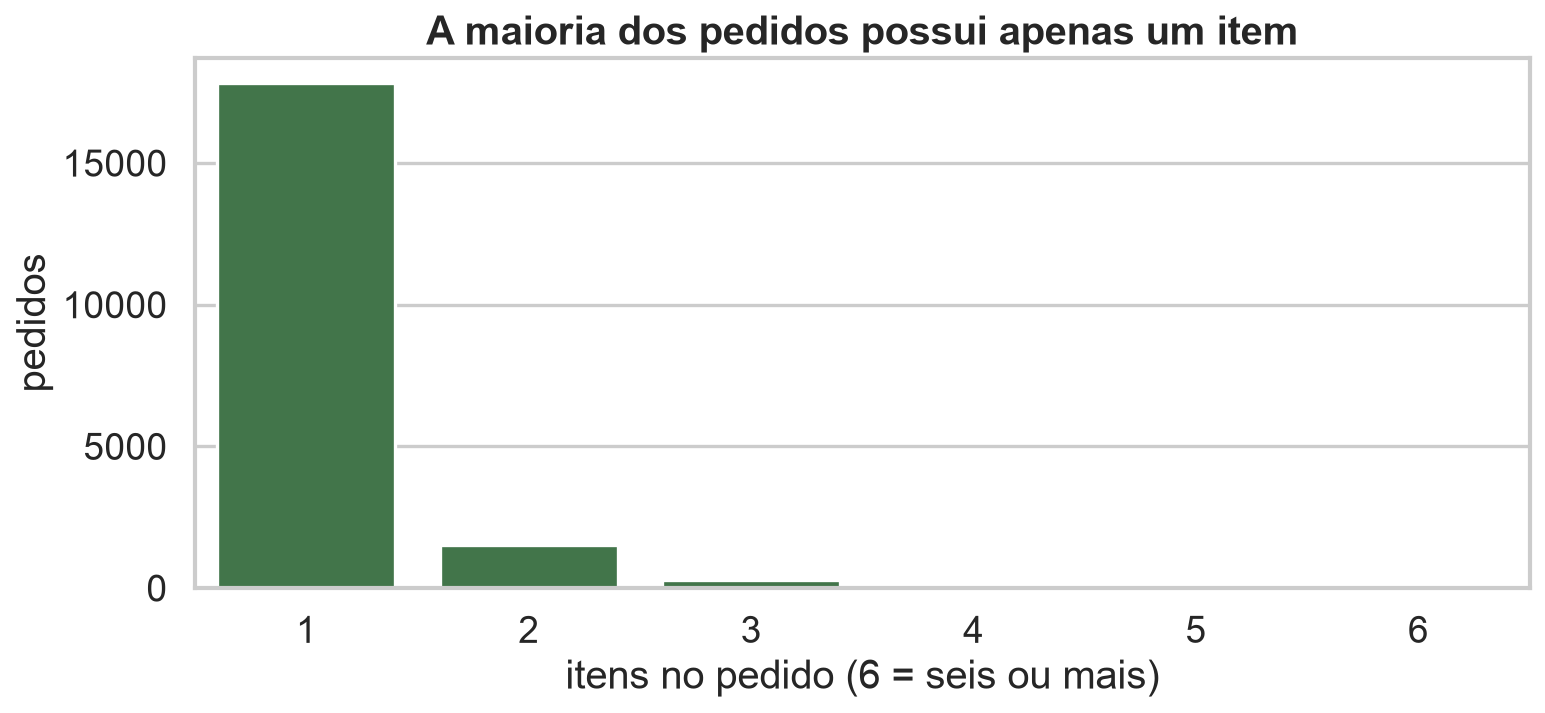
Um pedido pode possuir muitos itens
Na amostra, a mediana é um item e o máximo chega a 20 itens.
Código do gráfico
"order_id" ).size().clip(upper= 6 ).value_counts()
Um merge pode multiplicar linhas
= "order_id" ).shapeO resultado possui granularidade de item , não mais de pedido.
Somar pedidos depois desse merge contaria pedidos com vários itens mais de uma vez.
Agregue antes de voltar ao pedido
= ("order_id" )= ("order_item_id" , "size" ),= ("price" , "sum" ),= ("freight_value" , "sum" )
Resultado: 19.838 pedidos com itens, uma linha por order_id.
Tipos de junção respondem perguntas diferentes
inner
Mantém apenas chaves presentes nos dois lados.
left
Preserva todas as linhas da tabela principal.
right
Preserva todas as linhas da tabela adicionada.
outer
Preserva todas as chaves dos dois lados.
Declare a cardinalidade esperada
= orders.merge(= "customer_id" ,= "left" ,= "many_to_one"
Resultado: (20000, 12) — nenhum pedido foi perdido e cada customer_id encontrou no máximo um registro.
validate transforma uma suposição silenciosa em teste executável.
O merge analítico preserva pedidos
= (= "order_id" , how= "left" , validate= "one_to_one" )= "order_id" , how= "left" , validate= "one_to_one" )
Resultado: analysis.shape → (20000, 20).
Cada linha continua representando um pedido.
Escopo define até onde podemos concluir
A base registra pedidos:
realizados na plataforma Olist;
em múltiplos marketplaces brasileiros;
entre setembro de 2016 e outubro de 2018;
com clientes e vendedores anonimizados.
Ela não representa automaticamente todo o comércio eletrônico brasileiro.
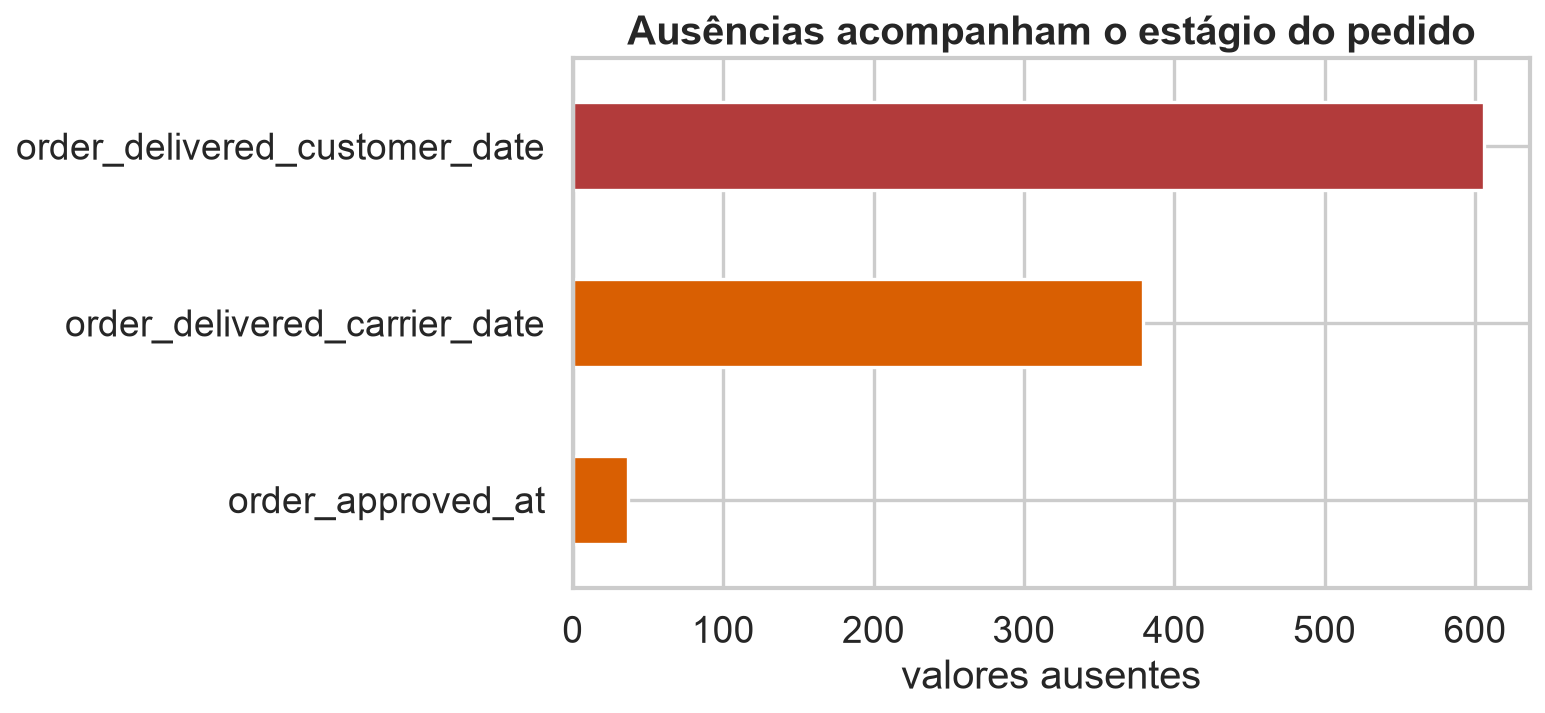
Ausência pode descrever o processo
Datas posteriores ao pedido faltam mais frequentemente.
Código do gráfico
sum ().loc[lambda x: x > 0 ].plot.barh()
O status explica parte das ausências
"order_status" ],"order_delivered_customer_date" ].isna()
Pedidos cancelados, enviados ou indisponíveis frequentemente não possuem data de entrega — como esperado pelo processo.
Três estratégias, três significados
Manter NaN
Quando a ausência tem significado e a análise aceita valores faltantes.
Remover linhas
Quando a unidade não serve à pergunta e a perda é explicitada.
Preencher
Quando existe uma regra defensável — nunca apenas para “sumir com o NaN”.
dropna() pode mudar a população
O resultado mantém sobretudo pedidos entregues e elimina muitos pedidos interrompidos.
Limpar sem registrar a regra redefine silenciosamente o fenômeno estudado.
Corretude vira um conjunto de testes
assert orders["order_id" ].is_uniqueassert items["price" ].ge(0 ).all ()assert items["freight_value" ].ge(0 ).all ()assert reviews["review_score" ].between(1 , 5 ).all ()Testes simples capturam violações antes que entrem em gráficos e resumos.
Duplicata depende da chave
sum ()"order_id" ].duplicated().sum ()Alguns pedidos possuem mais de uma avaliação. Precisamos agregar antes do merge por pedido.
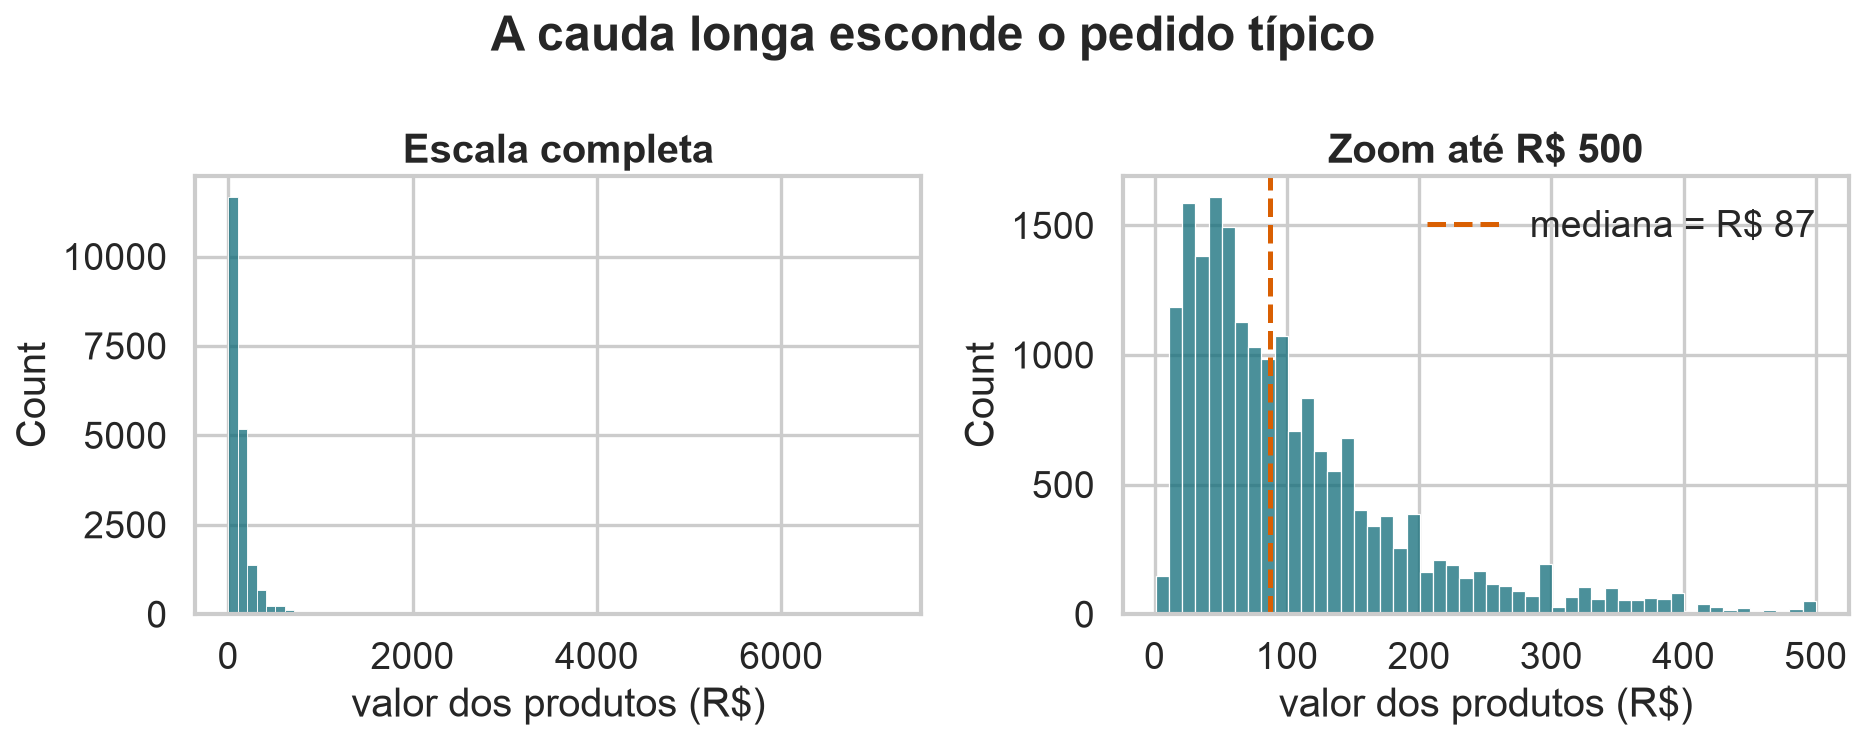
A cauda longa esconde o pedido típico
Resultado: mediana de R$ 86,99; a média é maior por causa da cauda à direita.
Código do gráfico
"valor_produtos" ], bins= 70 )"valor_produtos <= 500" )["valor_produtos" ])
Outlier não é sinônimo de erro
Um valor extremo pode ser:
erro de digitação;
unidade incorreta;
pedido legítimo de alto valor;
composição de muitos itens;
evento raro que interessa à análise.
Investigue o registro e o processo antes de remover.
Temporalidade começa convertendo datas
= [c for c in orders if c.endswith(("timestamp" , "date" , "at" ))]= orders[date_cols].apply (pd.to_datetime)
Resultado: compras registradas entre 04/09/2016 e 17/10/2018.
Datas como texto não permitem diferenças, ordenação temporal segura ou reamostragem.
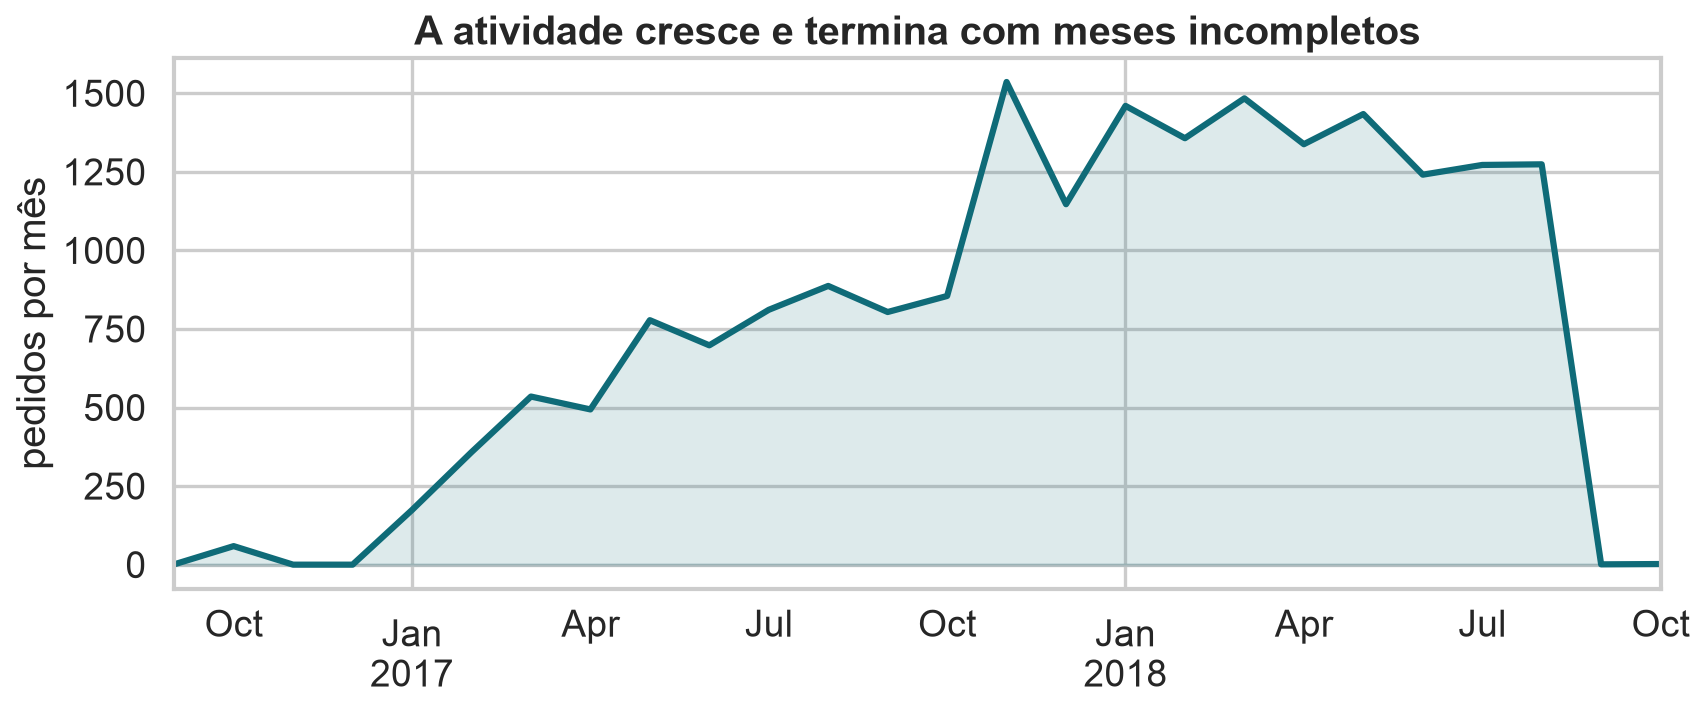
Os meses finais estão incompletos
Setembro e outubro de 2018 não devem ser comparados como meses completos.
Código do gráfico
"order_purchase_timestamp" ).resample("MS" ).size()
A granularidade temporal muda a história
= orders.resample("D" , on= "order_purchase_timestamp" ).size()= orders.resample("MS" , on= "order_purchase_timestamp" ).size()
diário: revela picos e ruído;
semanal: suaviza o calendário;
mensal: mostra tendência, mas esconde eventos curtos.
Escolha a escala que corresponde à pergunta.
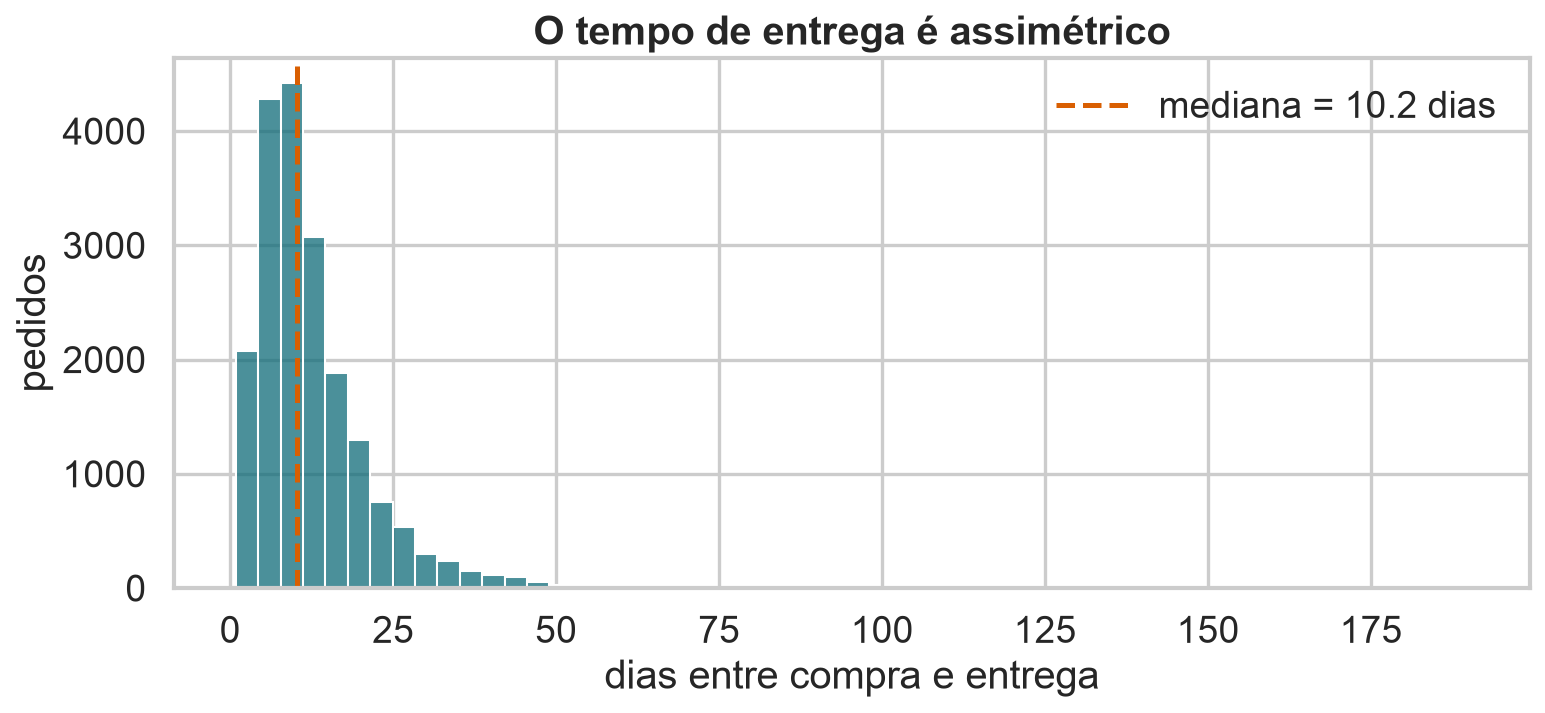
O tempo de entrega é assimétrico
Resultado: mediana de 10,2 dias; a média é maior por causa de entregas longas.
Código do gráfico
"entrega_dias" ] = ("order_delivered_customer_date" ]- entregues["order_purchase_timestamp" ]/ 86400
Atraso exige duas datas
"atraso_dias" ] = ("order_delivered_customer_date" ]- entregues["order_estimated_delivery_date" ]/ 86400 "atrasou" ] = entregues["atraso_dias" ] > 0
Resultado: 8,1% dos pedidos entregues chegaram depois da estimativa.
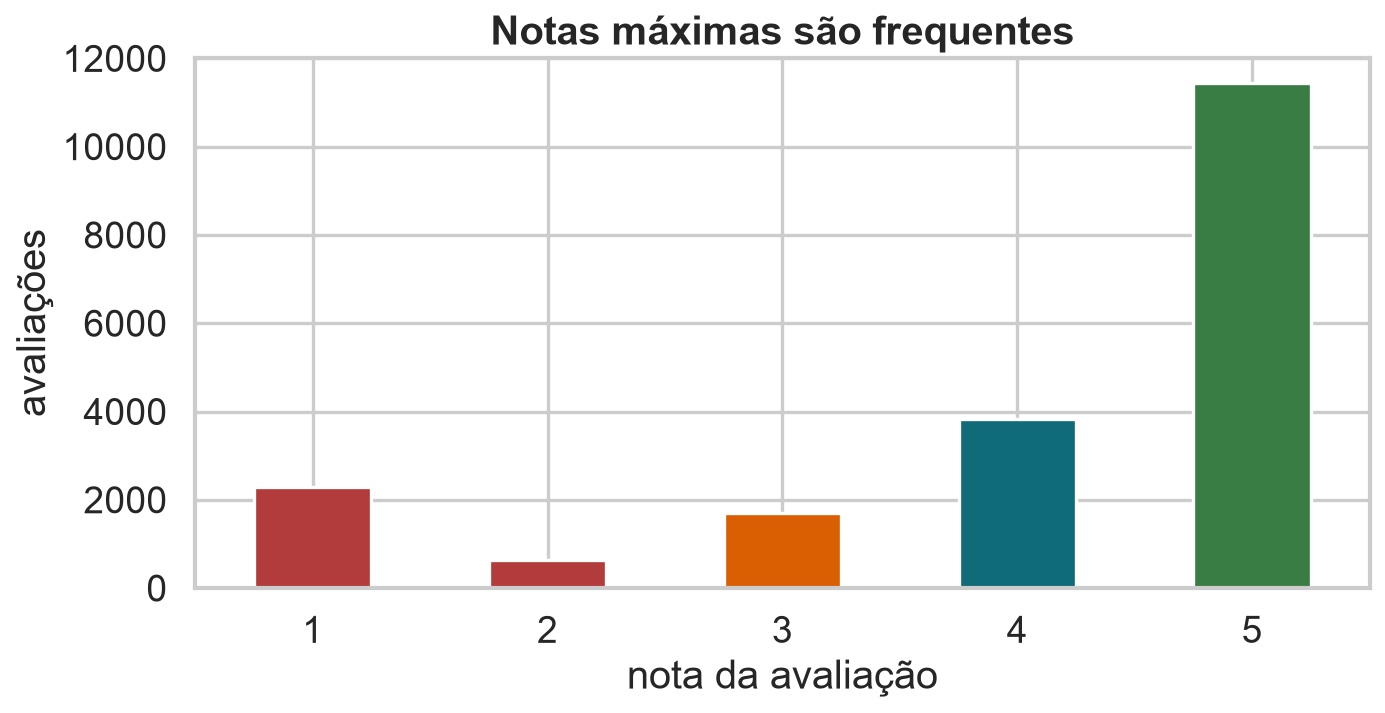
Avaliações também são seletivas
Notas 5 são frequentes, mas nem todo pedido possui avaliação disponível.
Código do gráfico
"review_score" ].value_counts().sort_index().plot.bar()
Atraso e nota se movem juntos
No prazo: 4,28 · Atrasado: 2,58
A diferença é grande o suficiente para motivar novas perguntas sobre logística e satisfação.
Associação não fecha a investigação
Pedidos atrasados podem também:
percorrer distâncias maiores;
envolver certos vendedores ou produtos;
ocorrer em períodos de pico;
sofrer outros problemas não registrados.
EDA revela padrões e hipóteses; causalidade exige um desenho de estudo apropriado.
Um pipeline reproduzível
= (= "customer_id" , validate= "many_to_one" )= "order_id" , how= "left" , validate= "one_to_one" )= "order_id" , how= "left" , validate= "one_to_one" )= lambda d: (- d.order_purchase_timestamp
O que aprendemos
EDA investiga como os dados foram produzidos e organizados.
Granularidade deve ser definida antes de agregar ou juntar.
Ausência, duplicação e extremos podem conter informação.
Escala temporal e escopo limitam as conclusões.
validate e testes de domínio tornam a preparação verificável.Padrões exploratórios geram hipóteses, não provas causais.
Material de apoio
Próxima aula: como transformar distribuições em comparações visuais honestas?
Na próxima aula, avançaremos de auditoria e preparação para princípios de visualização e descrição de distribuições.