\(K\) é o número de atrasos em \(n\) pedidos; \(p_0=0{,}08\) é o valor imposto por \(H_0\); \(\widehat p=K/n\) é a proporção amostral. O índice zero em \(\operatorname{SE}_0\) indica que o erro padrão é calculado sob a hipótese nula.
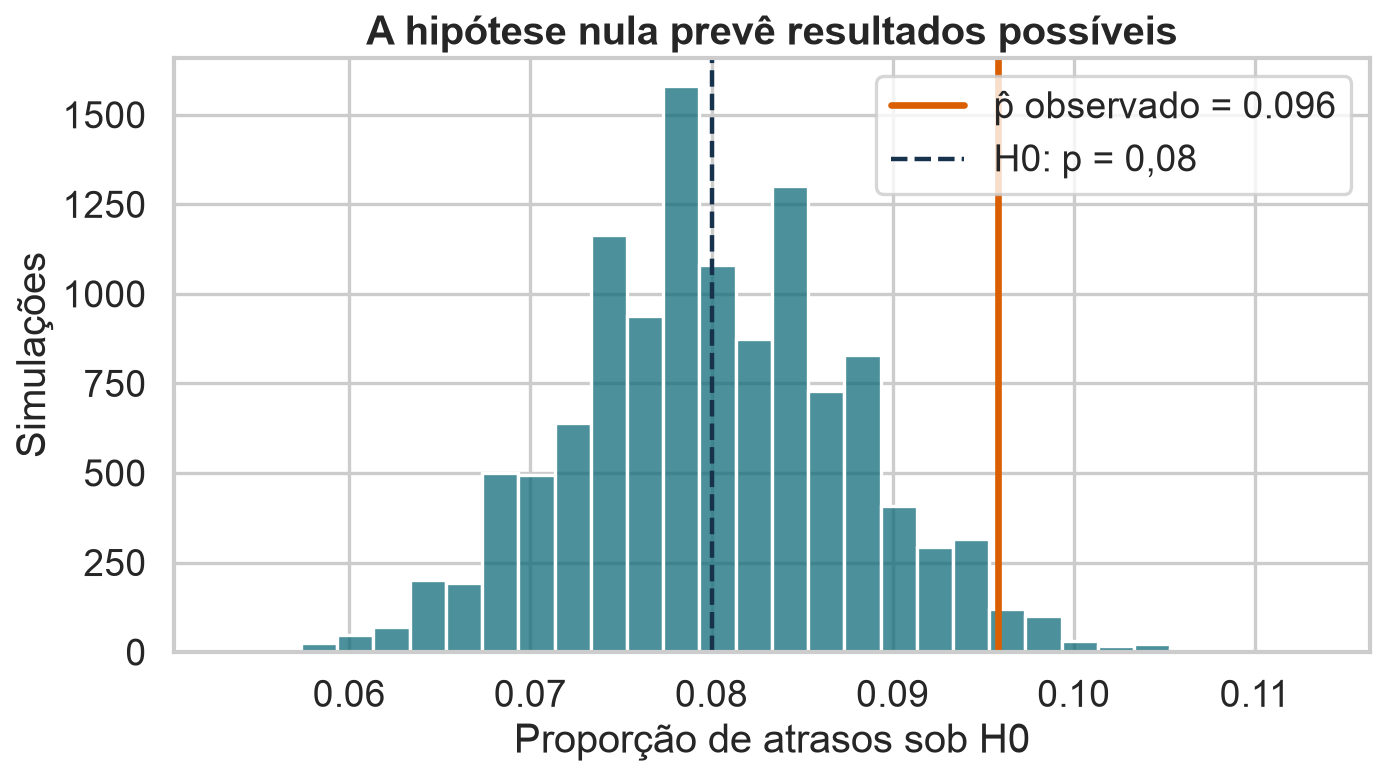
A distribuição nula
O valor observado está à direita do centro previsto por \(H_0\).
\(Z\) mede quantos erros padrão separam a amostra de \(H_0\): \(\widehat p\) é a taxa observada, \(p_0\) é a taxa nula e \(n\) é o tamanho amostral. Sob \(H_0\) e condições adequadas, \(Z\approx N(0,1)\).
Se \(H_0\) fosse verdadeira, a estimativa estaria 2,02 erros padrão acima do esperado.
O p-valor mede extremidade
Para o teste unilateral:
\[
p\text{-valor}=P(Z\ge2{,}02\mid H_0)
\]
Neste exemplo:
\[
p\text{-valor}\approx0{,}0216
\]
A probabilidade é calculada assumindo \(H_0\). O evento \(Z\ge2{,}02\) reúne resultados pelo menos tão favoráveis a \(H_1\) quanto o observado; não é a probabilidade de \(H_0\) ser verdadeira.
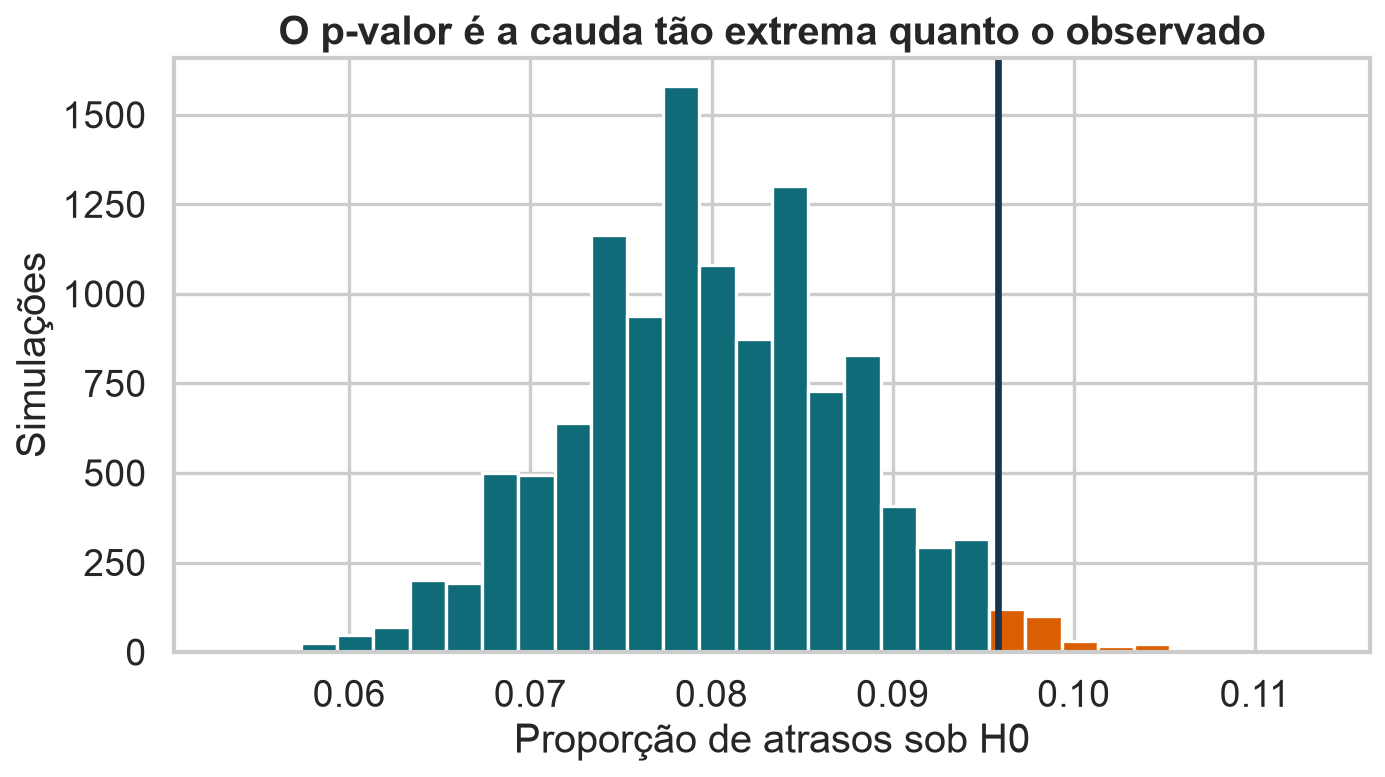
A cauda representa o p-valor
Contamos resultados tão ou mais favoráveis a \(H_1\) que o observado.
Código do gráfico
counts, bins = np.histogram(null_props, bins=30)centers = (bins[:-1] + bins[1:]) /2plt.figure(figsize=(9, 5.2))colors = [ORANGE if c >= p_hat else BLUE for c in centers]plt.bar(centers, counts, width=np.diff(bins), color=colors, align="center")plt.axvline(p_hat, color=INK, lw=3)plt.xlabel("Proporção de atrasos sob H0")plt.ylabel("Simulações")plt.title("O p-valor é a cauda tão extrema quanto o observado")finish("pvalor-cauda.png")
O p-valor não é
a probabilidade de \(H_0\) ser verdadeira;
a probabilidade de o resultado ter ocorrido por acaso;
o tamanho do efeito;
a importância prática da diferença;
a chance de replicação do estudo.
É uma probabilidade calculada assumindo \(H_0\).
O que o valor-p responde?
Um valor-p de 0,02 significa que:
\(H_0\) tem 2% de probabilidade de ser verdadeira
Sob \(H_0\), resultados tão ou mais extremos ocorreriam com probabilidade 2%
Há 98% de probabilidade de o efeito ser relevante
Somente 2% dos dados são compatíveis com \(H_0\)
Nível de significância
Escolhemos antes do teste um limite \(\alpha\) para o erro tipo I.
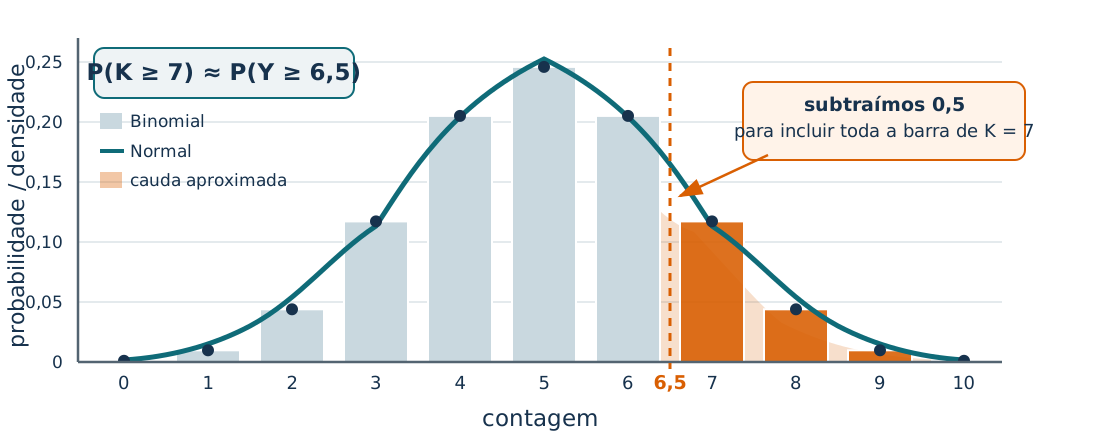
O acréscimo de 1 evita um p-valor simulado igual a zero. \(K_b\) é o número de atrasos na simulação \(b\) sob \(H_0\).
B =100_000rng_pvalor = np.random.default_rng(20260914)contagens_nulas = rng_pvalor.binomial(n=1200, p=0.08, size=B)pvalor_sim = (1+ np.sum(contagens_nulas >=115)) / (B +1)print(f"p-valor por simulação = {pvalor_sim:.4f}")
Simulação torna a lógica visível e generaliza para estatísticas complexas.
Três caminhos, mesma pergunta
Método
Vantagem
Limite
Exato
sem aproximação
pode ser difícil
Normal/TCL
fórmula rápida
depende de condições
Simulação
flexível e visual
tem erro Monte Carlo
Resultados próximos aumentam nossa confiança na implementação.
Toda decisão pode errar
Realidade
Não rejeitar \(H_0\)
Rejeitar \(H_0\)
\(H_0\) verdadeira
decisão correta
erro tipo I
\(H_1\) verdadeira
erro tipo II
decisão correta
Não existe regra que elimine os dois erros simultaneamente.
Erro tipo I
Rejeitar \(H_0\) quando ela é verdadeira.
No contexto:
Concluir que a taxa excede 8% quando ela é exatamente 8%.
Sua probabilidade é controlada por \(\alpha\).
Erro tipo I e nível \(\alpha\)
Para um teste calibrado com nível exato \(\alpha\):
\[
\boxed{P_{H_0}(\text{rejeitar }H_0)=\alpha}
\]
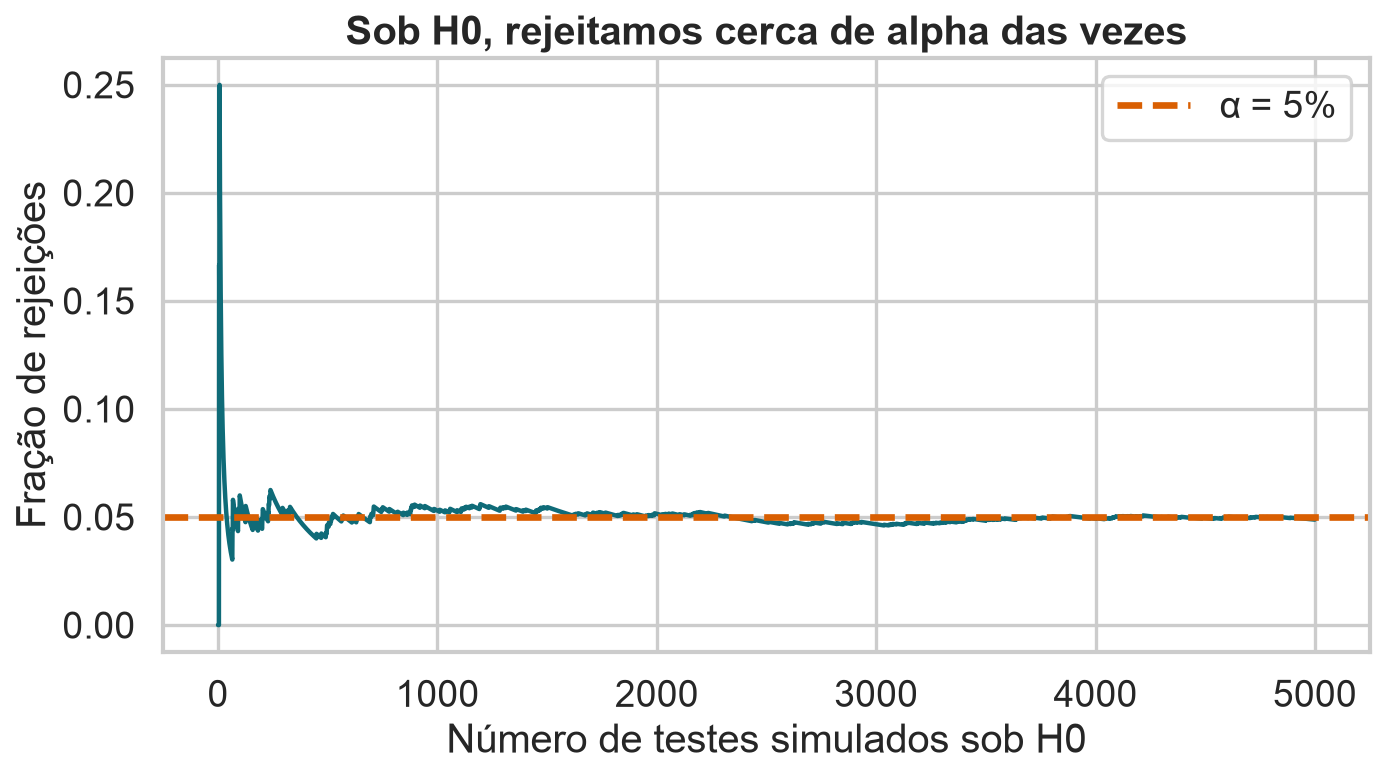
Interpretação. Se \(H_0\) for verdadeira e repetirmos o estudo, rejeitaremos \(H_0\) em uma fração \(\alpha\) das repetições. O símbolo \(P_{H_0}\) indica que a probabilidade é calculada supondo \(H_0\) verdadeira.
Precisão matemática. Em geral, um teste de nível \(\alpha\) garante
\[
P_{H_0}(\text{rejeitar }H_0)\leq\alpha.
\]
Testes discretos podem ser conservadores. A igualdade vale quando o teste usa exatamente todo o nível \(\alpha\).
Alpha aparece nas repetições
Com \(H_0\) verdadeira, cerca de 5% dos testes rejeitam por acaso quando \(\alpha=5\%\).
Código do gráfico
rejections = []running = []for i inrange(1, 5001): ph = rng.binomial(1200, p0) /1200 z = (ph - p0) / se0 rejections.append(z >1.645) running.append(np.mean(rejections))plt.figure(figsize=(9, 5.2))plt.plot(running, color=BLUE, lw=2)plt.axhline(.05, color=ORANGE, lw=3, ls="--", label="α = 5%")plt.xlabel("Número de testes simulados sob H0")plt.ylabel("Fração de rejeições")plt.title("Sob H0, rejeitamos cerca de alpha das vezes")plt.legend()finish("erro-tipo-i.png")
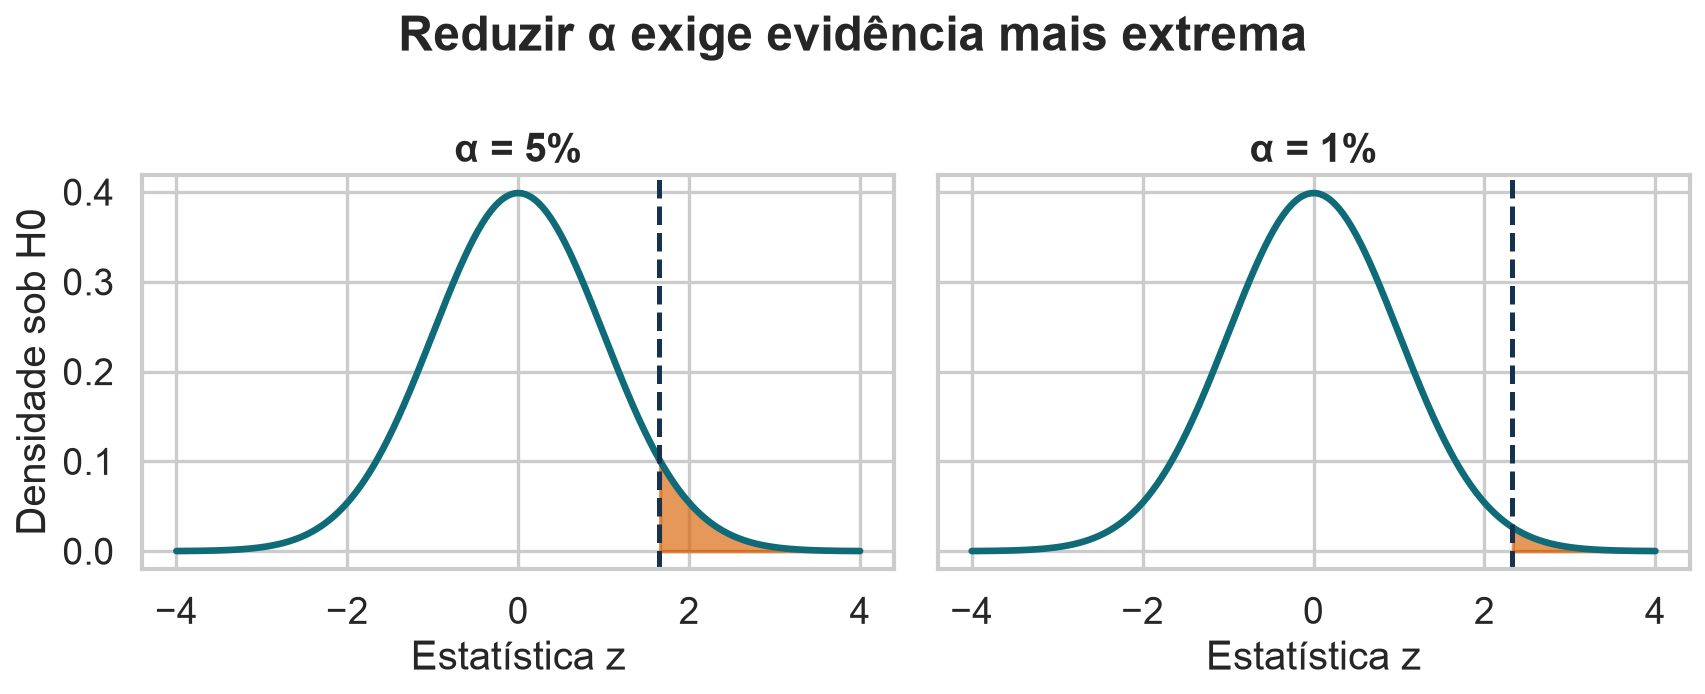
Reduzir alpha tem um custo
Um \(\alpha\) menor:
reduz falsos positivos;
exige evidência mais extrema;
aumenta a chance de não detectar efeitos reais;
pode exigir amostras maiores.
A escolha deve refletir o custo dos erros.
Erro tipo II
Não rejeitar \(H_0\) quando \(H_1\) é verdadeira.
No contexto:
Não detectar uma taxa realmente superior a 8%.
Sua probabilidade é \(\beta\).
Poder estatístico
\[
\text{poder}=1-\beta
\]
Aqui, \(\beta=P_{\theta_1}(\text{não rejeitar }H_0)\) é a probabilidade de erro tipo II sob um valor alternativo específico \(\theta_1\). Portanto, \(1-\beta=P_{\theta_1}(\text{rejeitar }H_0)\).
O poder depende do valor verdadeiro sob a alternativa.
Uma amostra maior aumenta a área de poder
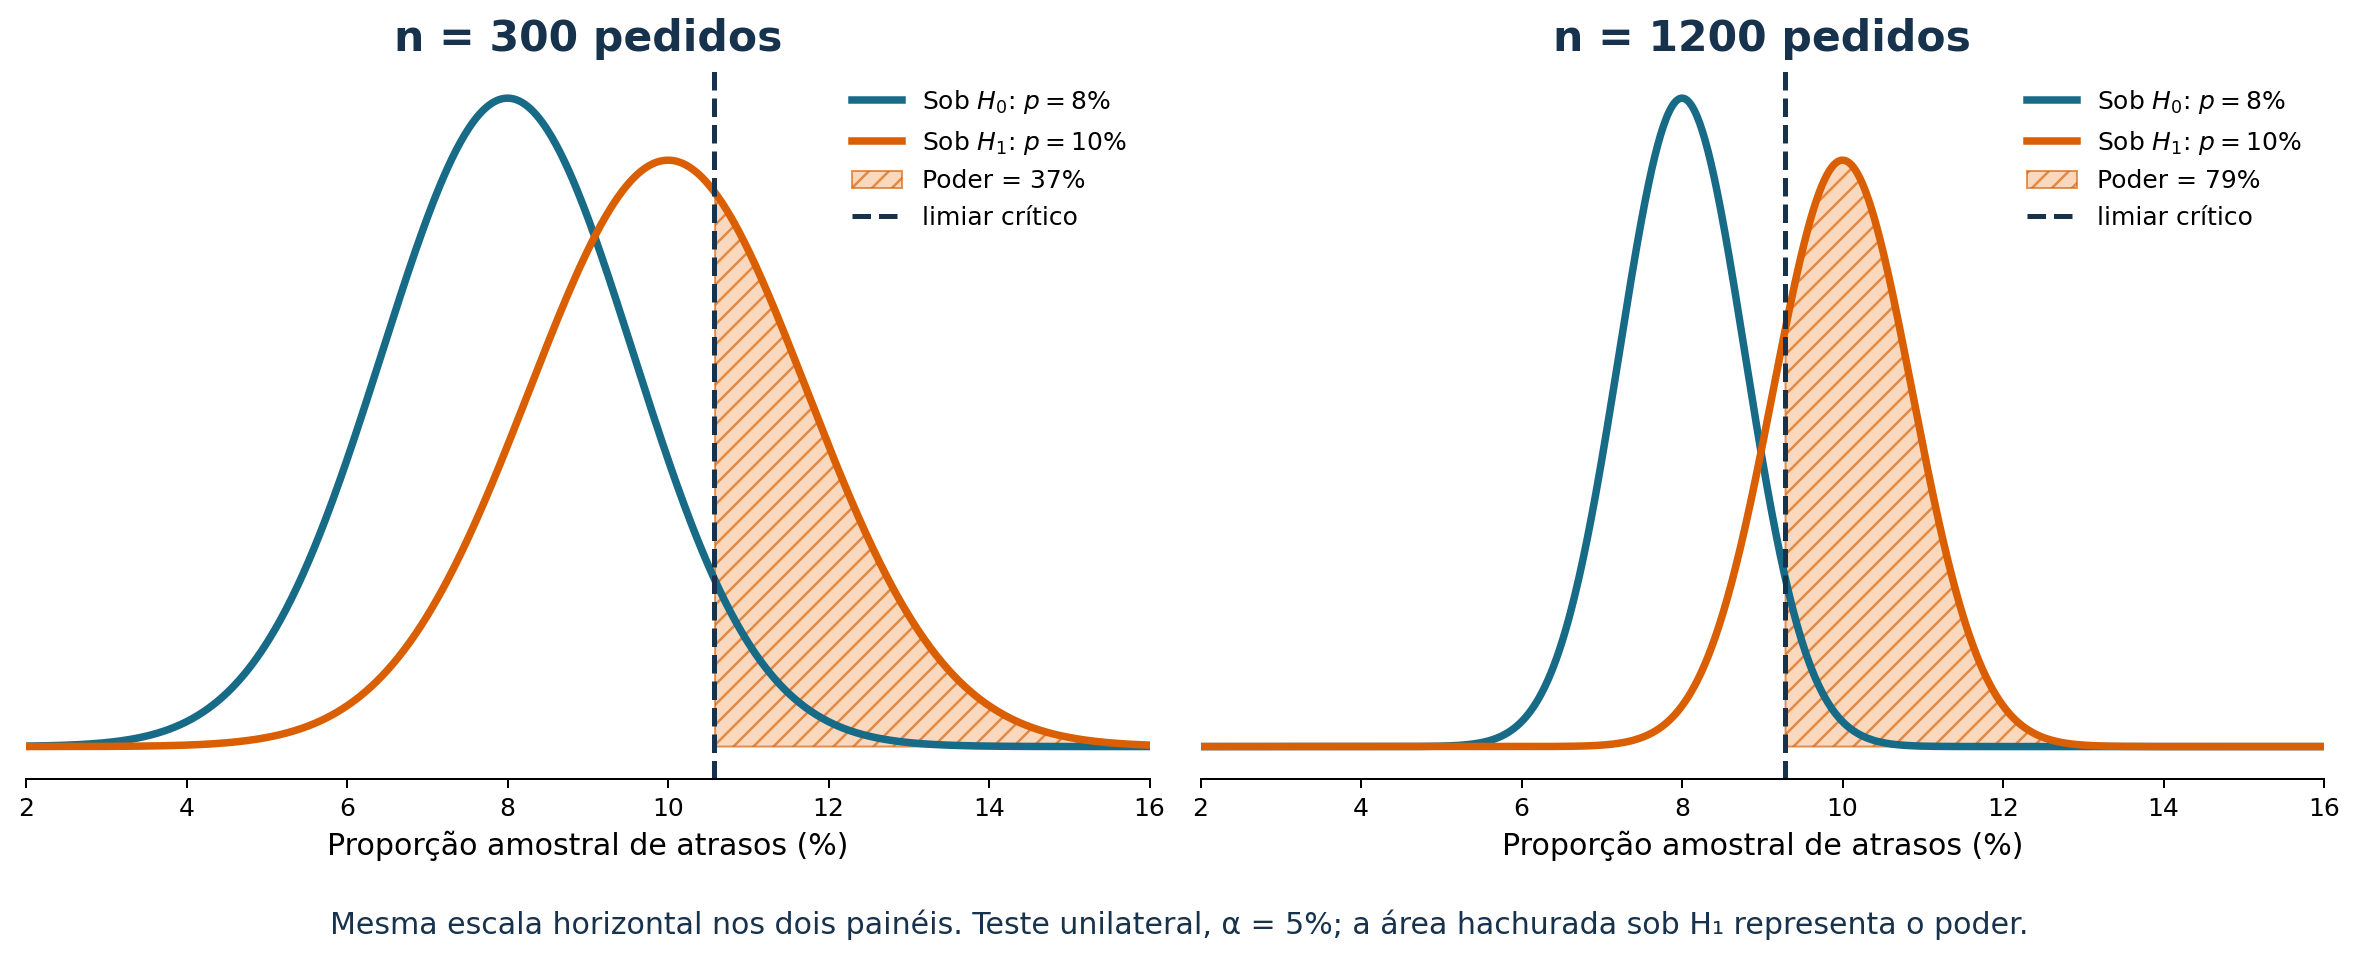
Mantendo \(p_0=8\%\), \(p_1=10\%\) e \(\alpha=5\%\), aumentar \(n\) estreita as duas distribuições. A área de \(H_1\) além do limiar crítico cresce de 37% para 79%.
Na figura, o efeito permanece de 8% para 10%, mas \(n\) cresce de 300 para 1.200. Por que o poder aumenta?
As distribuições ficam mais estreitas e se sobrepõem menos
A hipótese alternativa se afasta automaticamente de \(H_0\)
\(\alpha\) aumenta junto com a amostra
O erro tipo I deixa de existir
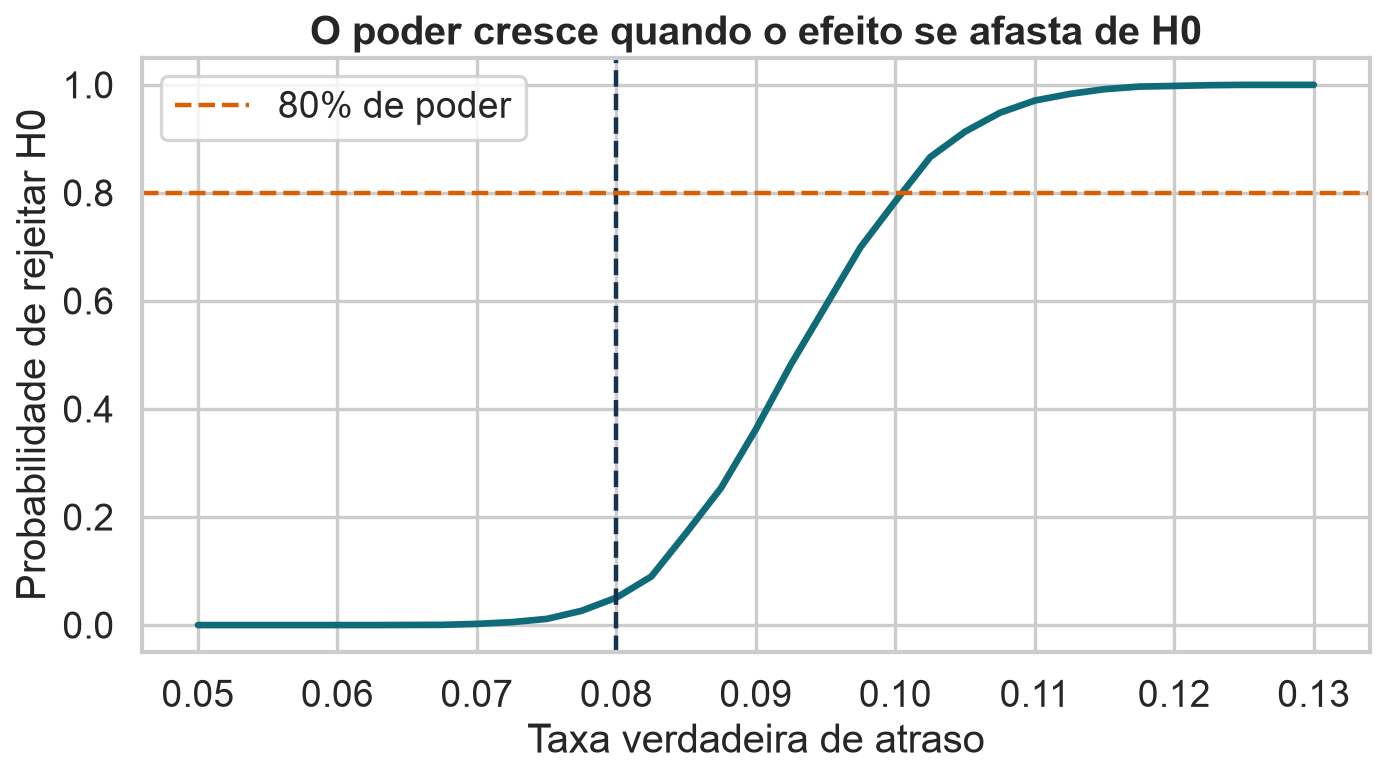
O poder cresce com o efeito
É mais fácil detectar 12% que 8,5% de atrasos.
Código do gráfico
true_ps = np.linspace(.05, .13, 33)critical = p0 +1.645* se0power = []for p in true_ps: simulated = rng.binomial(1200, p, size=5000) /1200 power.append(np.mean(simulated > critical))plt.figure(figsize=(9, 5.2))plt.plot(true_ps, power, color=BLUE, lw=3)plt.axvline(p0, color=INK, ls="--", lw=2)plt.axhline(.8, color=ORANGE, ls="--", lw=2, label="80% de poder")plt.xlabel("Taxa verdadeira de atraso")plt.ylabel("Probabilidade de rejeitar H0")plt.title("O poder cresce quando o efeito se afasta de H0")plt.legend()finish("curva-poder.png")
Tamanho da amostra aumenta o poder
Com mais observações:
o erro padrão diminui;
uma mesma diferença produz \(|Z|\) maior;
efeitos pequenos tornam-se detectáveis;
resultados muito pequenos podem ficar significativos.
Planejar \(n\) exige definir o menor efeito relevante.
Tamanho do efeito importa
A diferença observada foi:
\[
0{,}0958-0{,}08=0{,}0158
\]
Ou 1,58 ponto percentual.
Pergunta operacional: essa diferença justifica uma ação?
Significância não é importância
Estatística
O resultado seria raro sob \(H_0\)?
Prática
O efeito tem magnitude e consequência relevantes?
Sempre reporte estimativa e intervalo, não apenas p-valor.
Um teste A/B é um experimento
A — controle
Experiência atualmente usada. Ela fornece a referência para a comparação.
B — tratamento
Uma única mudança planejada em relação ao controle.
Atribuição aleatória
Distribui unidades entre A e B antes de observar a resposta.
O efeito é causal quando a randomização e o acompanhamento são preservados.
Exemplo A/B no contexto da Olist
Imagine que a operação desenvolveu um alerta preventivo de risco de atraso para pedidos elegíveis.
Versão A — processo atual
O pedido segue o fluxo logístico normalmente usado.
Versão B — novo alerta
Um alerta antecipado permite priorizar pedidos com maior risco operacional.
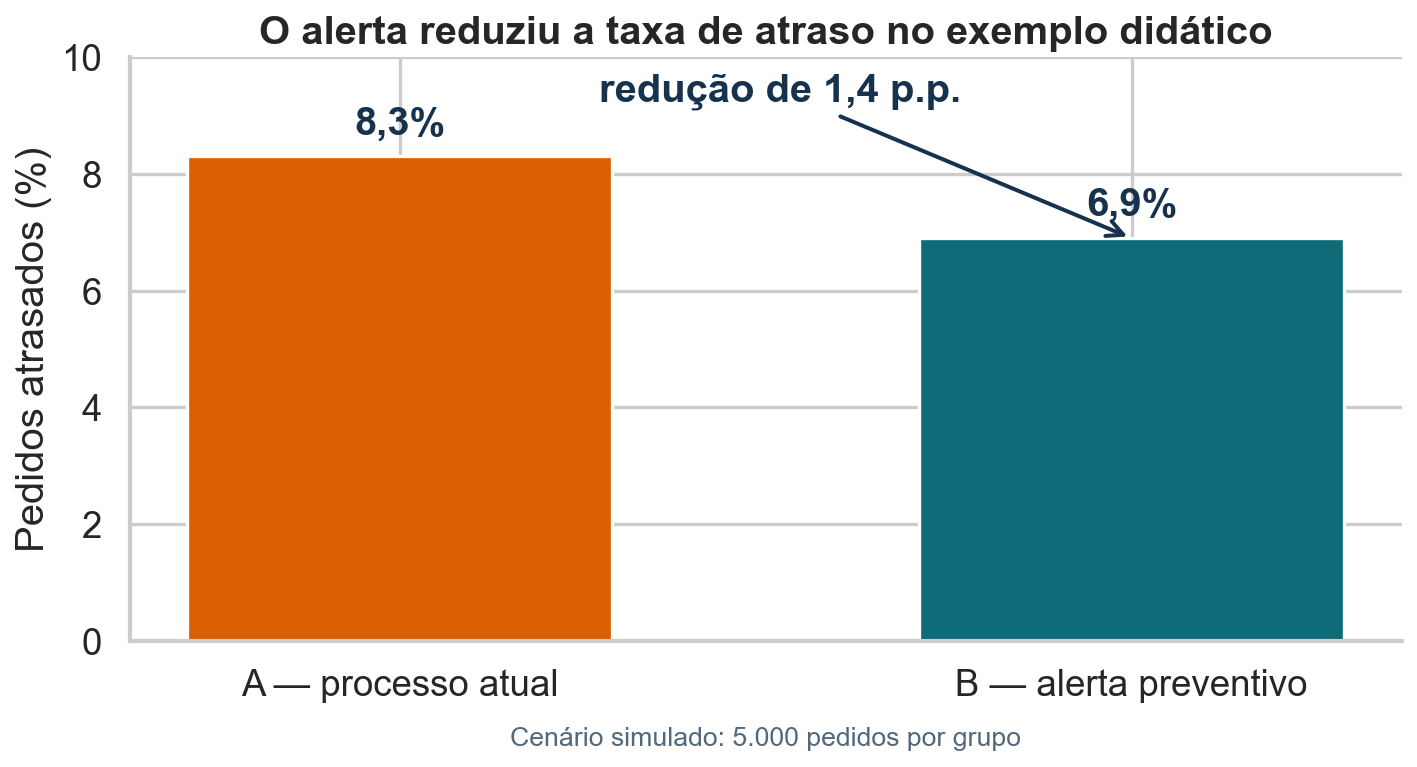
Pedidos seriam atribuídos aleatoriamente aos dois processos. A base Olist original é observacional: os números a seguir formam um experimento didático simulado, calibrado por suas taxas de atraso.
Da pergunta às hipóteses
Pergunta: o alerta reduz a probabilidade de um pedido chegar depois da data prevista?
\(p_A\) e \(p_B\) são as probabilidades de atraso nos dois processos. A alternativa foi definida antes dos dados: valores negativos favorecem o alerta.
O que aconteceu no experimento didático?
Em 5.000 pedidos por grupo, atrasaram 415 em A e 345 em B:
O valor-p aproximado é \(0{,}0041\), menor que \(\alpha=0{,}05\). Portanto, rejeitamos \(H_0\) e encontramos evidência de que o alerta reduz a taxa de atraso.
Isso não encerra a decisão: também precisamos avaliar se 140 atrasos evitados por 10 mil pedidos compensam o custo do alerta e se nenhuma métrica de proteção piorou.
Muitos testes aumentam falsos positivos
Se fazemos 20 testes independentes com \(\alpha=5\%\):
\[
P(\text{ao menos um falso positivo})
=1-0{,}95^{20}\approx64\%
\]
São estratégias complementares — apenas a segunda é uma correção matemática:
Pré-registro
Definir hipóteses, desfechos e análises antes de observar os resultados reduz escolhas oportunistas.
Correções
Ajustar o limiar ou os valores-p (por exemplo, Bonferroni ou Holm) controla o erro da família de testes.
Validação externa
Verificar o achado em novos dados independentes testa se ele se repete fora da amostra original.
Teste unilateral ou bilateral?
Use unilateral somente quando:
a direção foi definida antes dos dados;
o efeito oposto não levaria à mesma ação;
a justificativa é substantiva, não conveniência.
Caso contrário, prefira o teste bilateral.
Condições do teste de proporção
Verifique:
amostra representativa;
observações independentes;
resultado realmente binário;
valor nulo definido antes da análise;
contagens esperadas adequadas para a aproximação.
Fluxo de um teste
Defina parâmetro e pergunta.
Especifique \(H_0\) e \(H_1\).
Escolha estatística e \(\alpha\).
Verifique condições.
Calcule p-valor ou simule sob \(H_0\).
Conclua no contexto e reporte efeito e intervalo.
Em um A/B, acrescente antes da coleta: unidade de randomização, versão de controle, mudança aplicada, métrica primária, duração e regra de parada.
Atividade: tome uma decisão
Em 800 pedidos, 76 atrasaram. Teste \(H_0:p=0{,}08\) contra \(H_1:p>0{,}08\).
Calcule \(\widehat{p}\) e o erro padrão nulo.
Calcule \(Z\).
Interprete o p-valor.
Decida para \(\alpha=5\%\) e \(1\%\).
Discuta a importância prática.
O que aprendemos
Um teste compara o observado ao previsto por \(H_0\).
O p-valor mede extremidade sob \(H_0\).
\(\alpha\) controla o erro tipo I.
Poder mede a chance de detectar um efeito real.
Significância não substitui tamanho do efeito e contexto.
Um teste A/B combina randomização, uma métrica definida previamente e inferência sobre o efeito da mudança.
Fechamento
Inferência não elimina a incerteza; ela torna explícito como decidimos dentro dela.
Boas conclusões combinam desenho, estimativa, intervalo, p-valor e consequência prática.
Fonte dos dados
Brazilian E-Commerce Public Dataset by Olist, Kaggle: olistbr/brazilian-ecommerce.
Cerca de 100 mil pedidos reais e anonimizados, de 2016 a 2018.
Material conceitual adaptado do PDF fornecido para a disciplina.