Aula 15 — Módulo 2: Inferência Estatística
Mover uma barreira do nível 30 para o nível 40 melhora a experiência dos jogadores?
Estratos
Como respeitar grupos definidos antes do experimento?
Múltiplas métricas
Como evitar descobertas ocasionais?
Poder
Qual a chance de detectar um efeito relevante?
Uma única história conecta desenho experimental, decisão e planejamento.
gate_30 e gate_40;Fonte: Kaggle, matinmahmoudi/rounds-and-retention.
Controle
Primeira barreira no nível 30.
Tratamento
Primeira barreira no nível 40.
Resultados
Retenção em 1 dia, retenção em 7 dias e rodadas.
A barreira interrompe o avanço até o jogador esperar ou realizar uma compra.
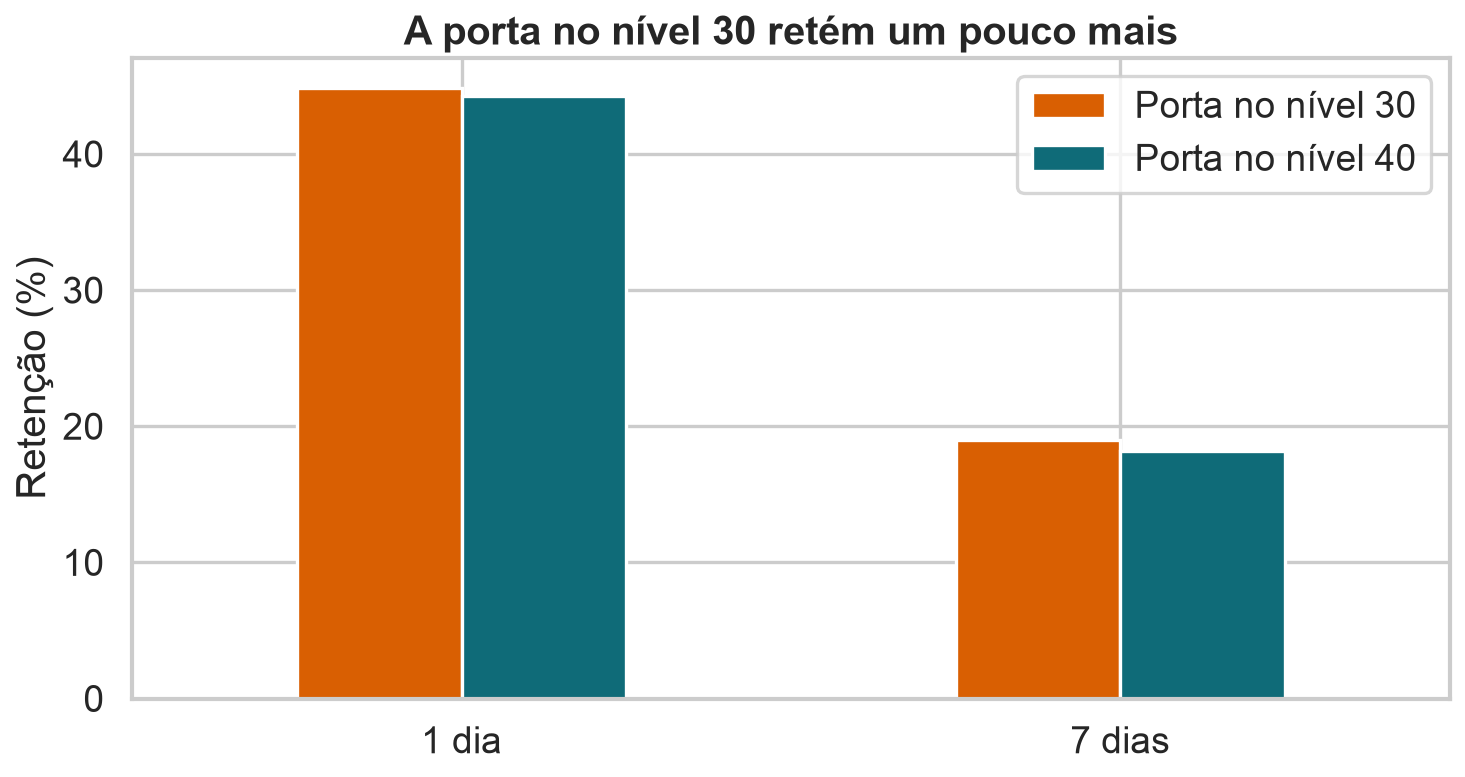
Os grupos têm 44.700 e 45.489 jogadores. As diferenças são pequenas, mas consistentes nas duas medidas de retenção.
Usaremos retenção em 7 dias como métrica primária.
\[ \Delta=p_{30}-p_{40} \]
\[ \widehat\Delta=0{,}1902-0{,}1820=0{,}0082 \]
A porta no nível 30 apresentou retenção 0,82 ponto percentual maior.
Suponha que a equipe tenha randomizado separadamente jogadores de Android e iOS.
Motivo do desenho
As plataformas podem ter taxas de retenção diferentes.
Regra da análise
Se a atribuição ocorreu dentro da plataforma, a permutação também deve ocorrer dentro dela.
Estrato válido
Plataforma, região ou faixa de atividade medida antes da intervenção.
Estrato inadequado
Rodadas ou retenção observadas depois que a versão foi atribuída.
Usar uma variável pós-tratamento pode retirar parte do efeito ou criar uma comparação enviesada.
Em cada plataforma, cinco jogadores receberam cada versão. O valor 1 indica retenção em 7 dias.
| Plataforma | Porta 30 | Porta 40 |
|---|---|---|
| Android | 1, 1, 1, 1, 0 | 1, 0, 0, 0, 0 |
| iOS | 1, 1, 1, 0, 0 | 1, 0, 0, 0, 0 |
O exemplo é pequeno para permitir acompanhar cada etapa do teste.
Android
\[\widehat\Delta_A=0{,}80-0{,}20=0{,}60\]
iOS
\[\widehat\Delta_I=0{,}60-0{,}20=0{,}40\]
As duas plataformas favorecem a porta no nível 30, mas com magnitudes diferentes.
Com \(n_s\) observações no estrato \(s\) e \(n=\sum_s n_s\):
\[ T=\sum_s w_s\widehat\Delta_s, \qquad w_s=\frac{n_s}{n}. \]
Neste exemplo, os estratos têm o mesmo tamanho:
\[ T_{obs}=0{,}5(0{,}60)+0{,}5(0{,}40)=0{,}50. \]
\(T\) é a diferença média entre as versões, ajustada pela composição dos estratos.
\[ H_0:\text{a posição da barreira não altera a retenção}. \]
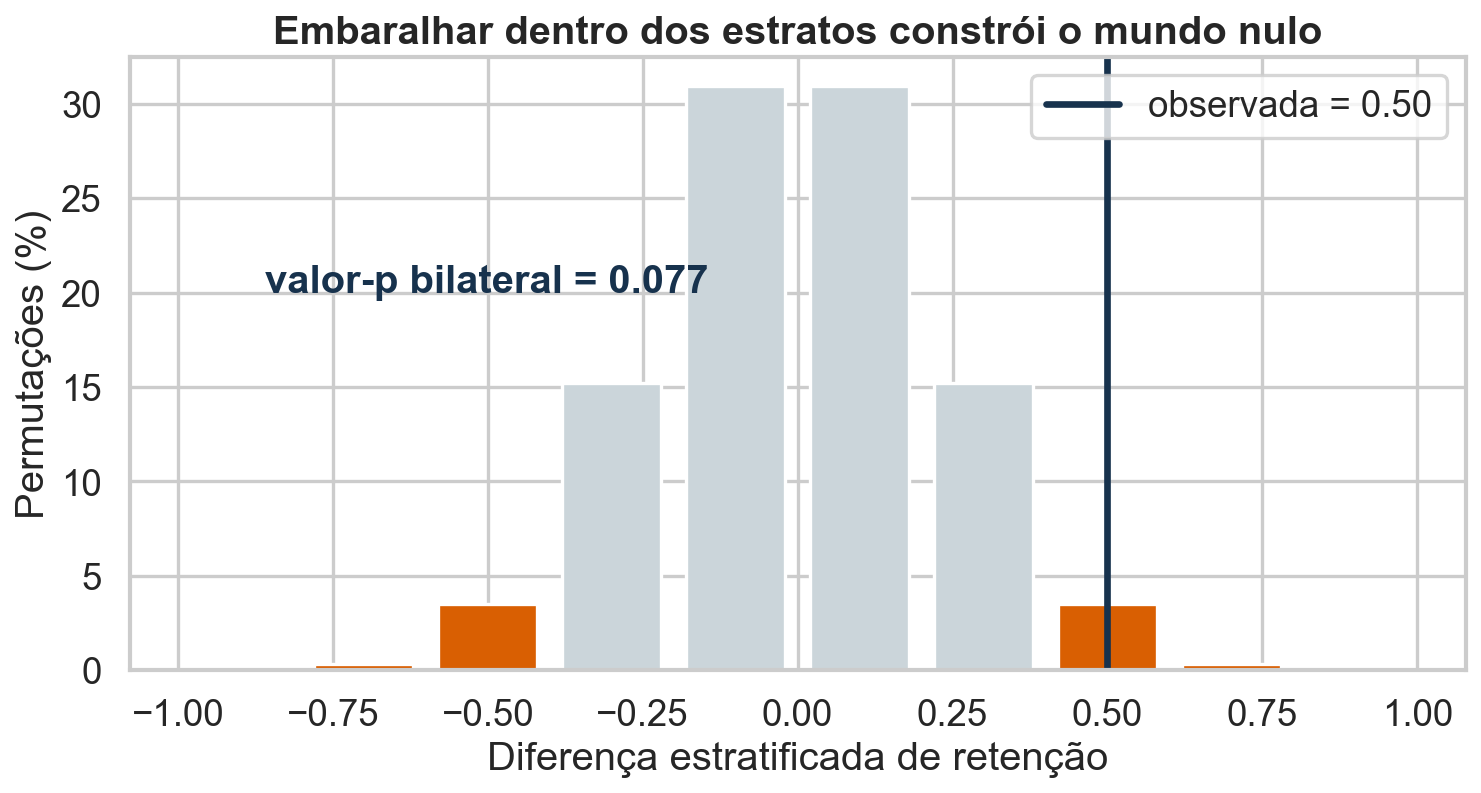
Sob \(H_0\), os rótulos são trocáveis dentro de cada plataforma.
| Plataforma | Porta 30 após troca | Porta 40 após troca | \(\widehat\Delta_s^{(b)}\) |
|---|---|---|---|
| Android | 1, 1, 1, 0, 0 | 1, 1, 0, 0, 0 | 0,20 |
| iOS | 1, 1, 0, 0, 0 | 1, 1, 0, 0, 0 | 0,00 |
\[ T^{(b)}=0{,}5(0{,}20)+0{,}5(0)=0{,}10. \]
Esta permutação produziu uma diferença menor que \(T_{obs}=0{,}50\).
\[ \widehat p=\frac{1+\sum_{b=1}^{B}I(|T^{(b)}|\geq|T_{obs}|)}{B+1}. \]
\(I(\cdot)\) vale 1 quando a condição é verdadeira e 0 caso contrário.
Existem \(\binom{10}{5}^2=63.504\) atribuições possíveis. Cerca de 7,7% são tão extremas quanto a observada.
null = []
for _ in range(B):
deltas = []
for platform, group in data.groupby("platform"):
labels_b = rng.permutation(group["version"])
deltas.append(statistic(group["retention"], labels_b))
null.append(np.average(deltas, weights=stratum_sizes))
p_value = (1 + np.sum(np.abs(null) >= abs(t_obs))) / (B + 1)O efeito observado foi grande, mas a amostra tinha apenas 20 jogadores.
\[ p\approx0{,}077 \]
No nível de 5%, não rejeitamos \(H_0\). Isso não prova ausência de efeito. O experimento fornece evidência insuficiente para uma decisão tão rigorosa.
Estratificar preserva o desenho. Não substitui uma amostra adequada.
O experimento atribuiu versões separadamente em Android e iOS. Qual procedimento representa corretamente \(H_0\)?
Cookie Cats oferece três perguntas naturais:
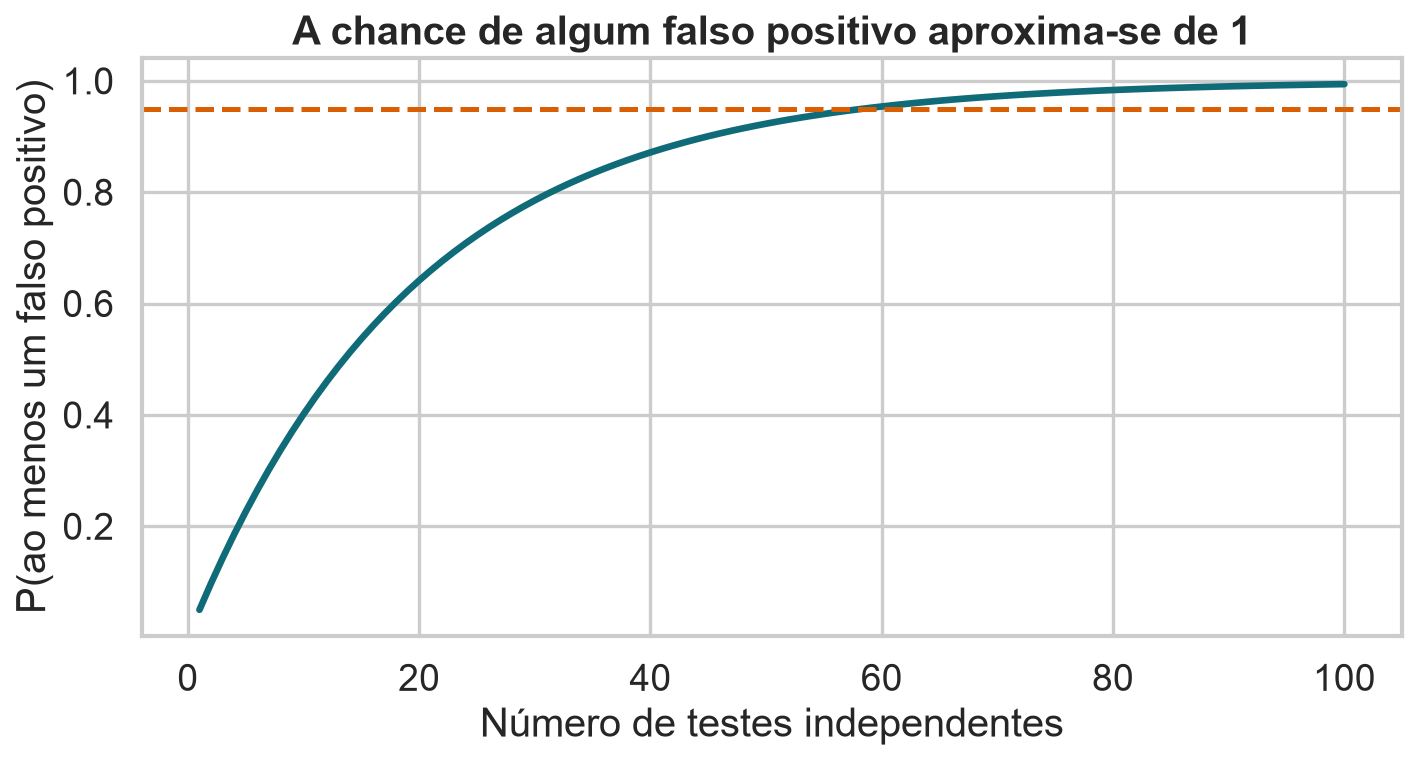
Cada teste cria uma nova oportunidade de encontrar um resultado pequeno por acaso.
Com testes independentes no nível 5%, a chance de pelo menos um falso positivo é \(1-(1-0{,}05)^m\): 14,3% com 3 testes e 40,1% com 10.
FWER
Family-wise error rate (taxa de erro familiar)
Chance de cometer ao menos um falso positivo na família.
Adequada quando uma conclusão falsa tem custo alto.
FDR
False discovery rate (taxa de falsas descobertas)
Fração falsa esperada entre as descobertas anunciadas.
Adequada quando buscamos muitas descobertas.
As duas metas respondem a perguntas diferentes.
Considere os valores-p ordenados
\[ 0{,}003,\ 0{,}011,\ 0{,}018,\ 0{,}041,\ 0{,}200. \]
Cálculo do limiar
\[ \alpha^*=\frac{\alpha}{m} =\frac{0{,}05}{5}=0{,}01 \]
Comparação
\(0{,}003\leq0{,}01\), mas os outros valores-p são maiores que \(0{,}01\).
Rejeite apenas \(H_{(1)}\).
Bonferroni controla FWER, mas aplica o mesmo limiar rígido a todos os testes.
Holm compara \(p_{(i)}\) com \(\alpha/(m-i+1)\) e para no primeiro fracasso.
| \(i\) | \(p_{(i)}\) | limiar | decisão |
|---|---|---|---|
| 1 | 0,003 | \(0{,}05/5=0{,}0100\) | rejeita e continua |
| 2 | 0,011 | \(0{,}05/4=0{,}0125\) | rejeita e continua |
| 3 | 0,018 | \(0{,}05/3=0{,}0167\) | não rejeita e para |
Logo, Holm rejeita \(H_{(1)}\) e \(H_{(2)}\). As demais hipóteses não são rejeitadas.
BH compara cada \(p_{(i)}\) com \((i/m)q\). Aqui, \(m=5\) e \(q=0{,}05\).
| \(i\) | \(p_{(i)}\) | \((i/5)0{,}05\) | satisfaz? |
|---|---|---|---|
| 1 | 0,003 | 0,010 | sim |
| 2 | 0,011 | 0,020 | sim |
| 3 | 0,018 | 0,030 | sim |
| 4 | 0,041 | 0,040 | não |
| 5 | 0,200 | 0,050 | não |
O maior índice aprovado é \(k=3\). Portanto, BH rejeita \(H_{(1)},H_{(2)}\) e \(H_{(3)}\).
\(i\) é a posição, \(p_{(i)}\) é o valor-p ordenado, \(m\) é o número de testes, \(q\) é a FDR-alvo e \(k\) é a última posição aprovada.
Para \(m=5\) e \(\alpha=q=0{,}05\):
| valor-p | Bonferroni | Holm | BH |
|---|---|---|---|
| 0,003 | rejeita | rejeita | rejeita |
| 0,011 | não | rejeita | rejeita |
| 0,018 | não | não | rejeita |
| 0,041 | não | não | não |
| 0,200 | não | não | não |
Bonferroni rejeita uma hipótese, Holm rejeita duas e BH rejeita três. A diferença vem da meta de controle.
Poucas decisões confirmatórias
Use Holm. Bonferroni pode servir como regra simples.
Muitas hipóteses exploratórias
Use BH quando aceitar algumas descobertas falsas for razoável.
Uma decisão principal
Defina uma métrica primária antes de observar os resultados.
Um plano para Cookie Cats poderia definir:
Não corrigimos uma hipótese realmente definida como única antes do estudo. As análises adicionais devem ser identificadas como secundárias ou exploratórias.
Se a diferença verdadeira for relevante, qual é a chance de o teste rejeitar \(H_0\)?
\[ \operatorname{Poder}(\Delta^*) =P(\text{rejeitar }H_0\mid\Delta=\Delta^*). \]
O poder sempre se refere a uma alternativa específica \(\Delta^*\).
Usaremos como cenário didático o efeito observado:
\[ \Delta^*=0{,}82\text{ p.p.} \]
Isso não afirma que o efeito verdadeiro seja exatamente 0,82 p.p. O valor apenas define o mundo alternativo usado na simulação.
Os tamanhos dos grupos continuam 44.700 e 45.489 jogadores.
Sob ausência de efeito, embaralhamos gate_30 e gate_40 e recalculamos \(\widehat\Delta\).
A distribuição de \(|\widehat\Delta|\) fornece o limite crítico bilateral de 5%:
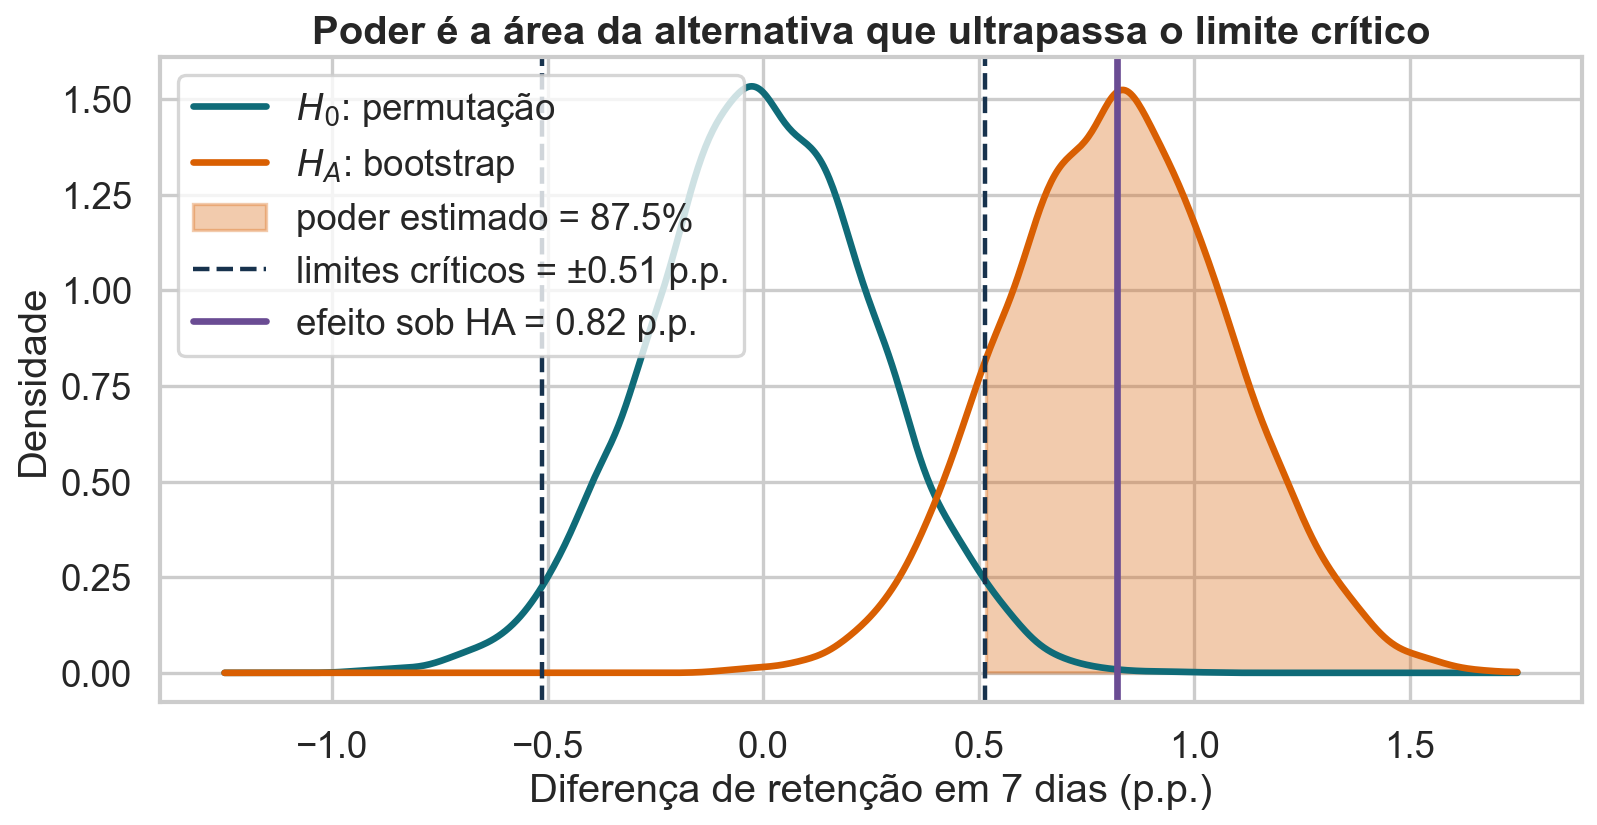
\[ c=Q_{0{,}95}(|\widehat\Delta^{perm}|)\approx0{,}51\text{ p.p.} \]
Rejeitamos \(H_0\) quando \(|\widehat\Delta|\geq c\).
Reamostramos jogadores separadamente em cada versão.
Esse bootstrap preserva as taxas observadas e produz uma distribuição centrada perto de
\[ \Delta^*=0{,}82\text{ p.p.} \]
Cada réplica representa um novo experimento possível quando essa alternativa é verdadeira.
\[ \widehat{\operatorname{Poder}} =\frac{1}{B}\sum_{b=1}^{B} I(|\widehat\Delta^{(b)}_{HA}|\geq c). \]
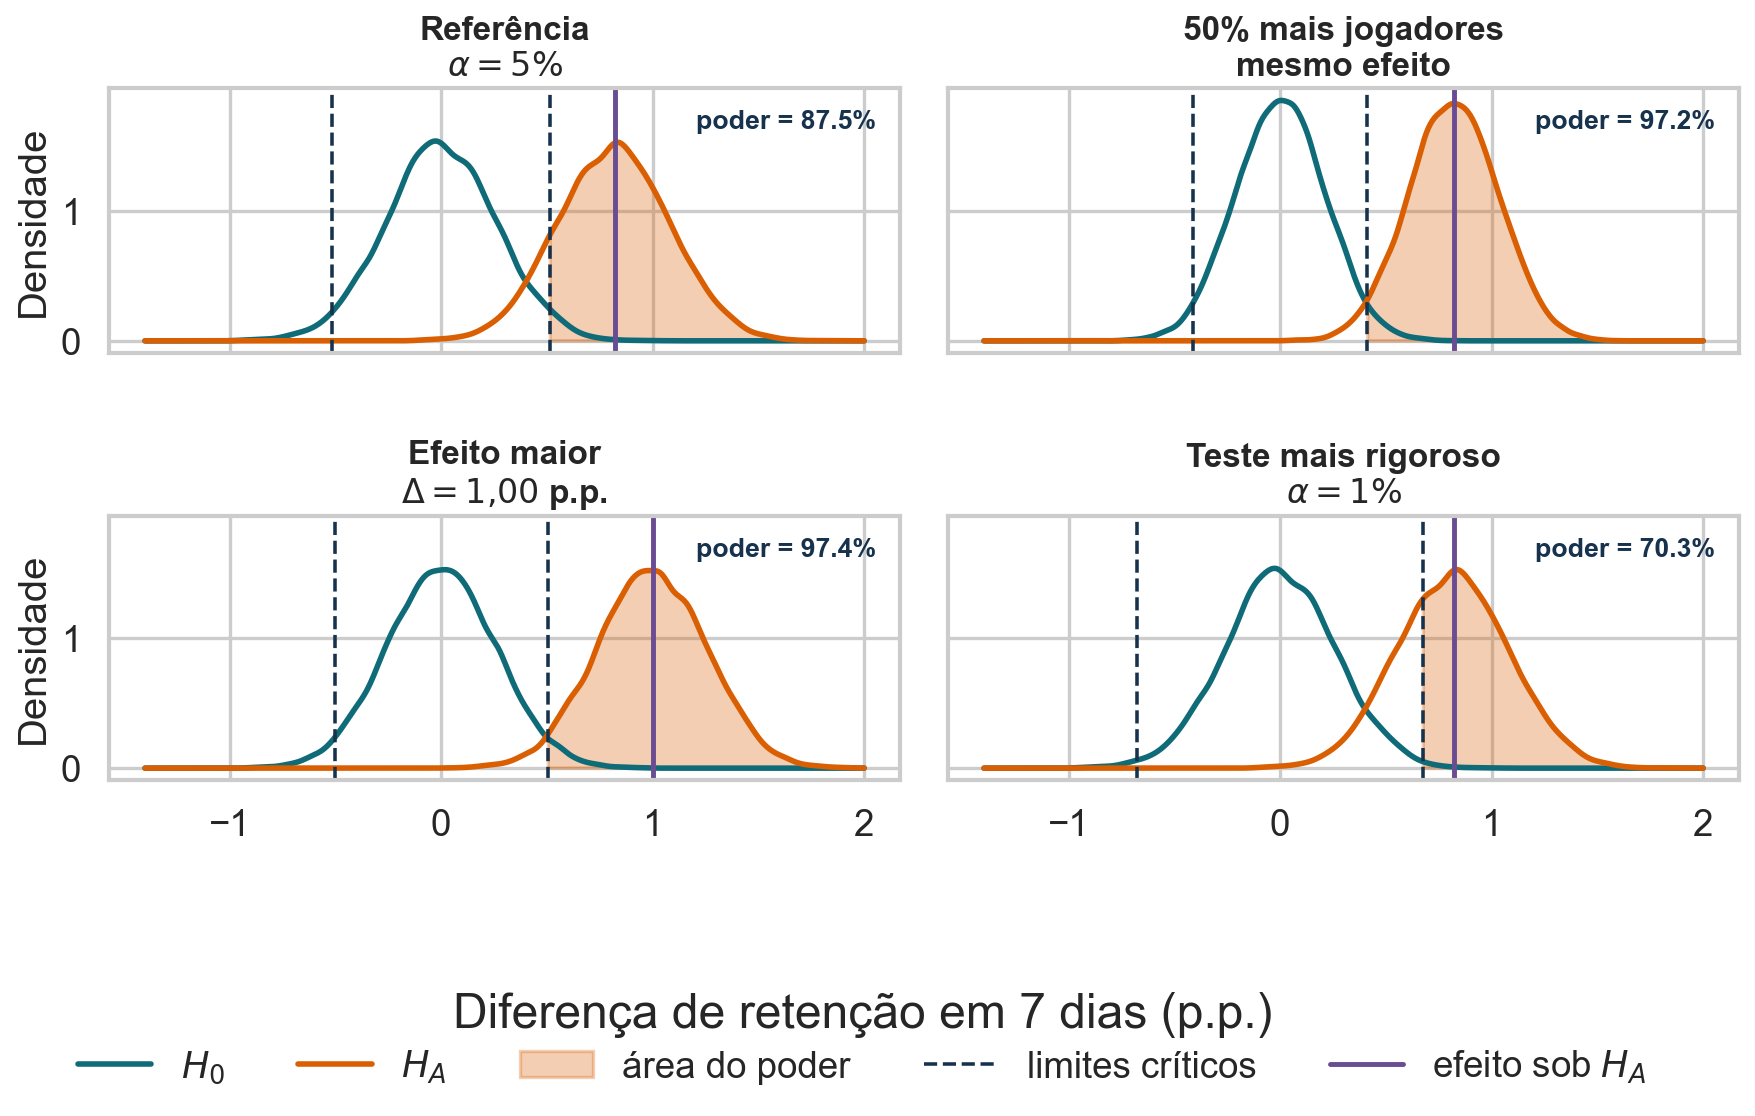
A área laranja além dos limites críticos representa experimentos que rejeitariam \(H_0\). Neste cenário, o poder estimado é aproximadamente 88%.
Curva azul
Variação esperada sem efeito, construída por permutação.
Curva laranja
Variação sob o efeito escolhido, construída por bootstrap.
Área sombreada
Probabilidade de a alternativa ultrapassar o limite do teste.
A linha roxa marca o efeito de 0,82 p.p. usado para definir \(H_A\).
Na mesma escala, aumentar a amostra ou o efeito eleva o poder de cerca de 88% para aproximadamente 97%. Reduzir \(\alpha\) de 5% para 1% afasta os limites críticos e reduz o poder para cerca de 70%.
def simulate_difference(n_a, n_b, p_a, p_b, reps=20_000):
return (
rng.binomial(n_a, p_a, reps) / n_a
- rng.binomial(n_b, p_b, reps) / n_b
)
pooled = (y30.sum() + y40.sum()) / (n30 + n40)
large_null = simulate_difference(
round(1.5*n30), round(1.5*n40), pooled, pooled
)
large_alt = simulate_difference(
round(1.5*n30), round(1.5*n40), y30.mean(), y40.mean()
)
effect_alt = simulate_difference(
n30, n40, y40.mean() + .010, y40.mean()
)
scenarios = [
(null_perm, boot_alt, critical, observed, "Referência"),
(large_null, large_alt,
np.quantile(np.abs(large_null), .95), observed,
"50% mais jogadores"),
(null_perm, effect_alt, critical, .010, "Efeito maior"),
(null_perm, boot_alt,
np.quantile(np.abs(null_perm), .99), observed,
"Teste mais rigoroso"),
]
fig, axes = plt.subplots(2, 2, sharex=True, sharey=True)
for ax, (null, alt, cutoff, effect, title) in zip(
axes.flat, scenarios
):
grid = np.linspace(-1.4, 2.0, 700)
density_h0 = gaussian_kde(100 * null)(grid)
density_ha = gaussian_kde(100 * alt)(grid)
rejection = np.abs(grid) >= 100 * cutoff
power = np.mean(np.abs(alt) >= cutoff)
ax.plot(grid, density_h0, label="$H_0$")
ax.plot(grid, density_ha, label="$H_A$")
ax.fill_between(
grid, 0, density_ha, where=rejection, alpha=.30
)
ax.axvline(-100 * cutoff, linestyle="--")
ax.axvline(100 * cutoff, linestyle="--")
ax.axvline(100 * effect, color="#6a4c93")
ax.set_title(f"{title}\npoder = {power:.1%}")
plt.show()| Efeito estimado | Valor-p | IC bootstrap de 95% | Poder |
|---|---|---|---|
| +0,82 p.p. | 0,002 | +0,31 a +1,33 p.p. | aproximadamente 88% |
Os dados favorecem a porta no nível 30 para retenção em 7 dias. A decisão de produto ainda depende da relevância prática, da receita e dos custos da mudança.
No cenário simulado com efeito de 0,82 p.p., qual interpretação está correta?
Um teste bem planejado respeita o desenho, declara quantas perguntas fará e verifica quais efeitos consegue detectar.
ICD: Aula 15 — Poder e múltiplos testesvoltar para a Aula