Aula 17 — Módulo 3: Modelagem e Aprendizado de Máquina
Na Aula 16, a correlação resumiu quanto duas variáveis variam juntas.
Agora queremos uma função que responda:
Para uma pessoa com idade \(x\), qual despesa média o modelo prevê?
A regressão transforma associação em uma regra explícita de previsão — ainda sem afirmar causalidade.
Não usaremos projeções, máxima verossimilhança ou gradiente descendente nesta aula.
Continuaremos com Medical Insurance Cost, disponível no Kaggle sob licença CC0.
charges;age;Fonte: Kaggle, mosapabdelghany/medical-insurance-cost-dataset.
Cada linha representa uma pessoa segurada.
| papel nesta aula | coluna | significado |
|---|---|---|
| resposta \(Y\) | charges |
despesas médicas cobradas em US$ |
| preditor \(X\) | age |
idade em anos |
| diagnóstico de grupo | smoker |
fumante ou não fumante |
| outras variáveis | bmi, children, sex, region |
características não incluídas no modelo simples |
O que fica fora do modelo reaparece nos resíduos.
Mínimos quadrados não corrige problemas de coleta, seleção ou mensuração.
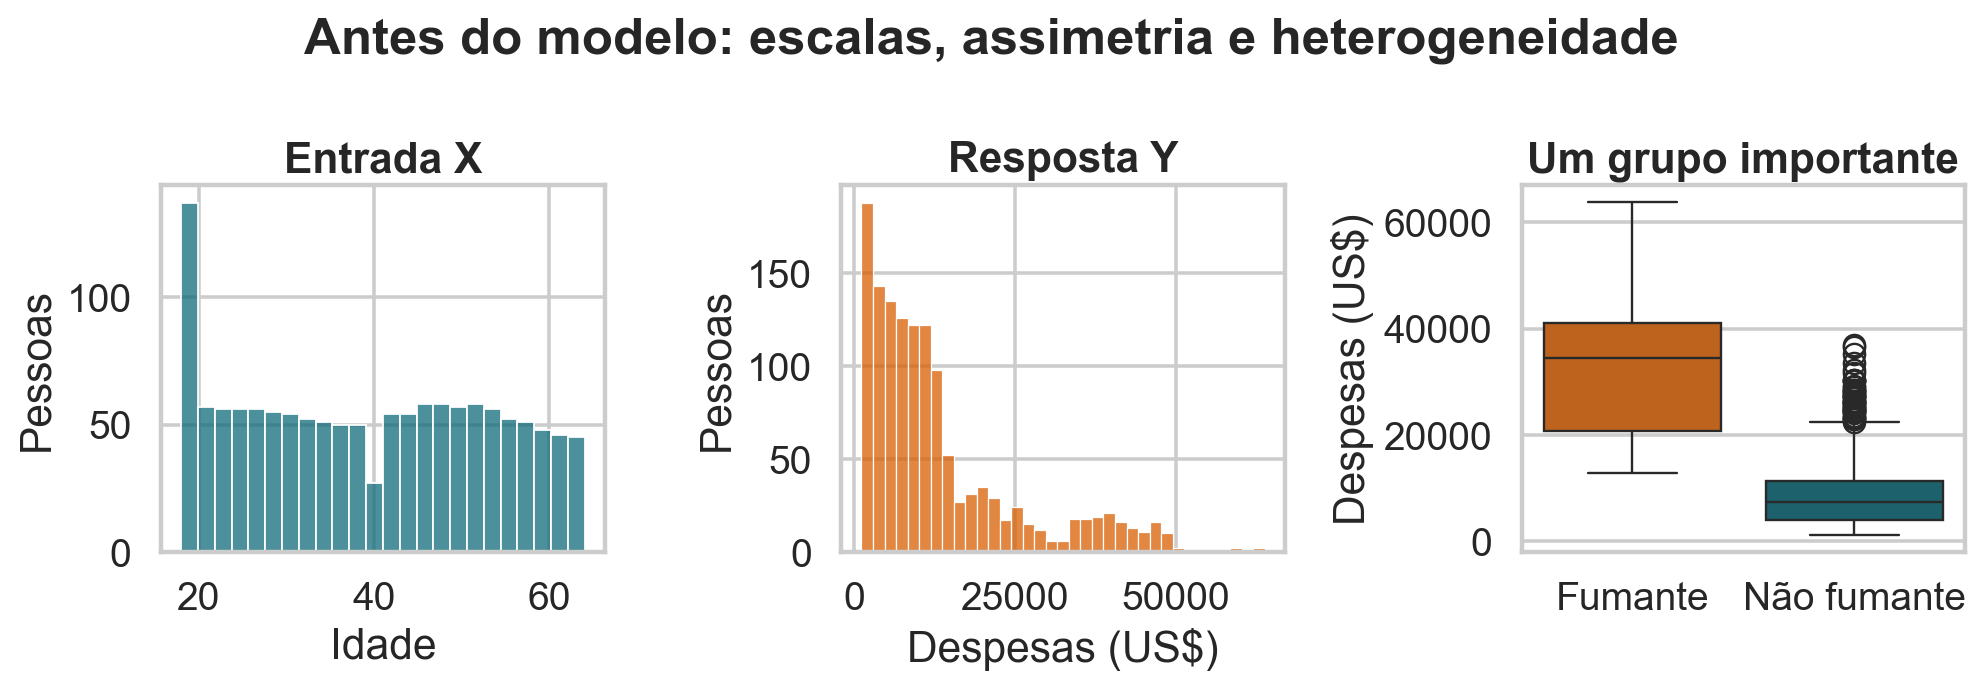
Uma reta global terá de resumir uma resposta assimétrica e dois grupos em patamares diferentes.
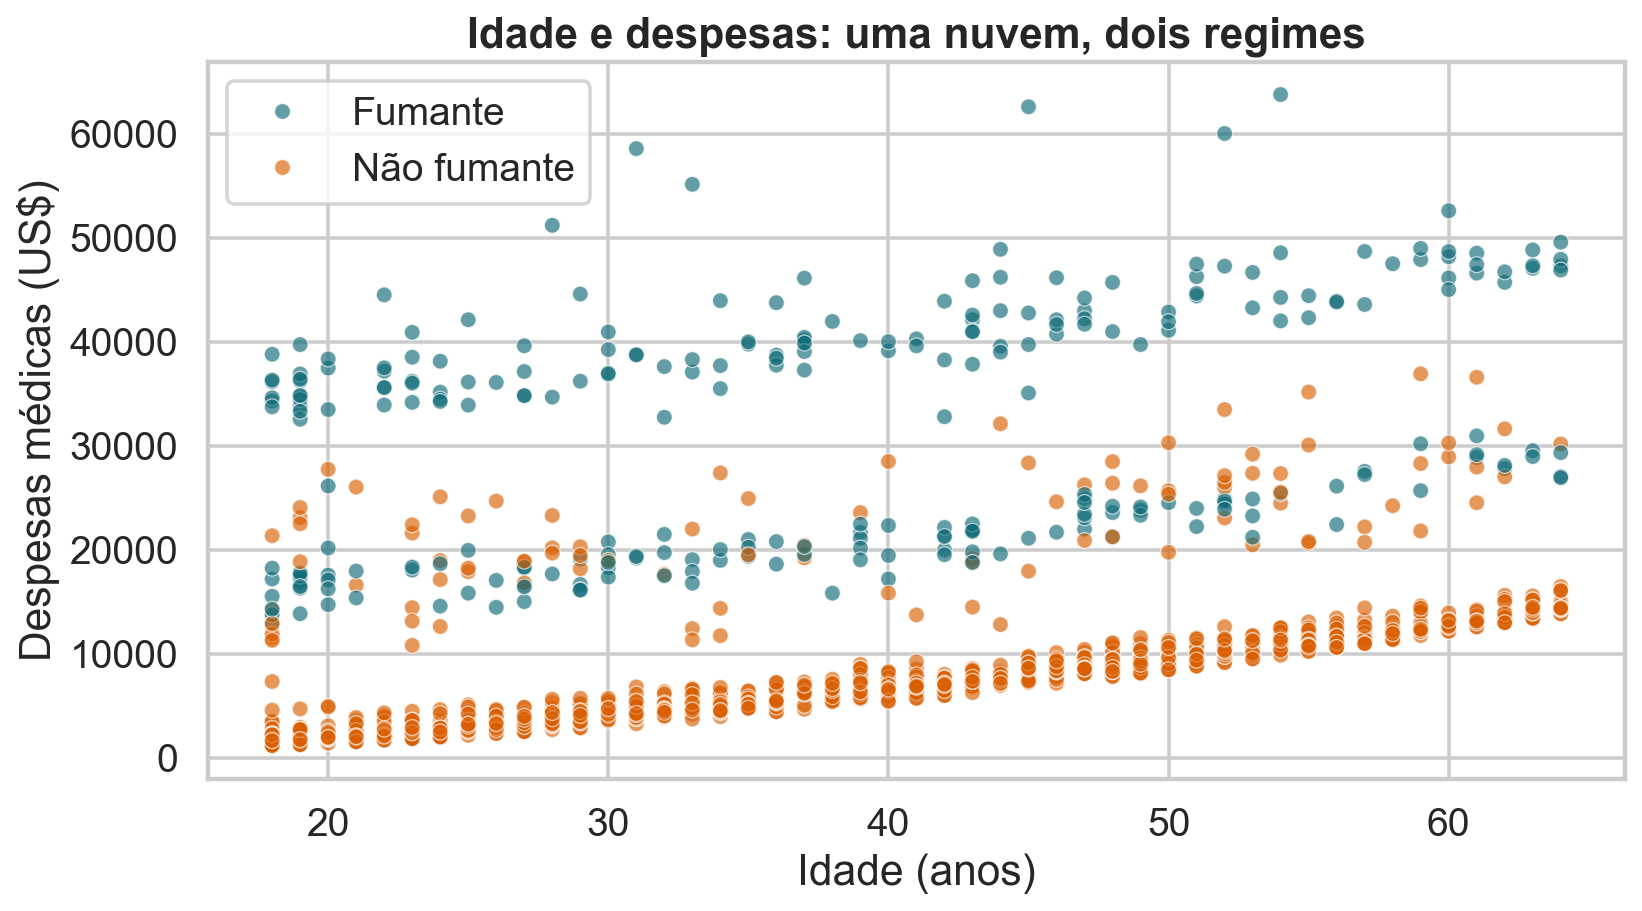
A idade está positivamente associada às despesas, mas fumantes e não fumantes formam regimes distintos. Começaremos deliberadamente com um modelo simples.
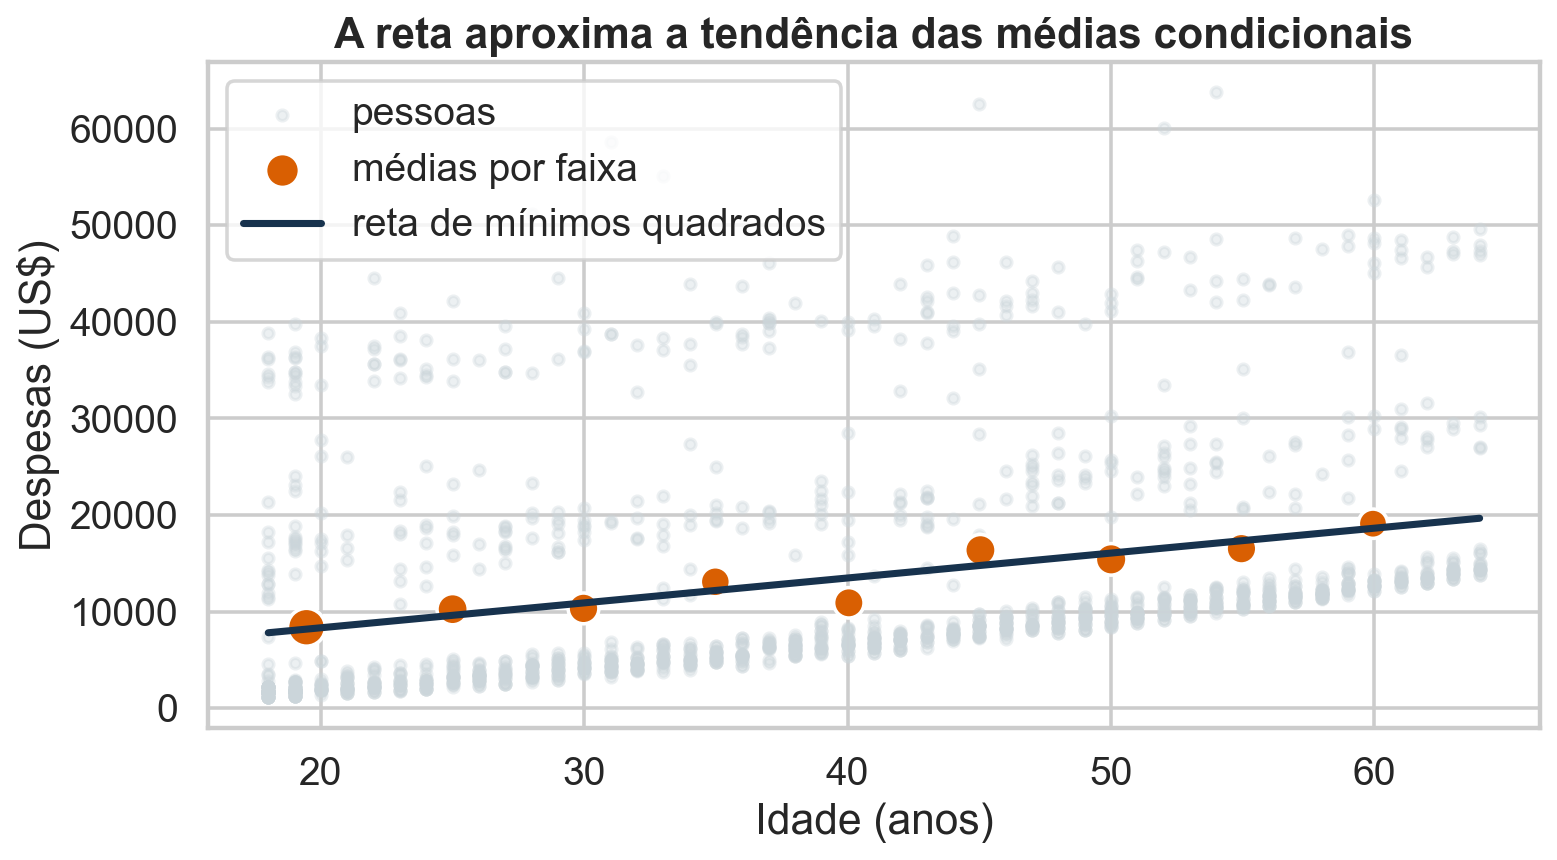
As médias em pequenas faixas aproximam \(E[Y\mid X=x]\). A reta impõe uma estrutura suave e parcimoniosa para essa tendência.
Para cada valor \(x\), a quantidade
\[ m(x)=E[Y\mid X=x] \]
é a média da distribuição de \(Y\) entre unidades com \(X=x\).
A regressão linear simples supõe que essa função pode ser aproximada por uma reta:
\[ m(x)=\beta_0+\beta_1x. \]
Para a observação \(i\):
\[ Y_i=\beta_0+\beta_1x_i+\varepsilon_i, \qquad E[\varepsilon_i\mid X_i=x_i]=0. \]
Equivalentemente:
\[ E[Y_i\mid X_i=x_i]=\beta_0+\beta_1x_i. \]
O modelo é sobre a média da resposta, não sobre uma igualdade exata para cada pessoa.
| símbolo | significado |
|---|---|
| \(Y_i\) | resposta aleatória da observação \(i\) |
| \(x_i\) | valor observado do preditor |
| \(\beta_0\) | intercepto populacional |
| \(\beta_1\) | inclinação populacional |
| \(\varepsilon_i\) | desvio aleatório em torno da média condicional |
| \(E[\varepsilon_i\mid X_i=x_i]=0\) | o modelo não erra sistematicamente em cada valor de \(X\) |
Os parâmetros \(\beta_0\) e \(\beta_1\) são desconhecidos.
\(\varepsilon_i\) representa tudo que faz \(Y_i\) diferir da média condicional:
Ele não significa necessariamente que os dados foram medidos incorretamente.
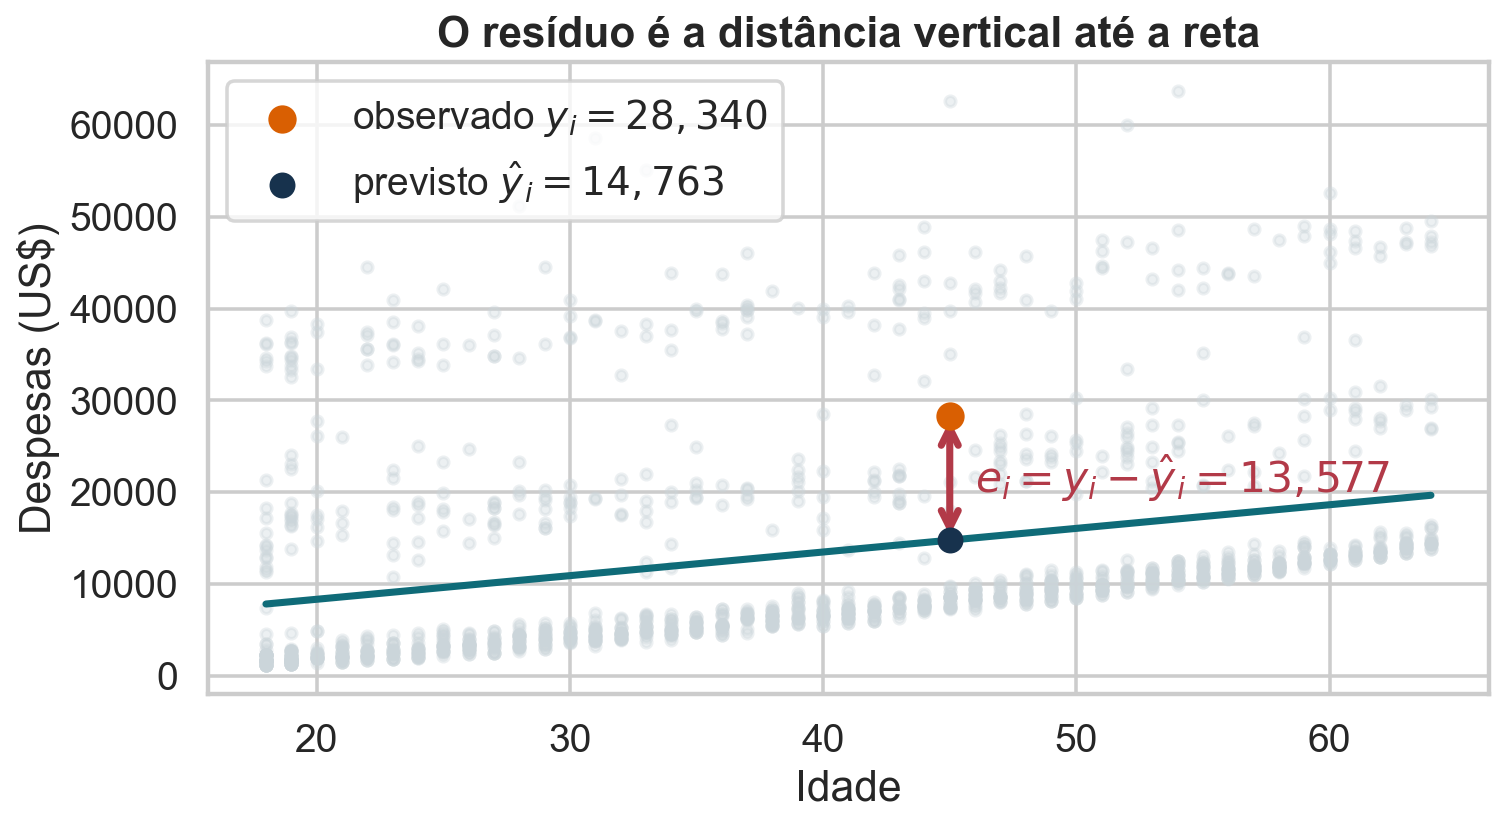
Depois do ajuste, observamos resíduos \(e_i\), não os erros populacionais \(\varepsilon_i\).
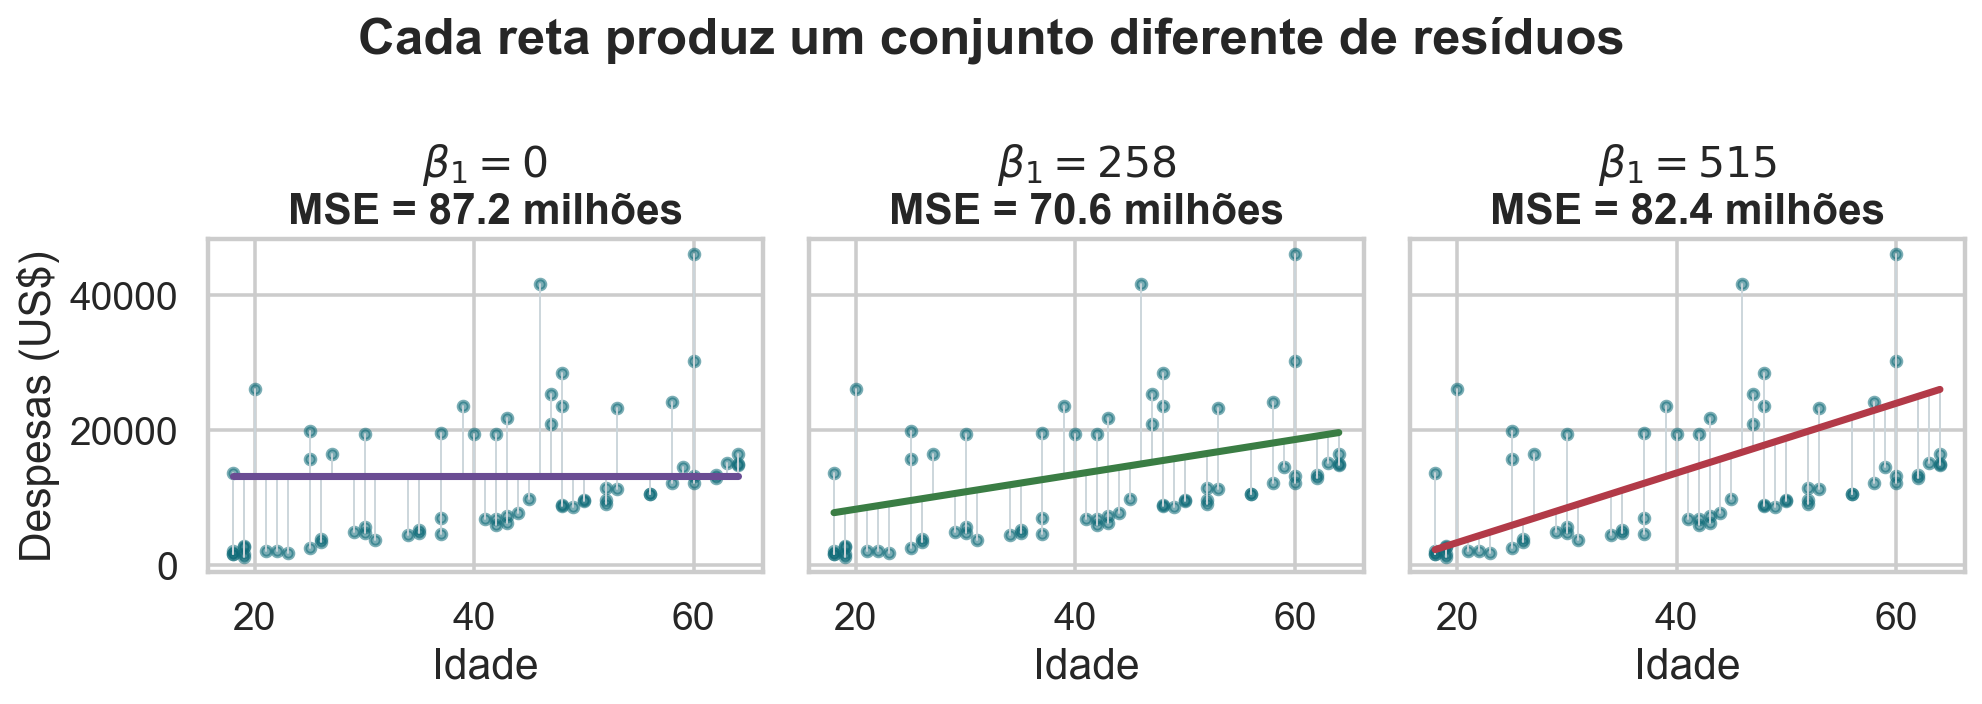
Para candidatos \(b_0\) e \(b_1\):
\[ \widehat y_i=b_0+b_1x_i. \]
\[ e_i=y_i-\widehat y_i=y_i-b_0-b_1x_i. \]
A soma dos erros ao quadrado é
\[ \operatorname{SSE}(b_0,b_1) =\sum_{i=1}^{n}(y_i-b_0-b_1x_i)^2. \]
O erro quadrático médio é
\[ \operatorname{MSE}(b_0,b_1)=\frac1n\operatorname{SSE}(b_0,b_1). \]
Ambos têm o mesmo minimizador; dividir por \(n\) apenas muda a escala da perda.
O quadrado também aumenta a influência de valores extremos: não é uma escolha neutra.
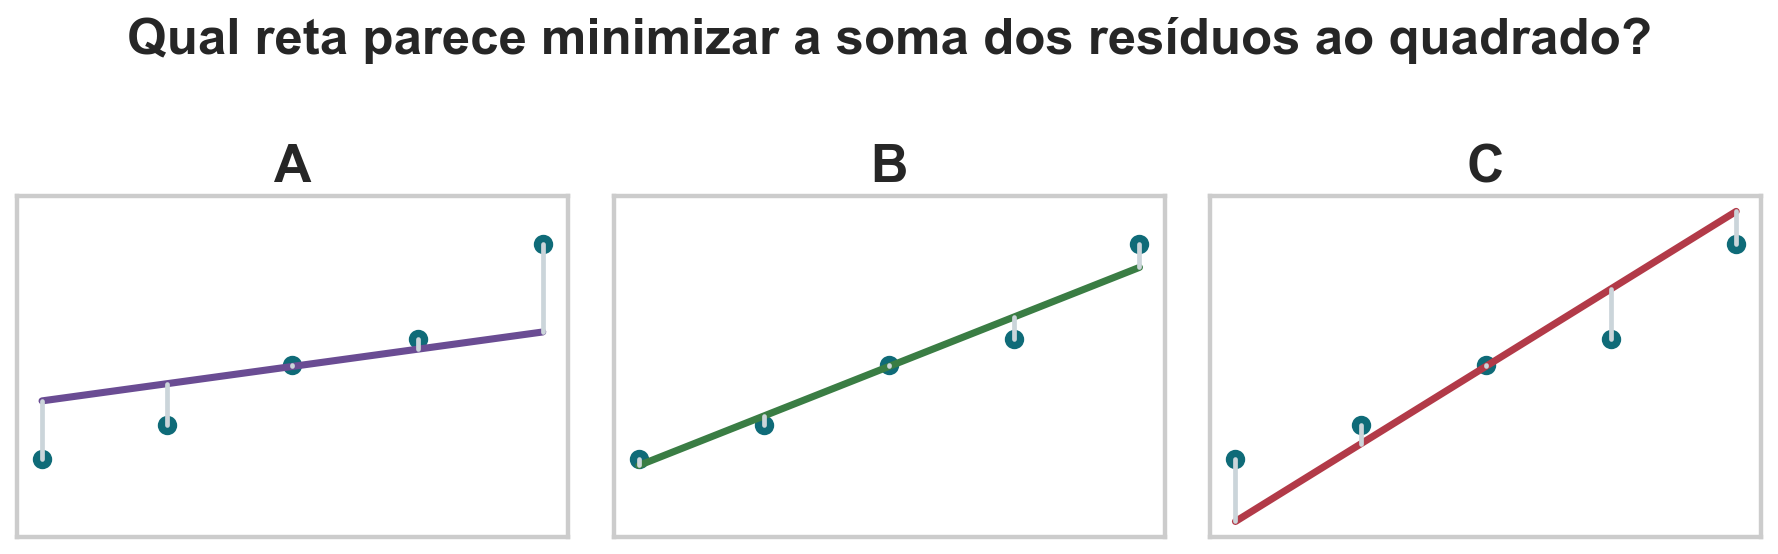
Qual reta parece minimizar a soma dos resíduos ao quadrado?
Definimos as estimativas por
\[ (\widehat\beta_0,\widehat\beta_1) =\arg\min_{b_0,b_1} \sum_{i=1}^{n}(y_i-b_0-b_1x_i)^2. \]
arg min devolve os valores dos argumentos que minimizam a função;Resolveremos o problema diretamente por cálculo.
\[ \frac{\partial\operatorname{SSE}}{\partial b_0} =\sum_{i=1}^n 2(y_i-b_0-b_1x_i)(-1). \]
Igualando a zero:
\[ \sum_i(y_i-b_0-b_1x_i)=0. \]
Portanto, no mínimo, a soma dos resíduos é zero.
Desenvolvendo a igualdade:
\[ \sum_i y_i-nb_0-b_1\sum_i x_i=0. \]
Dividindo por \(n\):
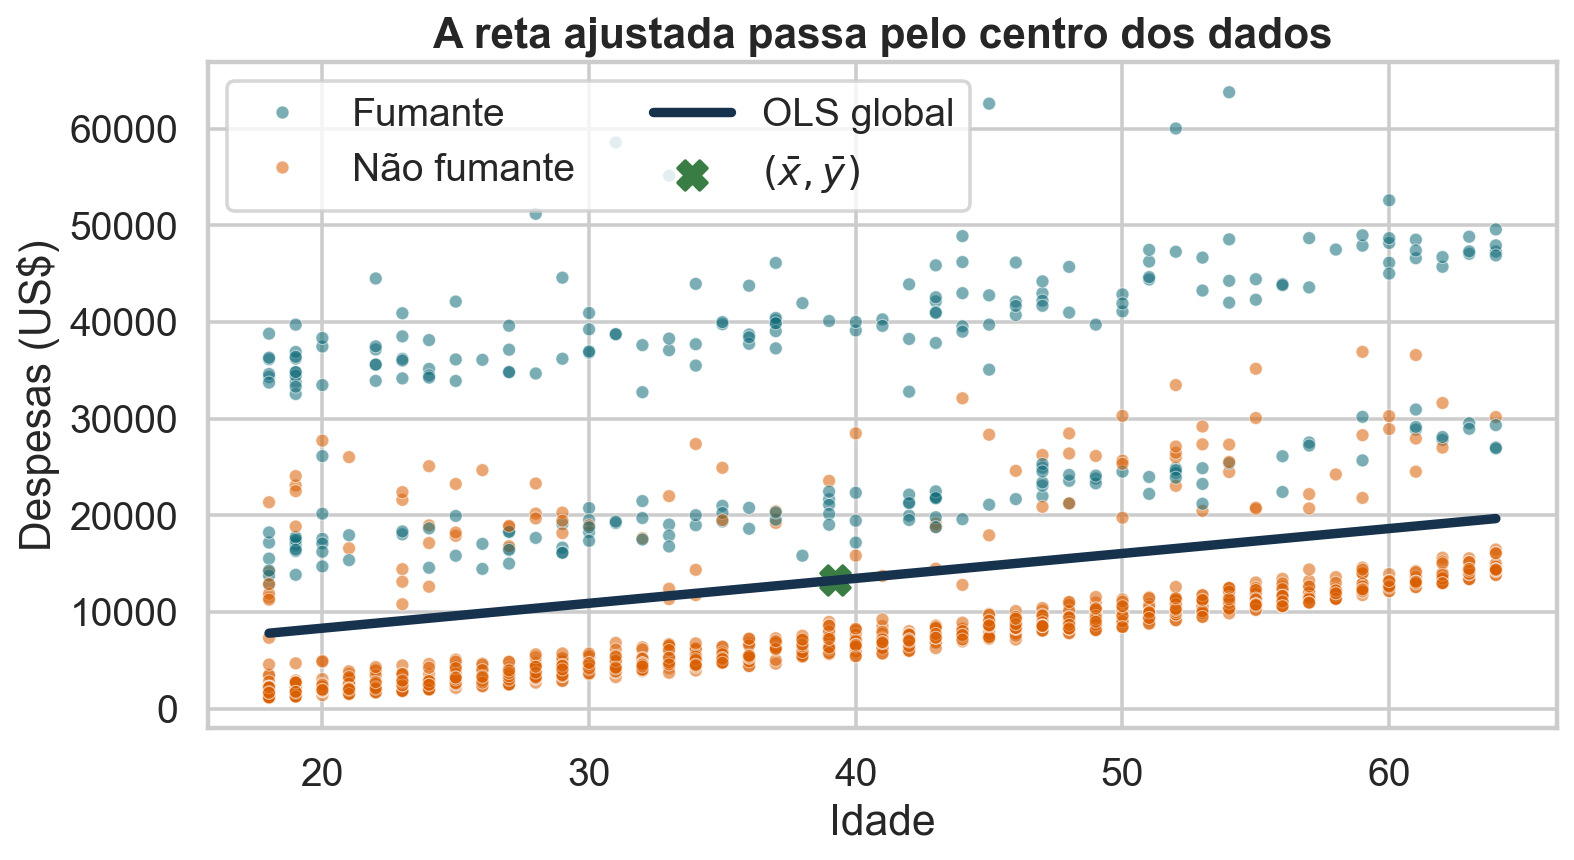
\[ \bar y-b_0-b_1\bar x=0 \quad\Longrightarrow\quad b_0=\bar y-b_1\bar x. \]
Toda reta candidata após otimizar o intercepto passa por \((\bar x,\bar y)\).
Substitua \(b_0=\bar y-b_1\bar x\) no resíduo:
\[ y_i-b_0-b_1x_i =(y_i-\bar y)-b_1(x_i-\bar x). \]
Definindo \(x_i^c=x_i-\bar x\) e \(y_i^c=y_i-\bar y\):
\[ \operatorname{SSE}(b_1)=\sum_i(y_i^c-b_1x_i^c)^2. \]
Centralizar não altera a inclinação; apenas incorpora o intercepto.
\[ \frac{d\operatorname{SSE}}{db_1} =-2\sum_i x_i^c(y_i^c-b_1x_i^c). \]
Igualando a zero:
\[ \sum_i x_i^cy_i^c =b_1\sum_i(x_i^c)^2. \]
A segunda derivada é \(2\sum_i(x_i^c)^2>0\) quando há variação em \(X\), confirmando o mínimo único.
\[ \widehat\beta_1 =\frac{\sum_i(x_i-\bar x)(y_i-\bar y)} {\sum_i(x_i-\bar x)^2}, \qquad \widehat\beta_0=\bar y-\widehat\beta_1\bar x. \]
A solução exige \(\sum_i(x_i-\bar x)^2>0\): se todos os \(x_i\) forem iguais, não há inclinação identificável.
Divida numerador e denominador por \(n-1\):
\[ \widehat\beta_1 =\frac{s_{XY}}{s_X^2} =\frac{\operatorname{Cov}(X,Y)}{\operatorname{Var}(X)}. \]
[unidade de Y]/[unidade de X].Como
\[ r=\frac{s_{XY}}{s_Xs_Y}, \]
temos
\[ \widehat\beta_1=r\frac{s_Y}{s_X}. \]
Correlação fornece sinal e força padronizada; a razão \(s_Y/s_X\) devolve as unidades necessárias à inclinação.
Se
\[ Z_X=\frac{X-\bar X}{s_X}, \qquad Z_Y=\frac{Y-\bar Y}{s_Y}, \]
então ambos têm média zero e desvio-padrão um. A regressão de \(Z_Y\) em \(Z_X\) possui:
\[ \widehat\beta_0=0, \qquad \widehat\beta_1=r. \]
Isso vale para regressão linear simples com intercepto.
Para despesas em função da idade:
\[ \widehat{\text{despesa}} =3165{,}89+257{,}72\times\text{idade}. \]
| quantidade | valor |
|---|---|
| intercepto | US$ 3.165,89 |
| inclinação | US$ 257,72 por ano |
| \(R^2\) | 0,089 |
| RMSE | US$ 11.551,67 |
É a previsão quando idade \(=0\), fora da faixa observada de 18 a 64 anos. Ele posiciona a reta, mas não possui interpretação substantiva confiável aqui.
Dentro do modelo, acrescentar um ano à idade está associado a um aumento médio previsto de aproximadamente US$ 258 nas despesas.
Não é um efeito causal: tabagismo e outras variáveis não foram controlados.
Para uma pessoa de 40 anos:
\[ \widehat y=3165{,}89+257{,}72\times40 \approx 13\,475. \]
O resultado está em dólares (US$). Essa é uma estimativa da despesa média condicional segundo o modelo. Uma pessoa específica pode ficar muito distante desse valor.
O resíduo observado será \(e_i=y_i-13.475\).
Intervalos de previsão individuais são mais largos que intervalos para a média, pois incluem a dispersão de \(\varepsilon\).
Nesta aula, o bootstrap quantificará a incerteza dos coeficientes; a formulação paramétrica virá com a visão probabilística.
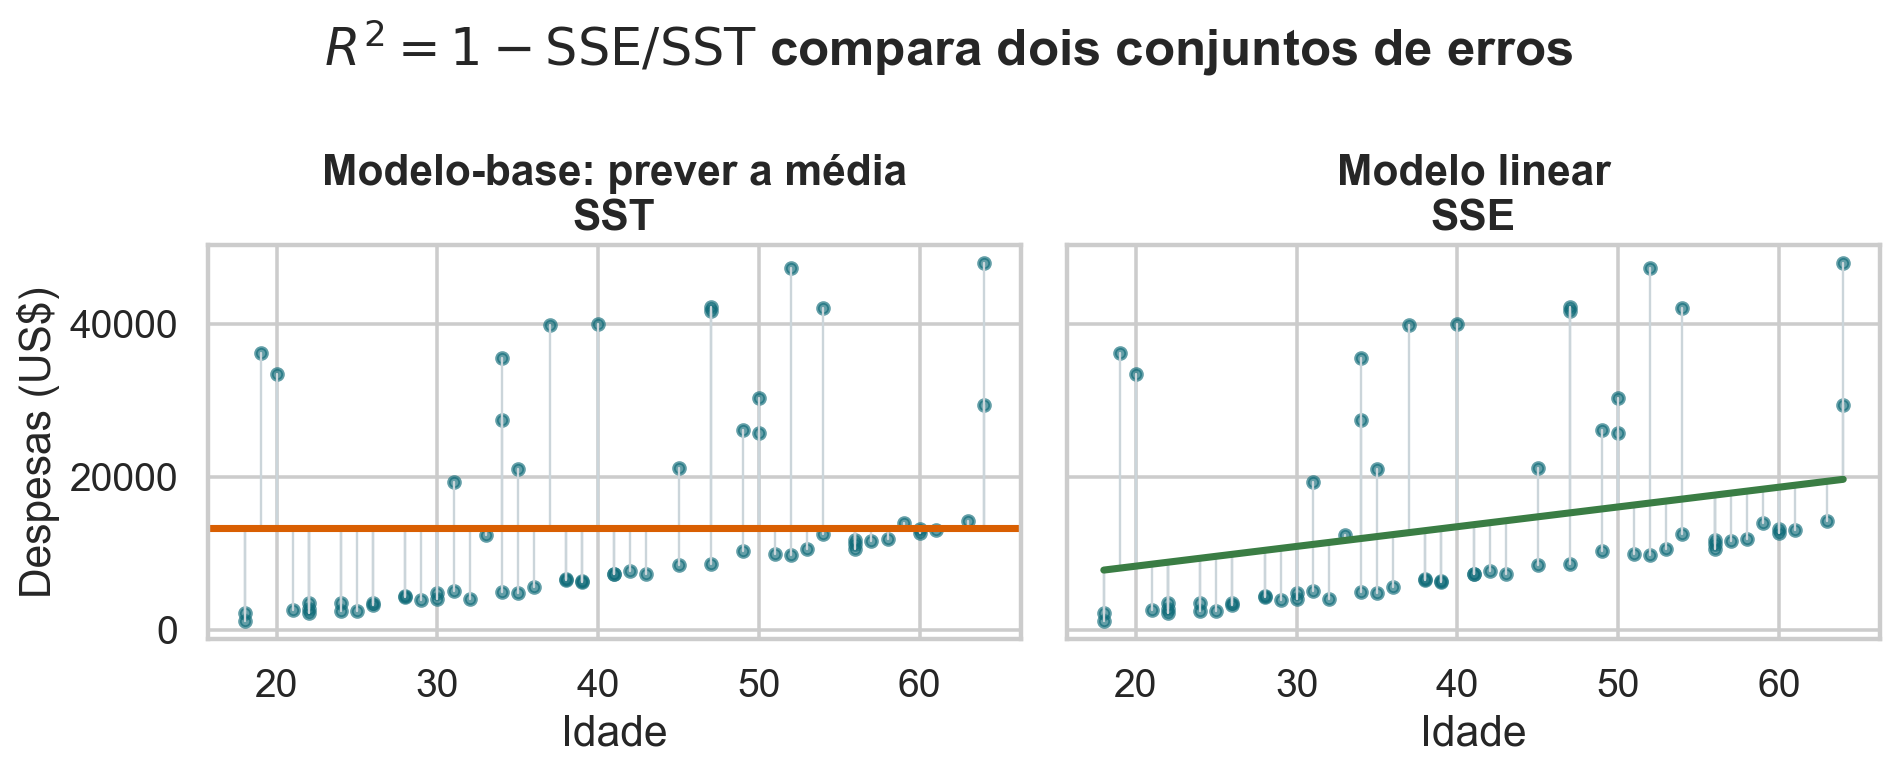
O modelo-base ignora \(X\) e prevê \(\bar y\) para todos:
\[ \operatorname{SST}=\sum_i(y_i-\bar y)^2. \]
O modelo ajustado deixa resíduos:
\[ \operatorname{SSE}=\sum_i(y_i-\widehat y_i)^2. \]
\(R^2\) compara quanto erro quadrático restou após usar a reta.
\[ R^2=1-\frac{\operatorname{SSE}}{\operatorname{SST}}. \]
Na regressão OLS com intercepto:
\[ \operatorname{SST}=\operatorname{SSR}+\operatorname{SSE}, \]
em que SSR é a soma de quadrados explicada pela regressão.
Com um preditor e intercepto:
\[ R^2=r_{XY}^2. \]
Na base:
\[ r_{\text{idade,despesa}}=0{,}299 \quad\Longrightarrow\quad R^2=0{,}299^2\approx0{,}089. \]
A idade captura cerca de 8,9% da variabilidade amostral das despesas sob o critério quadrático.
Um \(R^2\) alto não garante:
Um \(R^2\) baixo pode coexistir com uma associação real e cientificamente relevante.
Depois do ajuste, procure nos resíduos:
Resíduos deveriam parecer estrutura sem padrão sistemático.
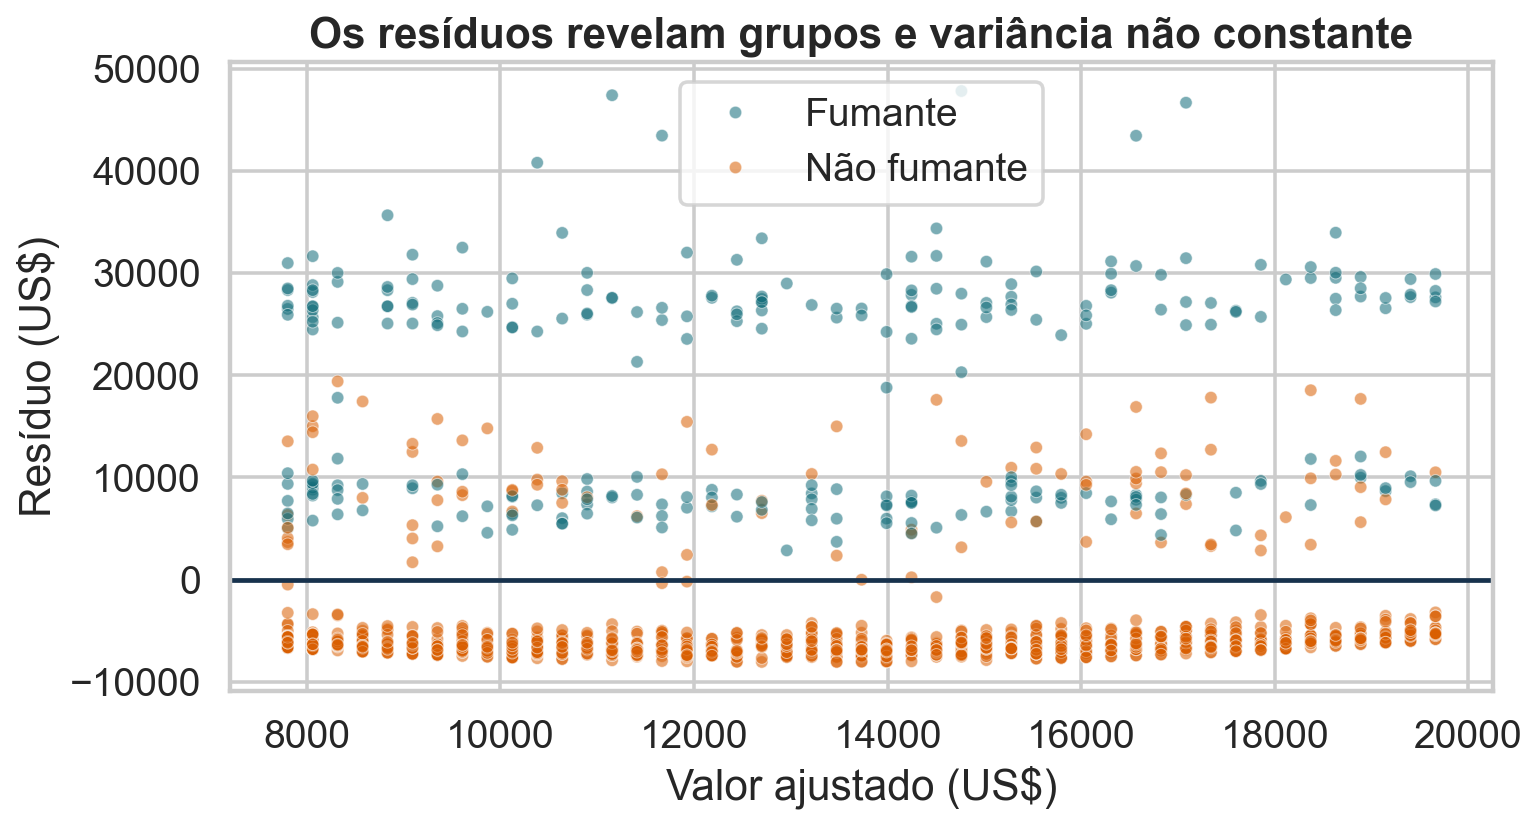
O tabagismo separa os resíduos em patamares. A variabilidade também cresce em partes da faixa ajustada.
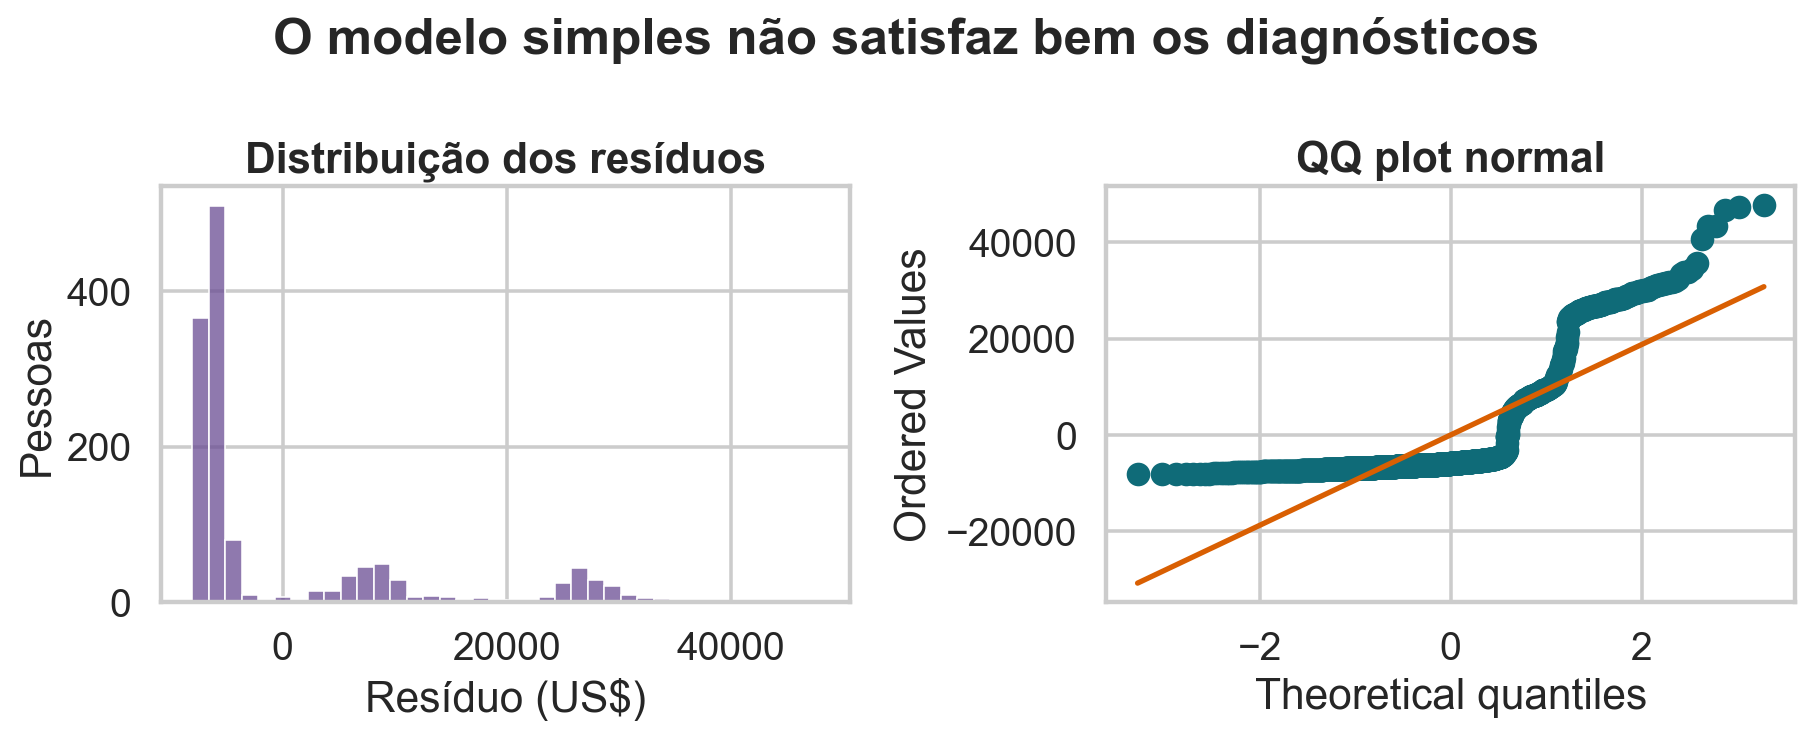
Os resíduos são assimétricos e desviam da reta normal. Isso alerta contra inferência paramétrica ingênua no modelo simples.
Para interpretar a reta como modelo da média e fazer inferência convencional, examinamos:
Normalidade não é necessária para calcular OLS.
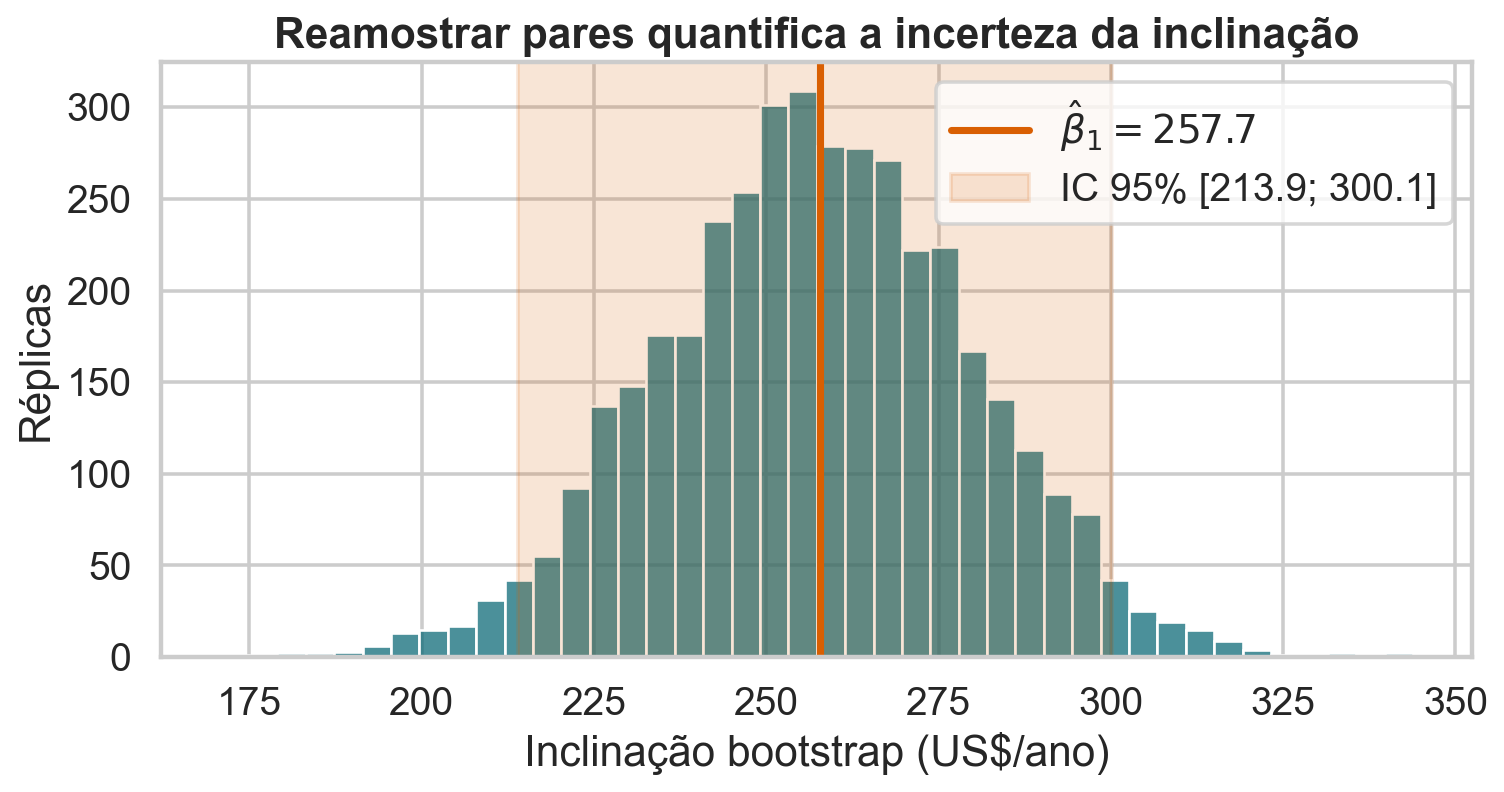
Reamostramos linhas completas \((x_i,y_i)\) e reajustamos a reta. O IC percentil de 95% é aproximadamente US$ 214 a US$ 300 por ano.
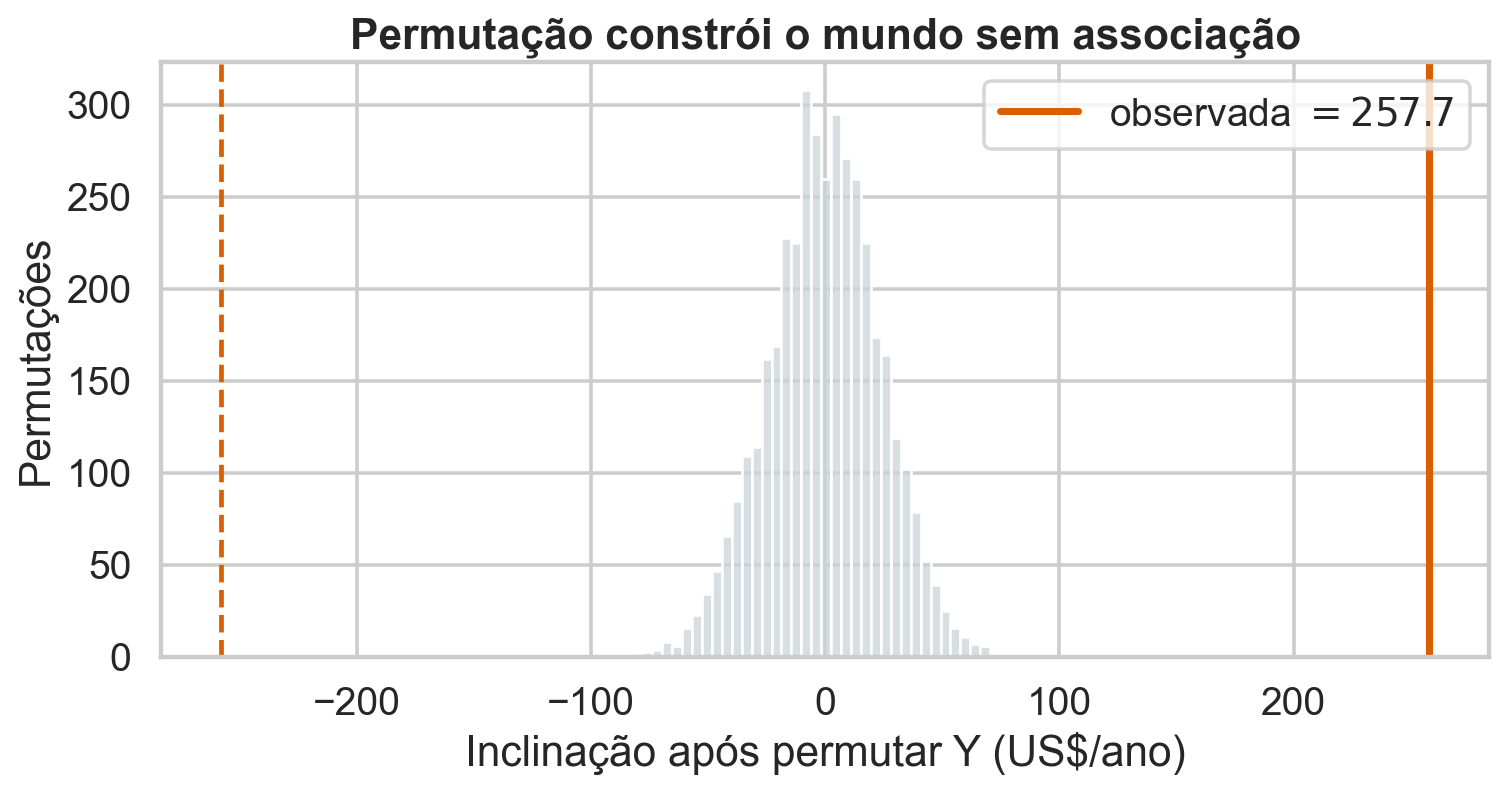
Permutar \(Y\) mantém idades e despesas, mas quebra seus pares. A inclinação observada fica muito distante da distribuição nula.
Os dados fornecem evidência de associação linear entre idade e despesas, e o bootstrap mostra que a inclinação é estimada com alguma precisão.
Mas:
A máxima verossimilhança dará uma interpretação probabilística aos mesmos coeficientes em uma aula posterior.
Considere regressão linear simples ajustada por OLS com intercepto.
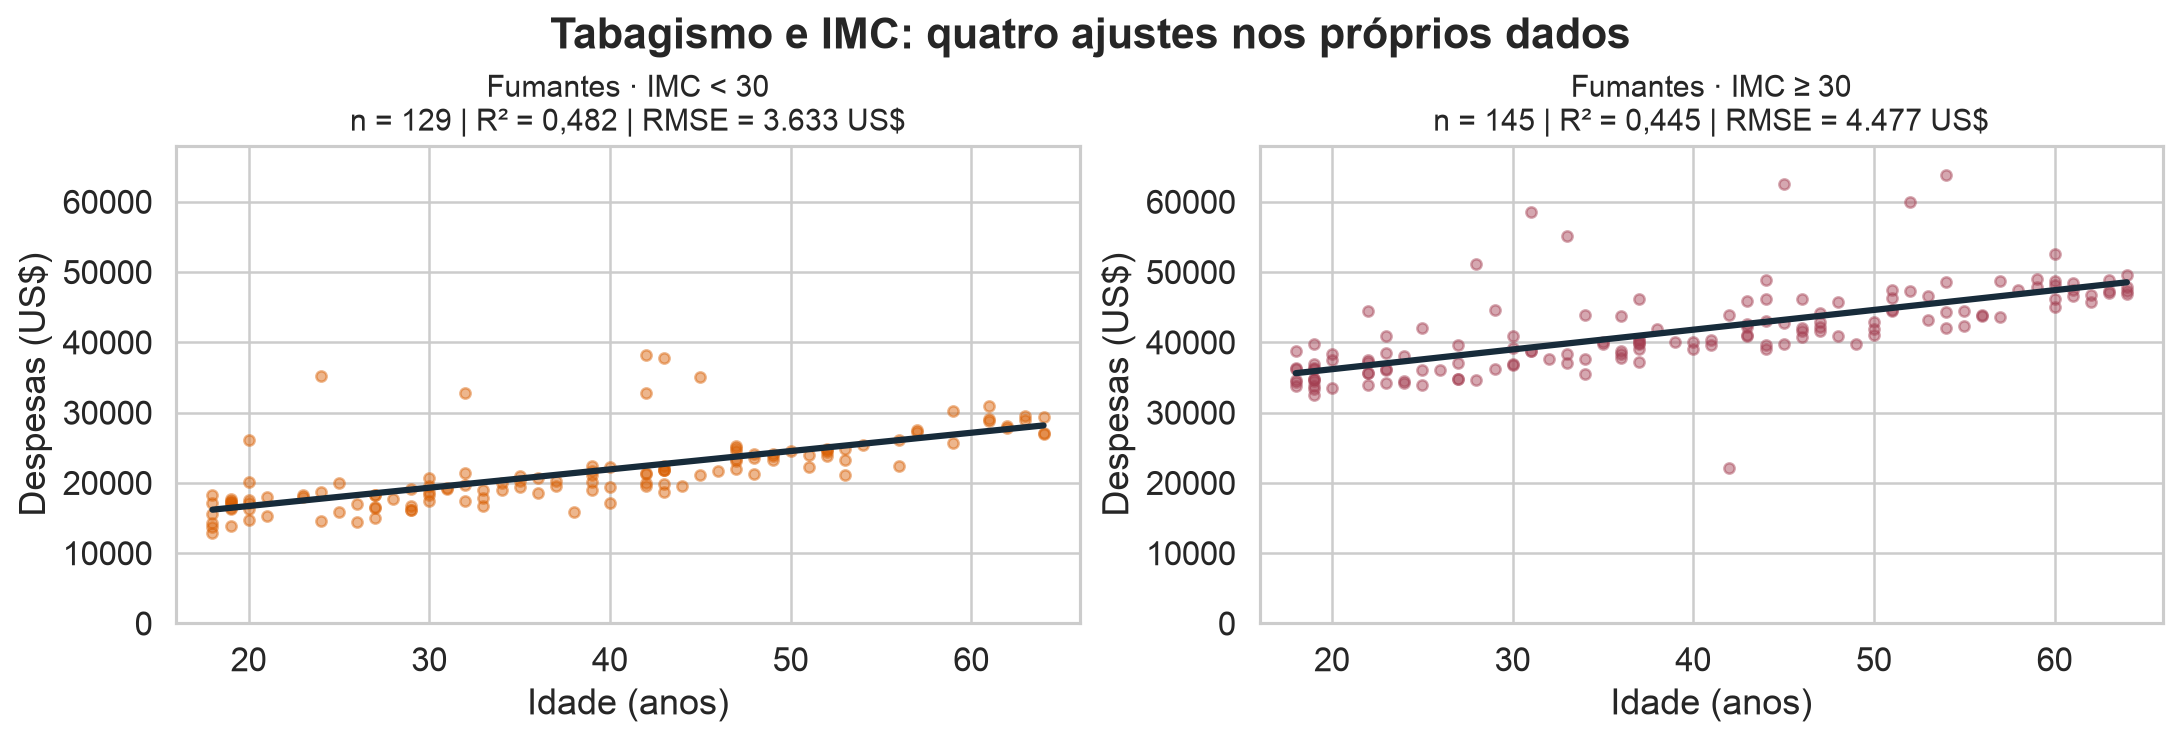
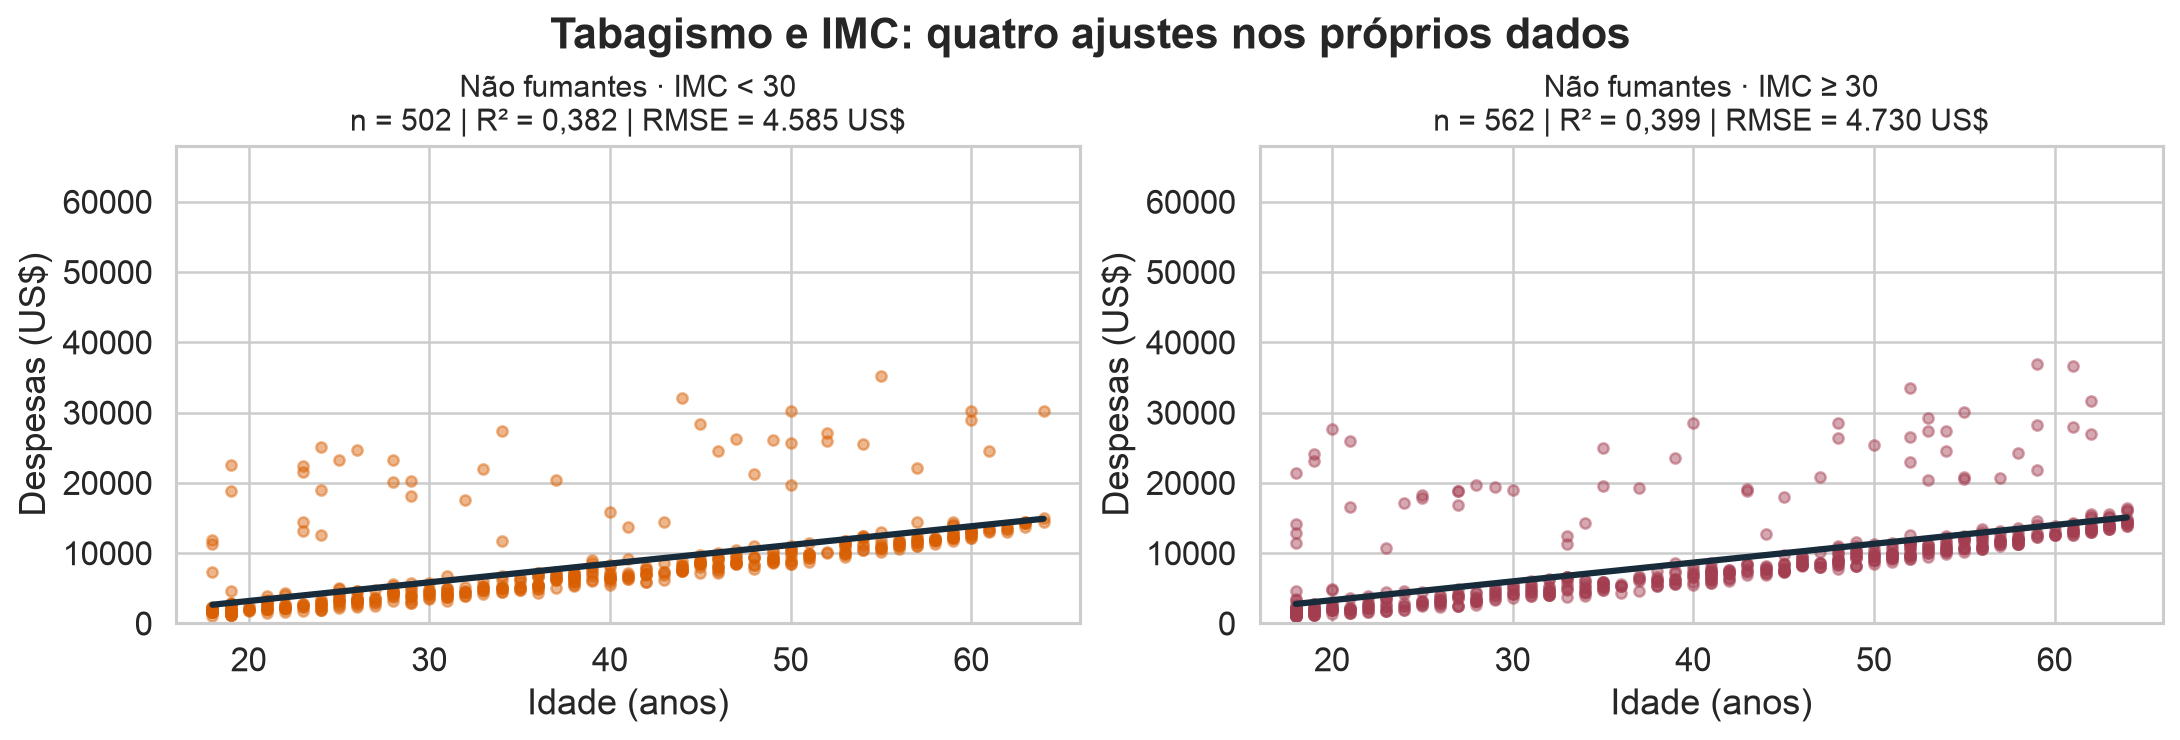
A reta global mistura grupos. Vamos ajustar despesas em função da idade em quatro subgrupos definidos por características observadas:
Pergunta: o IMC ajuda a explicar as diferentes nuvens de despesas dentro de cada grupo de tabagismo?
O IMC não mede diretamente autocuidado. Não vamos chamar esses grupos de pessoas que “se cuidam mais” ou “se cuidam menos”.
Cruzamos tabagismo com duas faixas de IMC, em kg/m²:
| Grupo | IMC < 30 | IMC ≥ 30 |
|---|---|---|
| Fumantes | 129 pessoas | 145 pessoas |
| Não fumantes | 502 pessoas | 562 pessoas |
Cada pessoa pertence a um único grupo. A despesa não participa da classificação.
O corte em 30 é fixo neste exercício; não foi otimizado para obter o maior R².
O recorte por IMC distingue bem os dois patamares de despesas. As inclinações são próximas, mas há dispersão e pontos afastados das retas.
As retas são muito semelhantes. O IMC não separa as duas nuvens dos não fumantes: ainda há despesas altas e baixas em ambas as faixas.
Cada reta tem a forma \(\widehat y=b_0+b_1\times\text{idade}\), com despesas em dólares.
| Grupo / IMC | \(n\) | \(b_0\) | \(b_1\) (US$/ano) | \(R^2\) | RMSE (US$) |
|---|---|---|---|---|---|
| Fumantes / < 30 | 129 | 11.503,36 | 260,64 | 0,482 | 3.633,16 |
| Fumantes / ≥ 30 | 145 | 30.558,13 | 281,15 | 0,445 | 4.477,15 |
| Não fumantes / < 30 | 502 | −2.118,37 | 265,95 | 0,382 | 4.584,75 |
| Não fumantes / ≥ 30 | 562 | −2.029,05 | 267,39 | 0,399 | 4.729,81 |
\(R^2\) usa a média do próprio subgrupo como referência. O RMSE mede o erro quadrático em dólares. Todas as métricas são calculadas nos dados do ajuste.
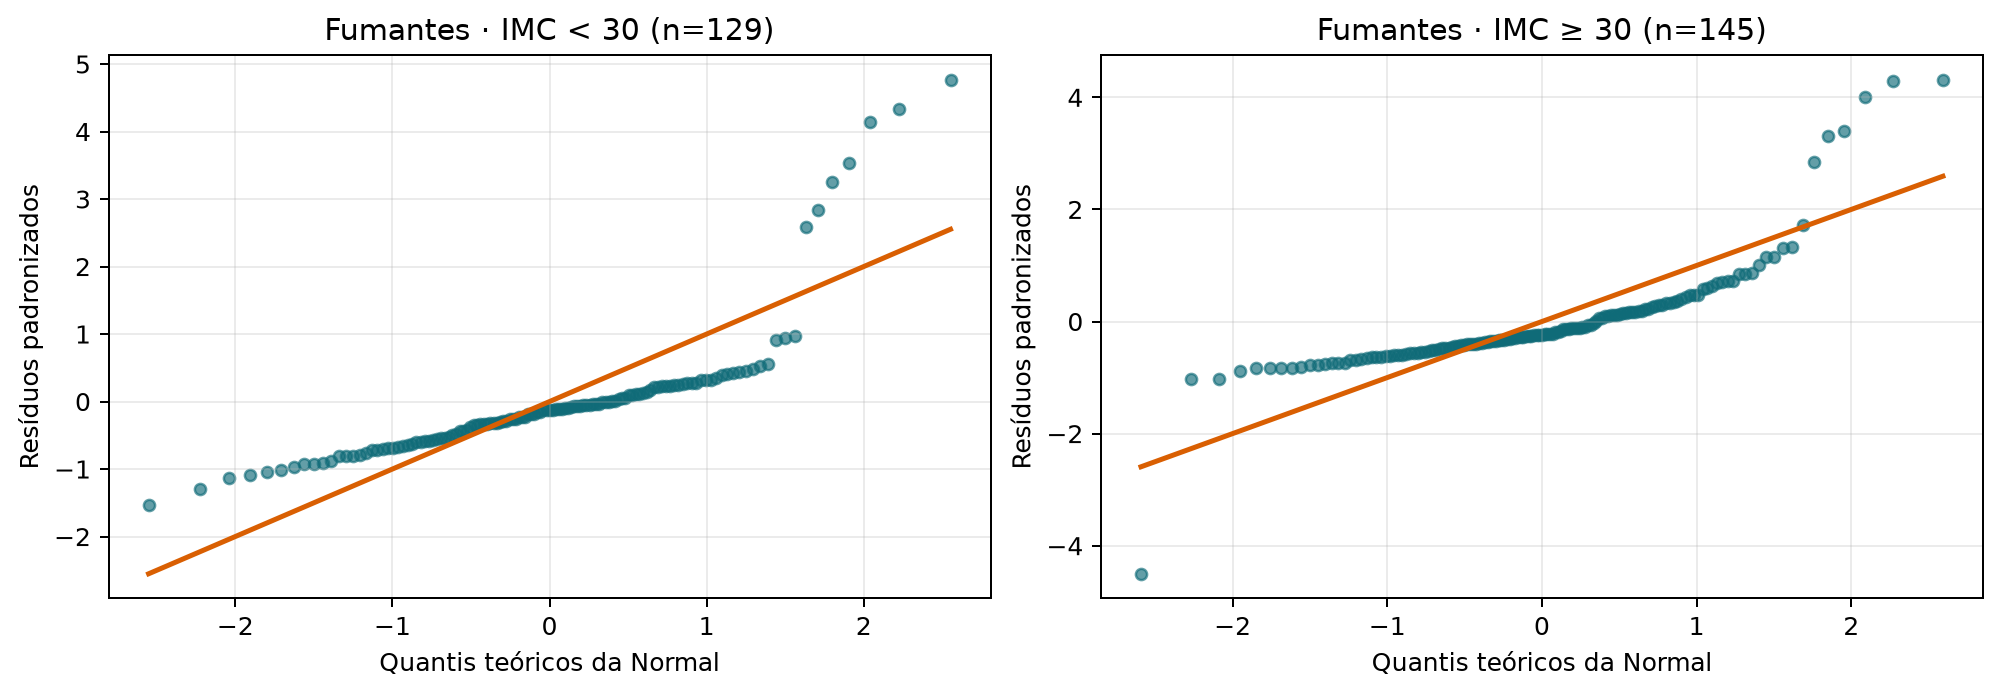
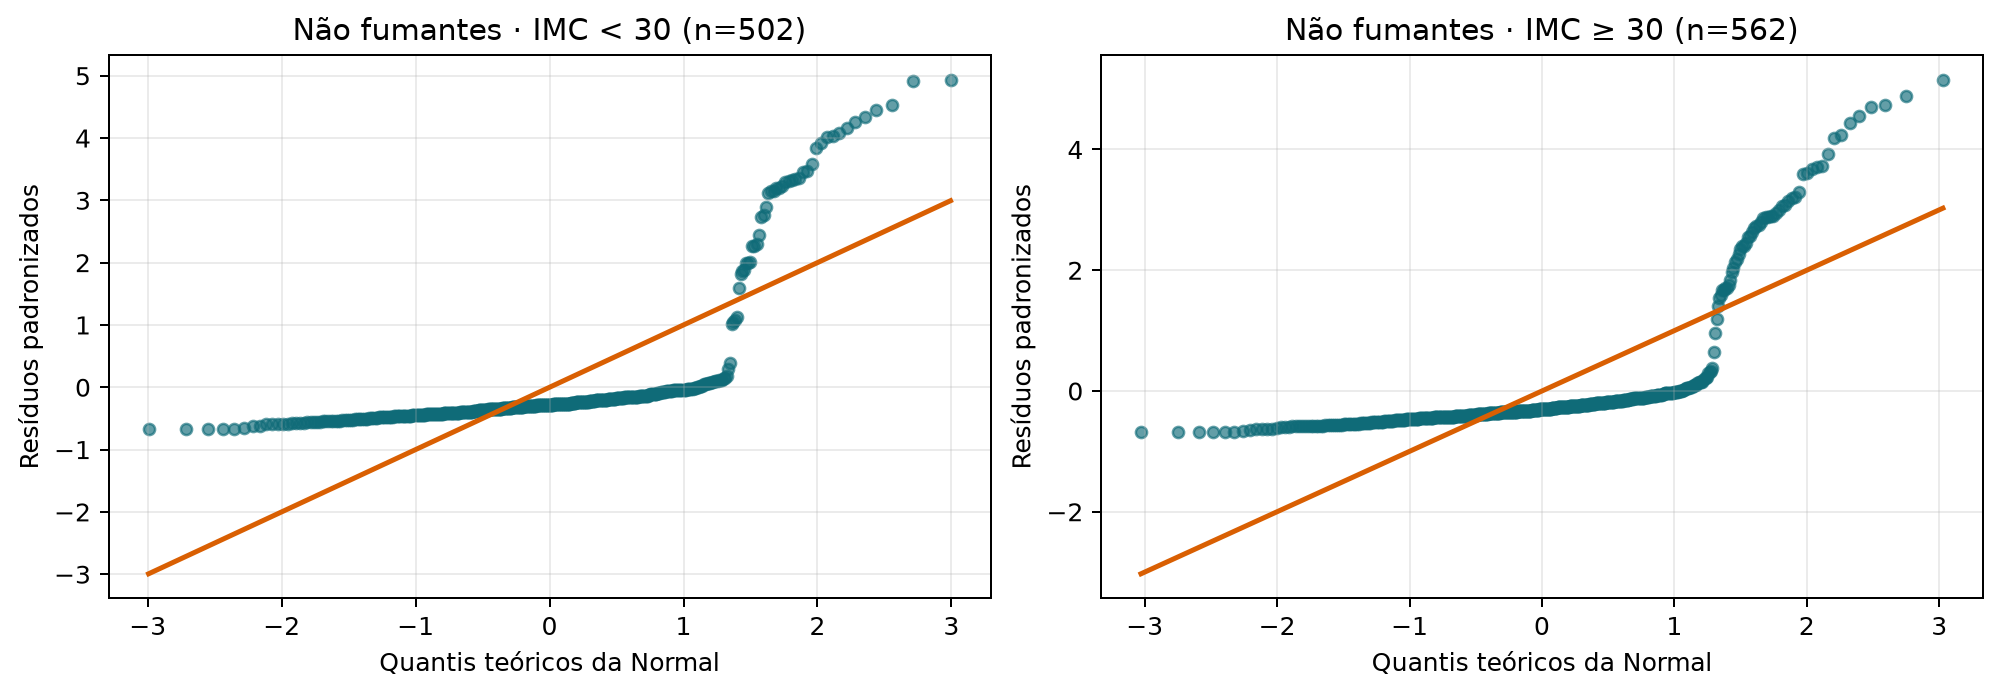
Comparamos quantis dos resíduos padronizados aos da Normal. Nas duas faixas de IMC, os desvios da diagonal e a cauda direita indicam que o ajuste deixa resíduos não normais.
As duas faixas mantêm uma mistura de patamares de despesas. A assimetria dos resíduos persiste: separar por IMC não resolve essa heterogeneidade.
\(H_0\): os valores seguem uma distribuição Normal, com média e variância estimadas. Quanto maior \(A^2\), maior a discrepância, com atenção às caudas.
| Grupo / IMC | \(A^2\) | Valor-p aproximado | Leitura nominal a 5% |
|---|---|---|---|
| Fumantes / < 30 | 10,996 | < 0,001 | Rejeita normalidade |
| Fumantes / ≥ 30 | 10,697 | < 0,001 | Rejeita normalidade |
| Não fumantes / < 30 | 104,361 | < 0,001 | Rejeita normalidade |
| Não fumantes / ≥ 30 | 109,327 | < 0,001 | Rejeita normalidade |
Leitura exploratória: os resíduos resultam de retas estimadas e não são uma amostra independente. Os valores-p usuais não corrigem esse efeito.
Os quatro testes são exploratórios, sem ajuste para múltiplas comparações. Não interpretamos valores-p arredondados a zero como probabilidades exatamente nulas.
A classificação usa tabagismo e IMC, disponíveis sem conhecer a despesa. Mesmo assim, as métricas são de ajuste na amostra: avaliar previsão exige dados separados.
O material de apoio contém o recorte, os ajustes, as métricas e os diagnósticos.
O IMC ajuda a descrever parte da heterogeneidade, mas não identifica quem se cuida mais ou menos.
As retas descrevem associações. A hipótese de autocuidado permanece aberta e exige dados e desenho de estudo adequados.
Hoje resolvemos OLS por cálculo. Nas próximas aulas, veremos como uma distribuição probabilística leva à mesma solução por máxima verossimilhança e como algoritmos iterativos a encontram por gradiente descendente.
ICD: Aula 17 — Regressão linear simplesvoltar para a Aula