Este notebook acompanha a primeira aula de Introdução à Ciência de Dados. A ideia é mostrar que uma análise começa com uma pergunta, não com um algoritmo.
Pergunta
Como poderiamos investigar se o acesso a equipamentos publicos varia entre regioes de uma cidade?
Esta ainda não é uma pergunta perfeita. Ela precisa virar uma comparação mensurável.
Dados didáticos
A tabela abaixo é pequena e fictícia. Ela serve para discutir conceitos iniciais: linha, coluna, unidade observacional, variável e indicador.
A pequena tabela foi construída para tornar visível a passagem entre observações, variáveis e perguntas. Os números ainda não sustentam generalizações: servem para exercitar a leitura da estrutura dos dados.
Unidade observacional e variáveis
Cada linha representa uma região.
população, equipamentos_publicos e area_km2 são variáveis.
A tabela ainda não responde tudo, mas já permite criar indicadores.
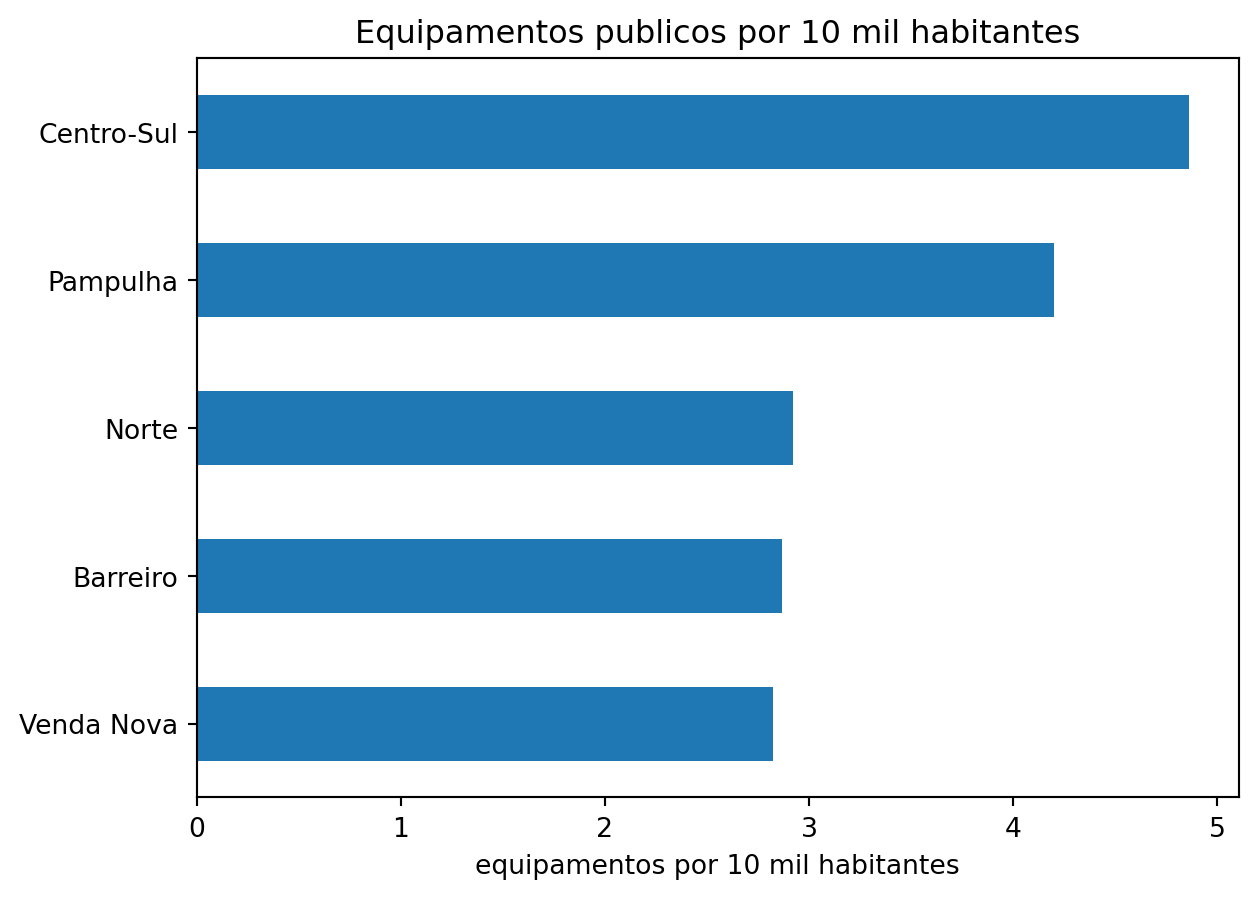
Um gráfico simples pode ajudar a enxergar diferenças, mas ele não substitui a pergunta nem resolve as limitações dos dados.
ax = dados.sort_values("equipamentos_por_10k").plot.barh( x="regiao", y="equipamentos_por_10k", legend=False, title="Equipamentos publicos por 10 mil habitantes")ax.set_xlabel("equipamentos por 10 mil habitantes")ax.set_ylabel("")
NotaInterpretação
O gráfico permite comparar categorias mais rapidamente que a tabela, mas não cria informação nova. A conclusão continua limitada ao conjunto didático observado.
Limitacoes
Esta análise não mede qualidade dos equipamentos, distância real, demanda, horário de funcionamento ou desigualdades dentro de cada região.
Uma boa conclusão precisa dizer o que foi medido e o que ficou fora da tabela.
Para praticar
Crie outro indicador usando as colunas disponiveis.
Explique em duas frases o que esse indicador mede.
Escreva uma pergunta que esta tabela não consegue responder.
Guia teórico da Aula 01
O que é ciência de dados?
Ciência de dados combina formulação de perguntas, coleta, organização, computação, estatística, conhecimento do domínio e comunicação. O resultado não é apenas uma previsão: é uma afirmação cuja origem, incerteza e consequência podem ser examinadas.
A área foi impulsionada pela combinação de três forças: grande coleta de dados pela internet e por sensores, aumento do poder computacional — incluindo GPUs — e desenvolvimento de técnicas e algoritmos. Nenhuma dessas forças elimina a necessidade de perguntas bem formuladas e dados adequados.
O ciclo de uma análise
formular uma pergunta verificável;
compreender como os dados foram produzidos;
obter e organizar a base;
explorar e visualizar;
modelar ou inferir;
avaliar incerteza e limitações;
comunicar e decidir;
monitorar consequências e revisar.
O ciclo não é linear: resultados inesperados frequentemente nos fazem voltar à pergunta ou à coleta.
Correlação, causalidade e responsabilidade
Correlação descreve variação conjunta, mas não identifica automaticamente causa. Confusão, seleção, coincidência e causalidade reversa podem produzir associações. Esse cuidado prepara a Aula 02.
Responsabilidade acompanha todo o ciclo. LGPD, finalidade, minimização, segurança, transparência e não discriminação não são etapas finais. Um sistema pode ter boa acurácia média e ainda prejudicar grupos específicos. Sempre pergunte quem forneceu os dados, quem está ausente, quem recebe benefícios e quem assume os riscos.