Este notebook acompanha a aula de causalidade. O objetivo não é fazer inferência estatística formal ainda. A ideia é entender, com tabelas e gráficos, como uma pergunta causal vira uma comparação entre tratamento e controle.
1. Pergunta causal
Enviar um lembrete dois dias antes do prazo aumenta a chance de estudantes entregarem uma lista no prazo?
Unidade observacional: estudante.
Tratamento: receber lembrete.
Controle: não receber lembrete extra.
Resultado: entregar a lista no prazo.
Comparacao: taxa de entrega no grupo tratado contra taxa de entrega no grupo controle.
2. Por que precisamos de controle?
Se apenas observarmos quem recebeu lembrete e quem entregou, podemos confundir o efeito do lembrete com outras diferenças entre estudantes. Por exemplo, estudantes mais organizados poderiam abrir mais mensagens e também entregar mais no prazo.
A randomização ajuda a criar dois grupos comparáveis antes do tratamento.
Sem um grupo de controle, uma melhora posterior pode ser confundida com sazonalidade, aprendizado ou mudanças externas. O controle fornece a referência contrafactual do experimento.
3. Os grupos parecem comparáveis?
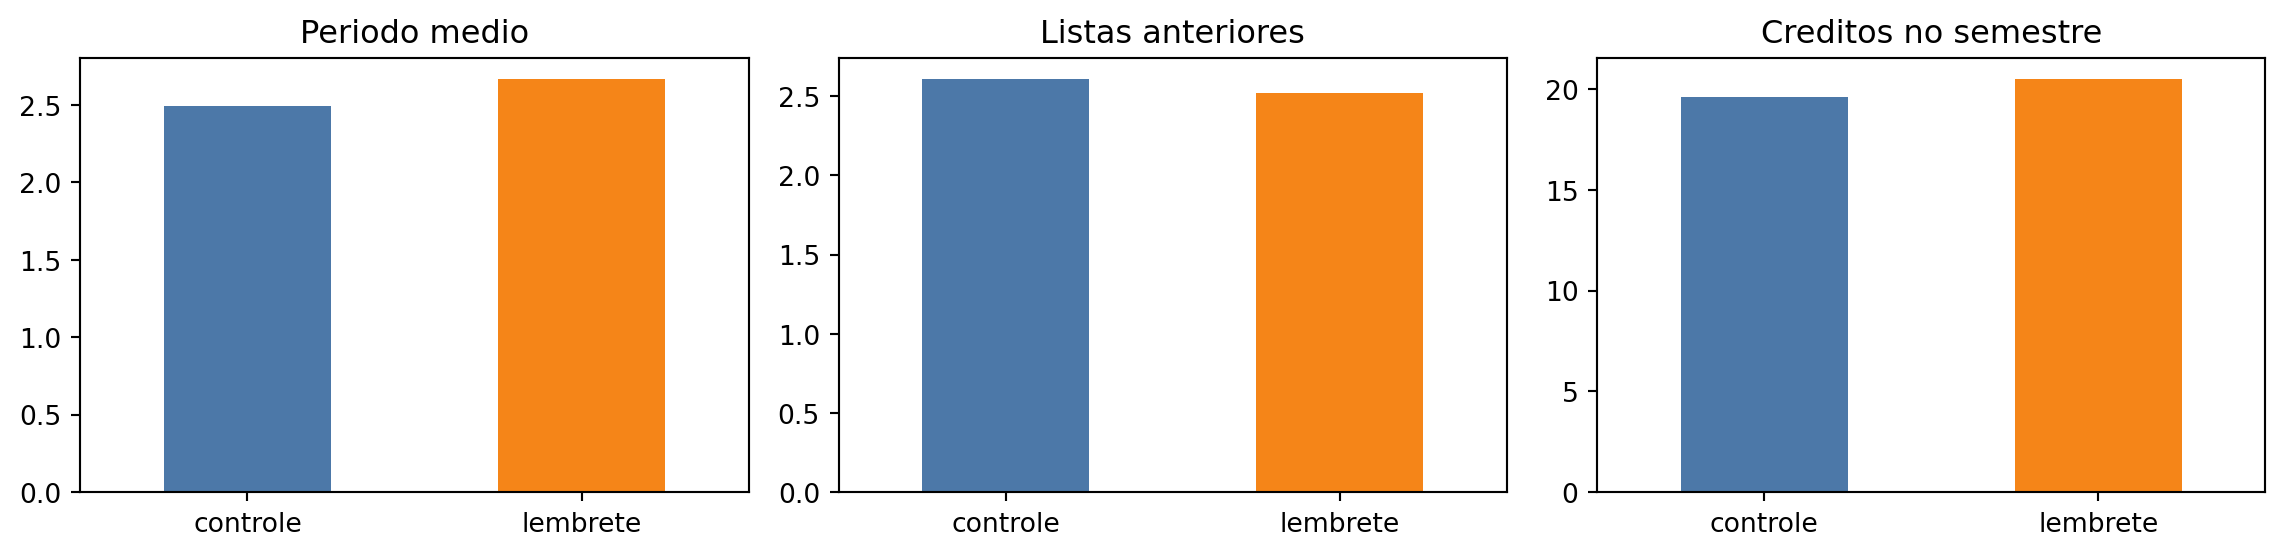
Randomizacao não cria grupos idênticos. Ela cria grupos sem uma regra enviesada de escolha. Mesmo assim, vale olhar se as covariáveis observadas parecem parecidas.
Diferenças pequenas antes do tratamento são compatíveis com a aleatorização. Desequilíbrios grandes sugeririam falha na atribuição, amostra pequena ou necessidade de investigar a coleta.
4. Observando o resultado
Agora observamos quem entregou no prazo. Em um experimento real, esta coluna viria depois da intervenção. Aqui ela é simulada para fins didáticos.
A diferença observada descreve esta amostra. Para atribuí-la ao tratamento, ainda precisamos considerar a variabilidade produzida pela atribuição aleatória.
5. Comparando tratamento e controle
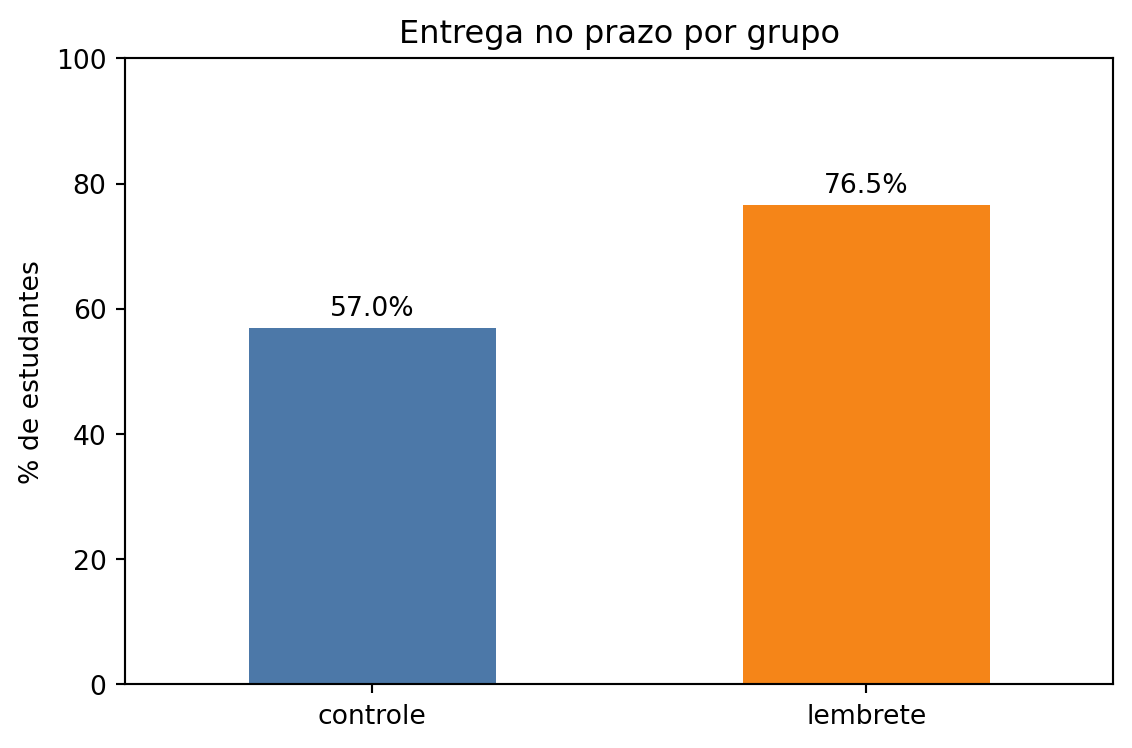
A primeira comparação é a taxa de entrega no prazo em cada grupo.
ax = (taxas *100).plot( kind="bar", color=["#4c78a8", "#f58518"], figsize=(6, 4), ylim=(0, 100), title="Entrega no prazo por grupo")ax.set_ylabel("% de estudantes")ax.set_xlabel("")ax.tick_params(axis="x", rotation=0)for i, valor inenumerate(taxas *100): ax.text(i, valor +2, f"{valor:.1f}%", ha="center")plt.tight_layout()
6. A diferenca observada
A diferença de taxas é uma forma simples de resumir o resultado. Ela mede quantos pontos percentuais separam o grupo tratado do grupo controle.
print(f"Diferenca observada: {100* diferenca:.1f} pontos percentuais")
Diferenca observada: 19.6 pontos percentuais
7. Interpretacao causal
Como o grupo foi sorteado, a comparação entre tratamento e controle é mais justa do que uma comparação entre pessoas que escolheram receber ou não receber lembrete.
Mesmo assim, a conclusão deve ser cuidadosa: neste exemplo, observamos uma diferença positiva associada ao lembrete. Para afirmar um efeito em uma turma real, precisamos olhar o desenho do experimento, possíveis problemas de implementação e se houve vazamento entre grupos.
8. O que poderia dar errado?
Alguns estudantes do controle podem receber o lembrete por colegas.
O Moodle pode não éntregar todas as mensagens.
Entregar no prazo não mede aprendizagem diretamente.
O efeito pode ser diferente em outra turma ou outro tipo de lista.
A intervenção pode ajudar pouco se o problema principal for dificuldade com o conteudo.
Para praticar
Identifique tratamento, controle, resultado e unidade observacional.
Explique por que sortear estudantes ajuda na interpretacao causal.
Mude efeito_lembrete e observe como o gráfico muda.
Escreva uma limitacao que não aparece na lista acima.
Guia teórico da Aula 02
Resultados potenciais e ATE
Para cada unidade \(i\), imagine dois resultados potenciais: \(Y_i(1)\) sob tratamento e \(Y_i(0)\) sob controle. O efeito individual seria \(Y_i(1)-Y_i(0)\), mas observamos apenas um desses resultados. Esse é o problema fundamental da inferência causal.
O ATE — Average Treatment Effect é
\[\operatorname{ATE}=\mathbb E[Y(1)-Y(0)].\]
Como o contrafactual individual não é observado, precisamos de um grupo de comparação que represente o que teria acontecido sem a intervenção.
Por que randomizar?
A randomização torna o tratamento independente, em expectativa, das características prévias. Assim, diferenças sistemáticas entre grupos podem ser atribuídas ao tratamento, sujeitas ao acaso, adesão, attrition e interferência. Controle, randomização e replicação cumprem papéis diferentes: comparação, balanceamento e mensuração da variabilidade.
Estudos observacionais e confusão
Em estudos observacionais, uma variável \(Z\) pode influenciar tratamento e resultado, criando uma associação não causal. Ajustar exige medir confundidores relevantes e justificar as suposições; nenhum algoritmo recupera uma variável importante que nunca foi observada.
Validade interna pergunta se a comparação identifica o efeito no estudo. Validade externa pergunta para quem, onde e quando o efeito pode ser transportado. Evidência forte exige desenho, mensuração, análise e transparência — não apenas um valor-p pequeno.