from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns

sns.set_theme(style="whitegrid")
pd.set_option("display.max_columns", 30)

DATA = next(path for path in [
    Path("data/AB_NYC_2019.csv"),
    Path("exemplos/03-tabelas-tipos/data/AB_NYC_2019.csv"),
] if path.exists())Aula 03 — Tabelas e tipos de dados com Airbnb NYC
Material de estudo
Objetivos
Este notebook usa a base New York City Airbnb Open Data (2019), publicada no Kaggle. Cada linha representa um anúncio e as colunas descrevem localização, tipo de acomodação, preço, avaliações e disponibilidade.
Ao final, você deverá conseguir:
- explicar o que representa uma linha da tabela;
- diferenciar tipo computacional e tipo semântico;
- inspecionar dimensões, colunas, ausências e duplicatas;
- converter categorias e datas;
- construir regras simples de validade;
- selecionar linhas e colunas com
loc,ilocequery; - criar colunas vetorizadas;
- resumir grupos com
groupbyeagg; - documentar decisões de limpeza.
Fonte: https://www.kaggle.com/datasets/thedevastator/airbnbs-nyc-overview.
Como estudar este capítulo
Antes de analisar dados, precisamos entender o que a tabela representa. Uma coluna chamada price pode parecer autoexplicativa, mas sua interpretação depende da unidade, do período, da moeda e do processo de coleta. Da mesma forma, o tipo int64 informa como o computador armazenou valores, não se a variável é uma medida, uma categoria ou um identificador.
Este capítulo segue o percurso de uma primeira leitura profissional: identificar a unidade observacional, consultar o dicionário, verificar dimensões e tipos, investigar ausências e duplicatas, aplicar regras de validade e somente então resumir grupos. Cada operação em pandas responde a uma pergunta sobre a base; ela não deve ser executada apenas porque faz parte de uma receita.
Antes de abrir cada código, formule o resultado esperado. Depois da saída, descreva em palavras o que mudou na tabela, quantas observações foram afetadas e que decisão analítica isso sustenta. O objetivo é aprender simultaneamente a linguagem das tabelas e o raciocínio necessário para trabalhar com elas.
1. Preparação
2. Leitura e unidade observacional
airbnb = pd.read_csv(DATA)
airbnb.head(3)| id | name | host_id | host_name | neighbourhood_group | neighbourhood | latitude | longitude | room_type | price | minimum_nights | number_of_reviews | last_review | reviews_per_month | calculated_host_listings_count | availability_365 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2539 | Clean & quiet apt home by the park | 2787 | John | Brooklyn | Kensington | 40.64749 | -73.97237 | Private room | 149 | 1 | 9 | 2018-10-19 | 0.21 | 6 | 365 |
| 1 | 2595 | Skylit Midtown Castle | 2845 | Jennifer | Manhattan | Midtown | 40.75362 | -73.98377 | Entire home/apt | 225 | 1 | 45 | 2019-05-21 | 0.38 | 2 | 355 |
| 2 | 3647 | THE VILLAGE OF HARLEM....NEW YORK ! | 4632 | Elisabeth | Manhattan | Harlem | 40.80902 | -73.94190 | Private room | 150 | 3 | 0 | NaN | NaN | 1 | 365 |
Unidade observacional: um anúncio publicado na plataforma. A tabela não registra diretamente reservas, hóspedes ou faturamento realizado.
airbnb.shape(48895, 16)
NotaInterpretação
Antes de interpretar resultados, confirme o que cada linha representa, o período coberto e as colunas realmente disponíveis. Essa definição determina quais agregações e comparações são válidas.
airbnb.columns.tolist()['id',
'name',
'host_id',
'host_name',
'neighbourhood_group',
'neighbourhood',
'latitude',
'longitude',
'room_type',
'price',
'minimum_nights',
'number_of_reviews',
'last_review',
'reviews_per_month',
'calculated_host_listings_count',
'availability_365']Dicionário das principais variáveis
| coluna | significado | tipo semântico |
|---|---|---|
id |
identificador do anúncio | identificador |
host_id |
identificador do anfitrião | identificador |
neighbourhood_group |
distrito | categoria nominal |
neighbourhood |
bairro | categoria nominal |
latitude, longitude |
posição geográfica | coordenadas |
room_type |
modalidade do anúncio | categoria nominal |
price |
preço anunciado por noite em US$ | quantidade |
minimum_nights |
mínimo de noites | contagem |
number_of_reviews |
total de avaliações | contagem |
last_review |
data da avaliação mais recente | data |
reviews_per_month |
média mensal de avaliações | taxa |
availability_365 |
dias disponíveis no ano | contagem limitada |
3. Diagnóstico inicial
airbnb.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 48895 entries, 0 to 48894
Data columns (total 16 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 id 48895 non-null int64
1 name 48879 non-null object
2 host_id 48895 non-null int64
3 host_name 48874 non-null object
4 neighbourhood_group 48895 non-null object
5 neighbourhood 48895 non-null object
6 latitude 48895 non-null float64
7 longitude 48895 non-null float64
8 room_type 48895 non-null object
9 price 48895 non-null int64
10 minimum_nights 48895 non-null int64
11 number_of_reviews 48895 non-null int64
12 last_review 38843 non-null object
13 reviews_per_month 38843 non-null float64
14 calculated_host_listings_count 48895 non-null int64
15 availability_365 48895 non-null int64
dtypes: float64(3), int64(7), object(6)
memory usage: 6.0+ MBObserve que last_review chegou como object. O pandas conhece a representação inicial, mas não conhece automaticamente todo o significado da variável.
diagnostico = pd.DataFrame({
    "dtype": airbnb.dtypes.astype(str),
    "ausentes": airbnb.isna().sum(),
    "unicos": airbnb.nunique(dropna=True),
})
diagnostico| dtype | ausentes | unicos | |
|---|---|---|---|
| id | int64 | 0 | 48895 |
| name | object | 16 | 47905 |
| host_id | int64 | 0 | 37457 |
| host_name | object | 21 | 11452 |
| neighbourhood_group | object | 0 | 5 |
| neighbourhood | object | 0 | 221 |
| latitude | float64 | 0 | 19048 |
| longitude | float64 | 0 | 14718 |
| room_type | object | 0 | 3 |
| price | int64 | 0 | 674 |
| minimum_nights | int64 | 0 | 109 |
| number_of_reviews | int64 | 0 | 394 |
| last_review | object | 10052 | 1764 |
| reviews_per_month | float64 | 10052 | 937 |
| calculated_host_listings_count | int64 | 0 | 47 |
| availability_365 | int64 | 0 | 366 |
Pergunta de estudo 1
Por que id e host_id, embora armazenados como inteiros, não são variáveis quantitativas? Tente explicar antes de abrir a resposta.
Resposta sugerida
Os números funcionam como rótulos. Somar, calcular a média ou multiplicar IDs não produz uma quantidade interpretável.4. Tipos mais adequados
categoricas = ["neighbourhood_group", "neighbourhood", "room_type"]
airbnb[categoricas] = airbnb[categoricas].astype("category")

airbnb["last_review"] = pd.to_datetime(
    airbnb["last_review"], errors="coerce"
)

airbnb[categoricas + ["last_review"]].dtypes
neighbourhood_group category
neighbourhood category
room_type category
last_review datetime64[ns]
dtype: objectDatas permitem novas perguntas
airbnb["review_year"] = airbnb["last_review"].dt.year.astype("Int64")
airbnb["review_month"] = airbnb["last_review"].dt.month.astype("Int64")

airbnb[["last_review", "review_year", "review_month"]].head()| last_review | review_year | review_month | |
|---|---|---|---|
| 0 | 2018-10-19 | 2018 | 10 |
| 1 | 2019-05-21 | 2019 | 5 |
| 2 | NaT | <NA> | <NA> |
| 3 | 2019-07-05 | 2019 | 7 |
| 4 | 2018-11-19 | 2018 | 11 |
5. Valores ausentes
missing = airbnb.isna().sum().sort_values(ascending=False)
missing[missing > 0]
review_month 10052
review_year 10052
reviews_per_month 10052
last_review 10052
host_name 21
name 16
dtype: int64fig, ax = plt.subplots(figsize=(8, 4))
missing[missing > 0].sort_values().plot.barh(ax=ax, color="#0f6b78")
ax.set(title="Valores ausentes por coluna", xlabel="ausentes", ylabel="")
plt.show()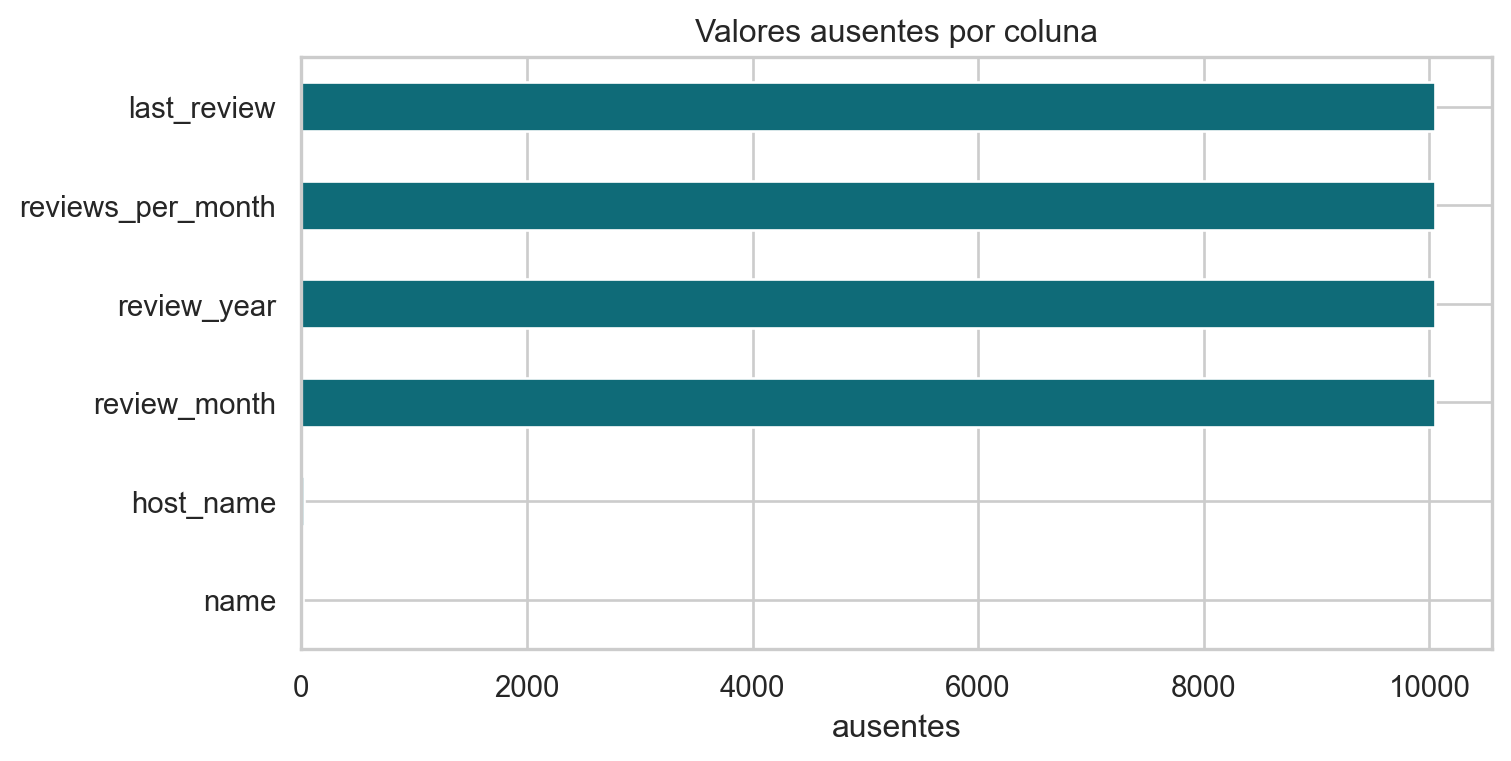
last_review e reviews_per_month faltam nas mesmas 10.052 linhas. Vamos verificar se os padrões coincidem.
mesmo_padrao = airbnb["last_review"].isna().equals(
    airbnb["reviews_per_month"].isna()
)
mesmo_padraoTruepd.crosstab(
airbnb["number_of_reviews"].eq(0),
airbnb["last_review"].isna(),
rownames=["zero avaliações"],
colnames=["data ausente"],
)| data ausente | False | True |
|---|---|---|
| zero avaliações | ||
| False | 38843 | 0 |
| True | 0 | 10052 |
NotaInterpretação
As ausências de last_review e reviews_per_month coincidem com anúncios sem avaliações, indicando um padrão estrutural: sem avaliação, não existem data da última avaliação nem média mensal. Ausência não equivale a zero; preencher a data ou a taxa com zero mudaria o significado dos dados.
6. Identificadores e duplicatas
pd.Series({
    "linhas duplicadas": airbnb.duplicated().sum(),
    "IDs duplicados": airbnb["id"].duplicated().sum(),
    "ID é único": airbnb["id"].is_unique,
})
linhas duplicadas 0
IDs duplicados 0
ID é único True
dtype: objectAnúncios com nomes iguais não são necessariamente duplicatas: pessoas distintas podem usar títulos genéricos como “Cozy apartment”.
7. Regras de validade
validacoes = pd.Series({
    "preço positivo": airbnb["price"].gt(0).mean(),
    "disponibilidade entre 0 e 365": airbnb["availability_365"].between(0, 365).mean(),
    "latitude plausível": airbnb["latitude"].between(40, 41).mean(),
    "longitude plausível": airbnb["longitude"].between(-75, -73).mean(),
})
validacoes
preço positivo 0.999775
disponibilidade entre 0 e 365 1.000000
latitude plausível 1.000000
longitude plausível 1.000000
dtype: float64airbnb.loc[airbnb["price"].eq(0), [
"id", "name", "neighbourhood_group", "room_type", "price"
]].head()| id | name | neighbourhood_group | room_type | price | |
|---|---|---|---|---|---|
| 23161 | 18750597 | Huge Brooklyn Brownstone Living, Close to it all. | Brooklyn | Private room | 0 |
| 25433 | 20333471 | ★Hostel Style Room | Ideal Traveling Buddies★ | Bronx | Private room | 0 |
| 25634 | 20523843 | MARTIAL LOFT 3: REDEMPTION (upstairs, 2nd room) | Brooklyn | Private room | 0 |
| 25753 | 20608117 | Sunny, Quiet Room in Greenpoint | Brooklyn | Private room | 0 |
| 25778 | 20624541 | Modern apartment in the heart of Williamsburg | Brooklyn | Entire home/apt | 0 |
Não vamos apagar automaticamente esses registros. Primeiro os marcamos para que a decisão seja auditável.
airbnb["price_valid"] = airbnb["price"].gt(0)
airbnb["price_extreme"] = airbnb["price"].gt(1000)
airbnb[["price_valid", "price_extreme"]].mean()
price_valid 0.999775
price_extreme 0.004888
dtype: float64
NotaInterpretação
Todo filtro redefine a população analisada. Registre a condição, conte quantas linhas permanecem e explicite o denominador antes de interpretar proporções ou médias.
8. Distribuição do preço
airbnb["price"].describe(percentiles=[.5, .9, .95, .99])count 48895.000000
mean 152.720687
std 240.154170
min 0.000000
50% 106.000000
90% 269.000000
95% 355.000000
99% 799.000000
max 10000.000000
Name: price, dtype: float64fig, axes = plt.subplots(1, 2, figsize=(11, 4))
sns.histplot(airbnb["price"], bins=60, ax=axes[0], color="#d95f02")
axes[0].set(title="Escala completa", xlabel="US$ por noite")
sns.histplot(
airbnb.loc[airbnb["price"].between(1, 500), "price"],
bins=50, ax=axes[1], color="#0f6b78"
)
axes[1].set(title="Zoom entre US$ 1 e 500", xlabel="US$ por noite")
plt.tight_layout()
plt.show()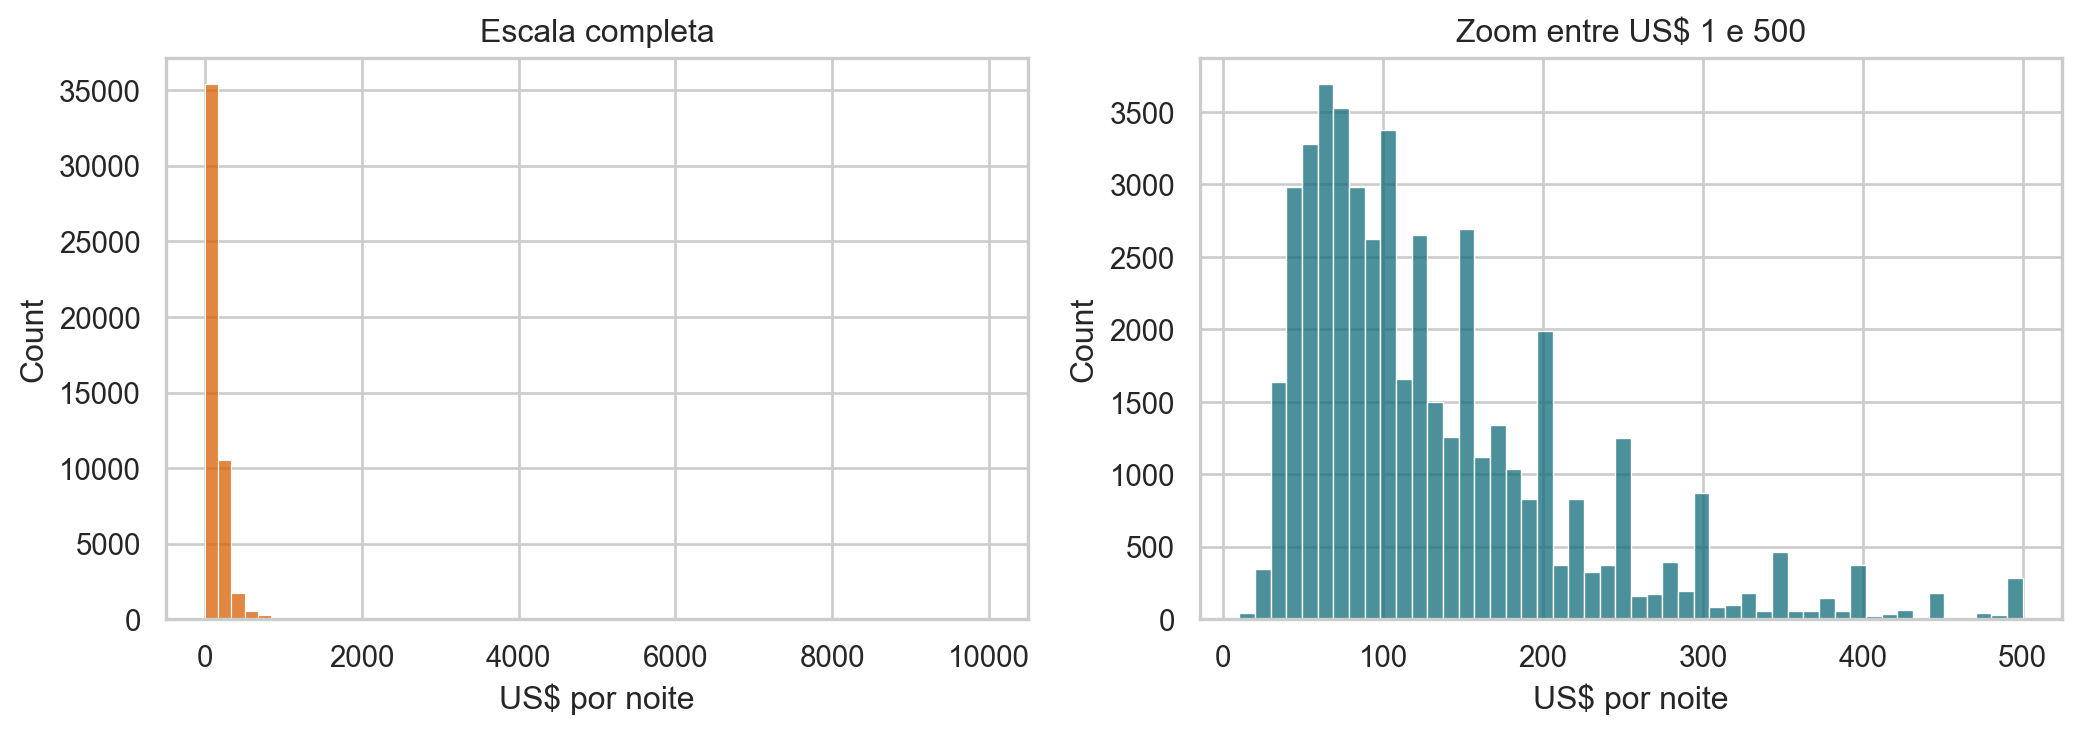
O zoom deve ser declarado: ele melhora a leitura da região densa, mas não pode ser usado para fingir que os valores extremos não existem.
9. Seleção de colunas e linhas
airbnb["price"].head() # Series0 149
1 225
2 150
3 89
4 80
Name: price, dtype: int64airbnb[["neighbourhood_group", "room_type", "price"]].head() # DataFrame| neighbourhood_group | room_type | price | |
|---|---|---|---|
| 0 | Brooklyn | Private room | 149 |
| 1 | Manhattan | Entire home/apt | 225 |
| 2 | Manhattan | Private room | 150 |
| 3 | Brooklyn | Entire home/apt | 89 |
| 4 | Manhattan | Entire home/apt | 80 |
airbnb.iloc[0:3, 0:5]| id | name | host_id | host_name | neighbourhood_group | |
|---|---|---|---|---|---|
| 0 | 2539 | Clean & quiet apt home by the park | 2787 | John | Brooklyn |
| 1 | 2595 | Skylit Midtown Castle | 2845 | Jennifer | Manhattan |
| 2 | 3647 | THE VILLAGE OF HARLEM....NEW YORK ! | 4632 | Elisabeth | Manhattan |
airbnb.loc[0:2, ["id", "room_type", "price"]]| id | room_type | price | |
|---|---|---|---|
| 0 | 2539 | Private room | 149 |
| 1 | 2595 | Entire home/apt | 225 |
| 2 | 3647 | Private room | 150 |
Filtros legíveis
recorte = airbnb.query(
    "neighbourhood_group == 'Manhattan' and "
    "room_type == 'Entire home/apt' and 0 < price <= 500"
).copy()

recorte.shape
(12523, 20)Usamos .copy() porque criaremos novas colunas no recorte.
10. Operações vetorizadas
recorte["price_brl_example"] = recorte["price"] * 5.0
recorte["potentially_unavailable_days"] = 365 - recorte["availability_365"]
recorte[["price", "price_brl_example", "availability_365",
"potentially_unavailable_days"]].head()| price | price_brl_example | availability_365 | potentially_unavailable_days | |
|---|---|---|---|---|
| 1 | 225 | 1125.0 | 355 | 10 |
| 4 | 80 | 400.0 | 0 | 365 |
| 5 | 200 | 1000.0 | 129 | 236 |
| 9 | 150 | 750.0 | 188 | 177 |
| 10 | 135 | 675.0 | 6 | 359 |
A cotação de 5 reais por dólar é apenas didática. Em uma análise real, registre a fonte e a data da taxa de câmbio.
11. Categorias e contagens
airbnb["neighbourhood_group"].value_counts()Manhattan 21661
Brooklyn 20104
Queens 5666
Bronx 1091
Staten Island 373
Name: neighbourhood_group, dtype: int64airbnb["room_type"].value_counts(normalize=True).mul(100).round(1)Entire home/apt 52.0
Private room 45.7
Shared room 2.4
Name: room_type, dtype: float64fig, axes = plt.subplots(1, 2, figsize=(11, 4))
airbnb["neighbourhood_group"].value_counts().sort_values().plot.barh(
ax=axes[0], color="#0f6b78"
)
airbnb["room_type"].value_counts().sort_values().plot.barh(
ax=axes[1], color="#16826c"
)
axes[0].set(title="Anúncios por distrito", ylabel="")
axes[1].set(title="Anúncios por tipo", ylabel="")
plt.tight_layout()
plt.show()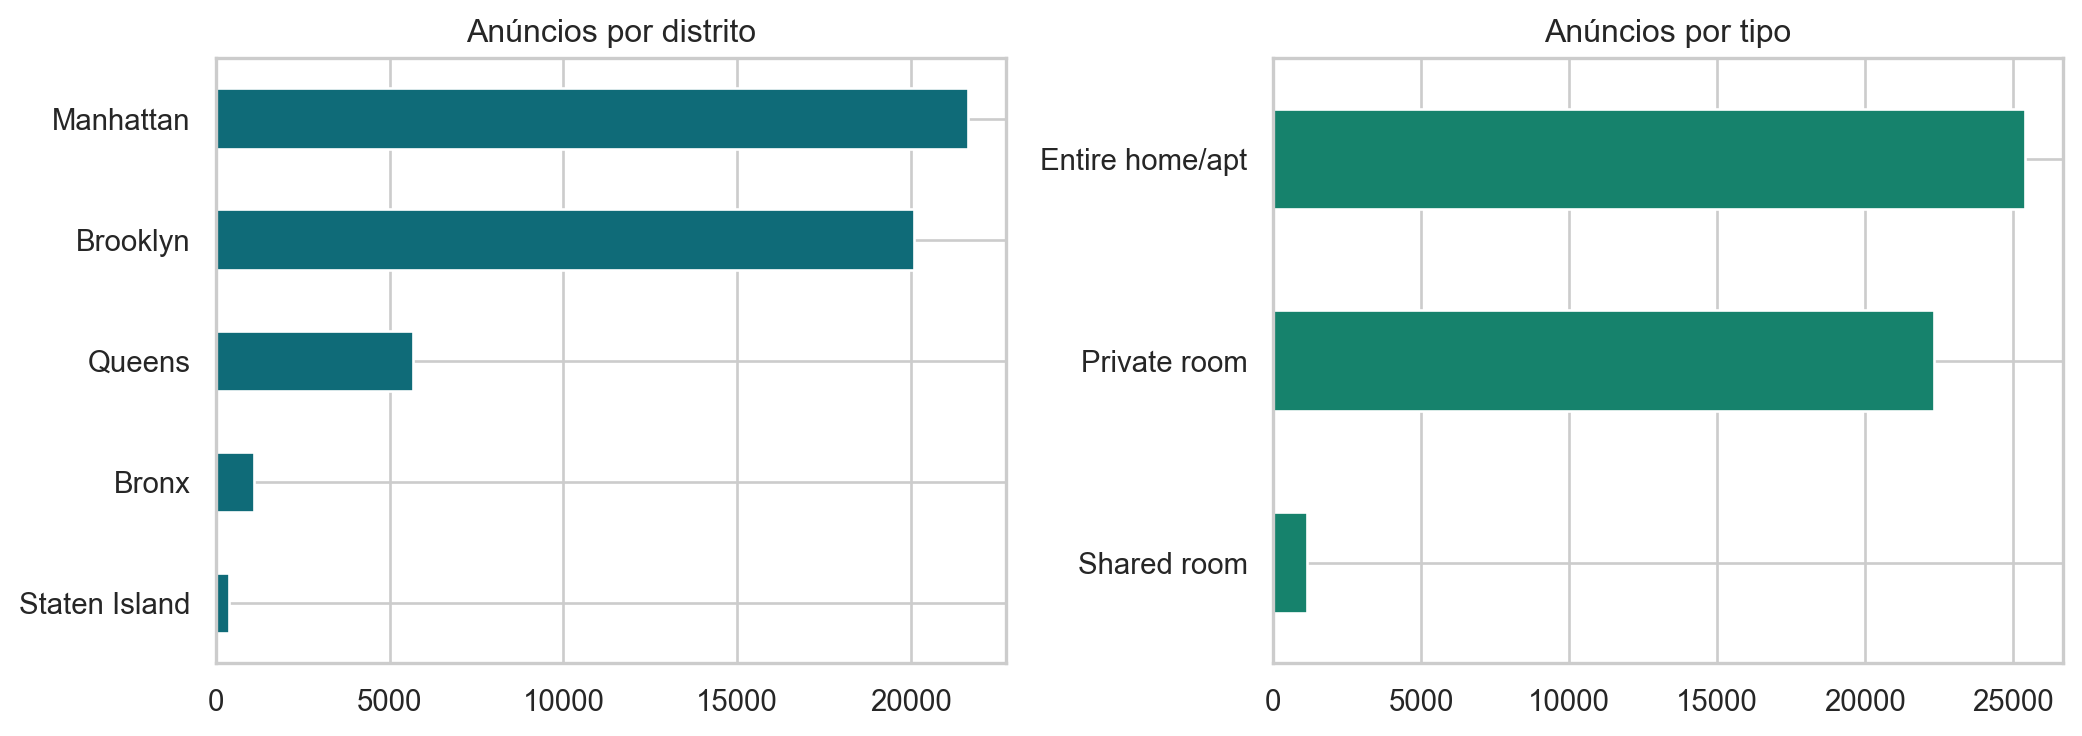
12. Groupby: dividir, aplicar e combinar
airbnb.groupby("room_type", observed=True)["price"].median()room_type
Private room 70.0
Entire home/apt 160.0
Shared room 45.0
Name: price, dtype: float64resumo_tipo = (
airbnb
.query("price > 0")
.groupby("room_type", observed=True)
.agg(
anuncios=("id", "size"),
preco_mediano=("price", "median"),
preco_medio=("price", "mean"),
disponibilidade_mediana=("availability_365", "median"),
)
.sort_values("preco_mediano", ascending=False)
)
resumo_tipo| anuncios | preco_mediano | preco_medio | disponibilidade_mediana | |
|---|---|---|---|---|
| room_type | ||||
| Entire home/apt | 25407 | 160.0 | 211.810918 | 42.0 |
| Private room | 22319 | 70.0 | 89.809131 | 45.0 |
| Shared room | 1158 | 45.0 | 70.248705 | 90.0 |
Observe como média e mediana diferem. Os valores extremos puxam a média para cima.
Duas categorias
medianas = (
    airbnb
    .query("price > 0")
    .groupby(["neighbourhood_group", "room_type"], observed=True)
    ["price"].median()
    .unstack()
)
medianas| room_type | Private room | Entire home/apt | Shared room |
|---|---|---|---|
| neighbourhood_group | |||
| Brooklyn | 65.0 | 145.0 | 36.0 |
| Manhattan | 90.0 | 191.0 | 69.0 |
| Queens | 60.0 | 120.0 | 37.0 |
| Staten Island | 50.0 | 100.0 | 30.0 |
| Bronx | 54.0 | 100.0 | 40.0 |
ax = medianas.plot.bar(figsize=(10, 5), color=["#0f6b78", "#d95f02", "#16826c"])
ax.set(title="Preço mediano por distrito e tipo", xlabel="", ylabel="US$ por noite")
ax.legend(title="tipo de acomodação", frameon=False)
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()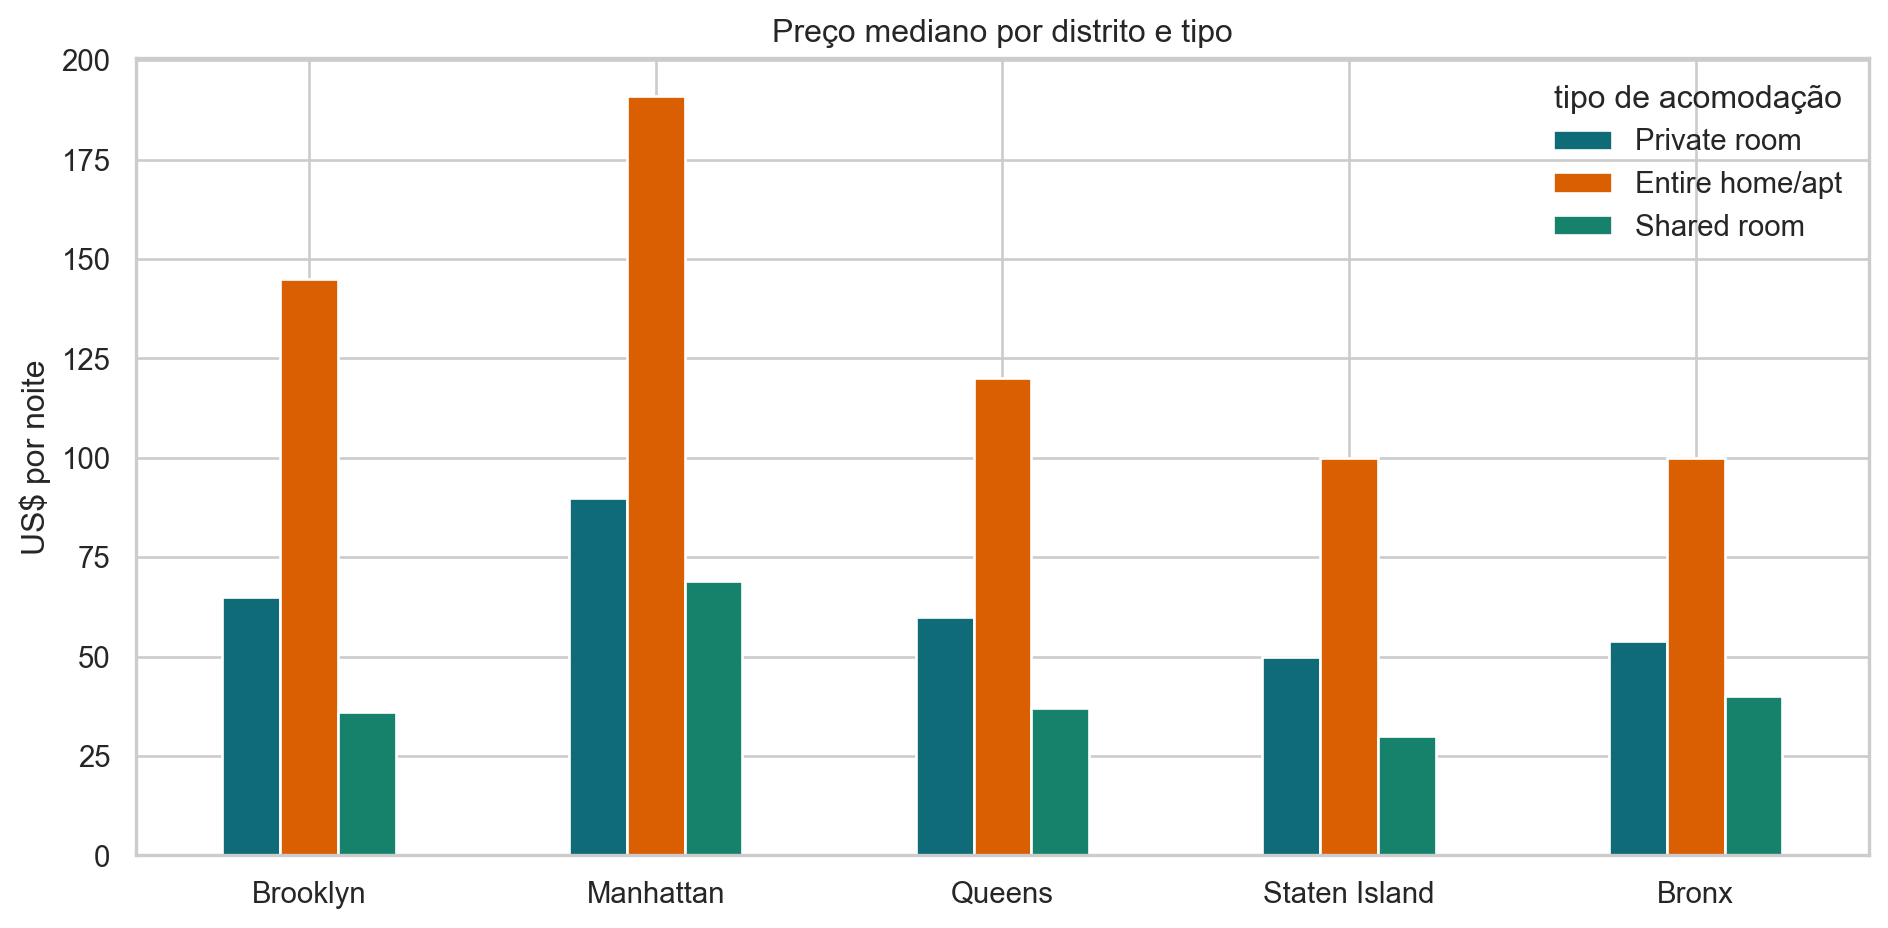
NotaInterpretação
Compare grupos usando a mesma definição de métrica e mostre também seus tamanhos. Diferenças aparentes podem refletir composição, cobertura ou poucos casos, e não apenas o fator usado no agrupamento.
13. Encadeamento documentado
resultado = (
    airbnb
    .query("price > 0 and price <= 500")
    .assign(
        reviewed=lambda d: d["number_of_reviews"].gt(0),
        recent_review=lambda d: d["last_review"].ge("2019-01-01"),
    )
    .groupby(["neighbourhood_group", "room_type"], observed=True)
    .agg(
        n=("id", "size"),
        median_price=("price", "median"),
        reviewed_share=("reviewed", "mean"),
        recent_share=("recent_review", "mean"),
    )
    .reset_index()
    .sort_values(["median_price", "n"], ascending=[False, False])
)
resultado.head(10)| neighbourhood_group | room_type | n | median_price | reviewed_share | recent_share | |
|---|---|---|---|---|---|---|
| 4 | Manhattan | Entire home/apt | 12523 | 185.0 | 0.763635 | 0.469376 |
| 1 | Brooklyn | Entire home/apt | 9367 | 144.0 | 0.856838 | 0.562613 |
| 7 | Queens | Entire home/apt | 2078 | 120.0 | 0.834456 | 0.640038 |
| 13 | Bronx | Entire home/apt | 376 | 100.0 | 0.819149 | 0.691489 |
| 10 | Staten Island | Entire home/apt | 170 | 100.0 | 0.876471 | 0.782353 |
| 3 | Manhattan | Private room | 7887 | 90.0 | 0.794345 | 0.492836 |
| 5 | Manhattan | Shared room | 477 | 69.0 | 0.742138 | 0.524109 |
| 0 | Brooklyn | Private room | 10089 | 64.0 | 0.789969 | 0.485975 |
| 6 | Queens | Private room | 3364 | 59.5 | 0.795184 | 0.596611 |
| 12 | Bronx | Private room | 648 | 53.0 | 0.807099 | 0.621914 |
Cada etapa corresponde a uma decisão: filtrar preços, criar indicadores, agrupar, agregar, recuperar colunas e ordenar.
14. Exercícios
Exercício A — tipos
Classifique minimum_nights, host_id, room_type, last_review e reviews_per_month em tipos computacionais e semânticos.
Exercício B — validação
Crie indicadores para:
minimum_nightsentre 1 e 365;reviews_per_monthnão negativo quando presente;availability_365entre 0 e 365.
# Escreva sua solução aqui.Exercício C — pergunta agrupada
Calcule, por distrito:
- número de anúncios;
- preço mediano entre US$ 1 e 500;
- proporção de anúncios com pelo menos uma avaliação.
# Escreva sua solução aqui.15. Respostas sugeridas
checks = airbnb.assign(
    valid_minimum_nights=airbnb["minimum_nights"].between(1, 365),
    valid_reviews_per_month=airbnb["reviews_per_month"].ge(0) |
                              airbnb["reviews_per_month"].isna(),
    valid_availability=airbnb["availability_365"].between(0, 365),
)

checks[["valid_minimum_nights", "valid_reviews_per_month",
        "valid_availability"]].mean()
valid_minimum_nights 0.999714
valid_reviews_per_month 1.000000
valid_availability 1.000000
dtype: float64resposta_c = (
airbnb
.query("0 < price <= 500")
.assign(reviewed=lambda d: d["number_of_reviews"].gt(0))
.groupby("neighbourhood_group", observed=True)
.agg(
anuncios=("id", "size"),
preco_mediano=("price", "median"),
proporcao_com_review=("reviewed", "mean"),
)
)
resposta_c| anuncios | preco_mediano | proporcao_com_review | |
|---|---|---|---|
| neighbourhood_group | |||
| Brooklyn | 19866 | 90.0 | 0.819692 |
| Manhattan | 20887 | 145.0 | 0.774740 |
| Queens | 5637 | 75.0 | 0.808764 |
| Staten Island | 367 | 75.0 | 0.852861 |
| Bronx | 1083 | 65.0 | 0.806094 |
16. Checklist final
Antes de analisar uma tabela, registre:
- unidade observacional e população-alvo;
- origem e processo de coleta;
- significado, unidade e tipo de cada coluna;
- ausências, duplicatas e regras de validade;
- filtros e transformações aplicados;
- limitações que permanecem.
Uma análise reprodutível não é apenas código que executa: é uma sequência de decisões que outra pessoa consegue compreender, verificar e questionar.
17. Função reutilizável de auditoria
Uma boa prática é transformar verificações recorrentes em uma função. Isso não substitui o conhecimento do domínio, mas reduz esquecimentos.
def audit_table(df, id_column=None):
    """Produz um diagnóstico compacto de uma tabela."""
    report = pd.DataFrame({
        "dtype": df.dtypes.astype(str),
        "missing_n": df.isna().sum(),
        "missing_pct": df.isna().mean().mul(100).round(2),
        "unique_n": df.nunique(dropna=True),
    })

    summary = {
        "rows": len(df),
        "columns": df.shape[1],
        "duplicate_rows": int(df.duplicated().sum()),
    }

    if id_column is not None:
        summary["duplicate_ids"] = int(df[id_column].duplicated().sum())
        summary["missing_ids"] = int(df[id_column].isna().sum())

    return summary, report.sort_values("missing_pct", ascending=False)


summary, column_report = audit_table(airbnb, id_column="id")
summary
{'rows': 48895,
'columns': 20,
'duplicate_rows': 0,
'duplicate_ids': 0,
'missing_ids': 0}column_report.head(10)| dtype | missing_n | missing_pct | unique_n | |
|---|---|---|---|---|
| review_month | Int64 | 10052 | 20.56 | 12 |
| review_year | Int64 | 10052 | 20.56 | 9 |
| reviews_per_month | float64 | 10052 | 20.56 | 937 |
| last_review | datetime64[ns] | 10052 | 20.56 | 1764 |
| host_name | object | 21 | 0.04 | 11452 |
| name | object | 16 | 0.03 | 47905 |
| id | int64 | 0 | 0.00 | 48895 |
| number_of_reviews | int64 | 0 | 0.00 | 394 |
| price_valid | bool | 0 | 0.00 | 2 |
| availability_365 | int64 | 0 | 0.00 | 366 |
Extensão
Modifique audit_table para receber um dicionário de intervalos válidos, por exemplo {"availability_365": (0, 365), "price": (0, 10_000)}, e contar violações.
18. Tabelas cruzadas e proporções condicionais
Uma contagem simples pode esconder que grupos têm tamanhos muito diferentes.
counts = pd.crosstab(
    airbnb["neighbourhood_group"],
    airbnb["room_type"],
)
counts| room_type | Entire home/apt | Private room | Shared room |
|---|---|---|---|
| neighbourhood_group | |||
| Bronx | 379 | 652 | 60 |
| Brooklyn | 9559 | 10132 | 413 |
| Manhattan | 13199 | 7982 | 480 |
| Queens | 2096 | 3372 | 198 |
| Staten Island | 176 | 188 | 9 |
Agora normalizamos cada linha para responder: “dentro de cada distrito, qual é a composição por tipo de acomodação?”.
row_percent = pd.crosstab(
    airbnb["neighbourhood_group"],
    airbnb["room_type"],
    normalize="index",
).mul(100).round(1)
row_percent| room_type | Entire home/apt | Private room | Shared room |
|---|---|---|---|
| neighbourhood_group | |||
| Bronx | 34.7 | 59.8 | 5.5 |
| Brooklyn | 47.5 | 50.4 | 2.1 |
| Manhattan | 60.9 | 36.8 | 2.2 |
| Queens | 37.0 | 59.5 | 3.5 |
| Staten Island | 47.2 | 50.4 | 2.4 |
ax = row_percent.plot.bar(
    stacked=True,
    figsize=(10, 4.8),
    color=["#0f6b78", "#d95f02", "#16826c"],
)
ax.set(title="Composição dos anúncios dentro de cada distrito",
       xlabel="", ylabel="percentual")
ax.legend(title="tipo", bbox_to_anchor=(1.02, 1), frameon=False)
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()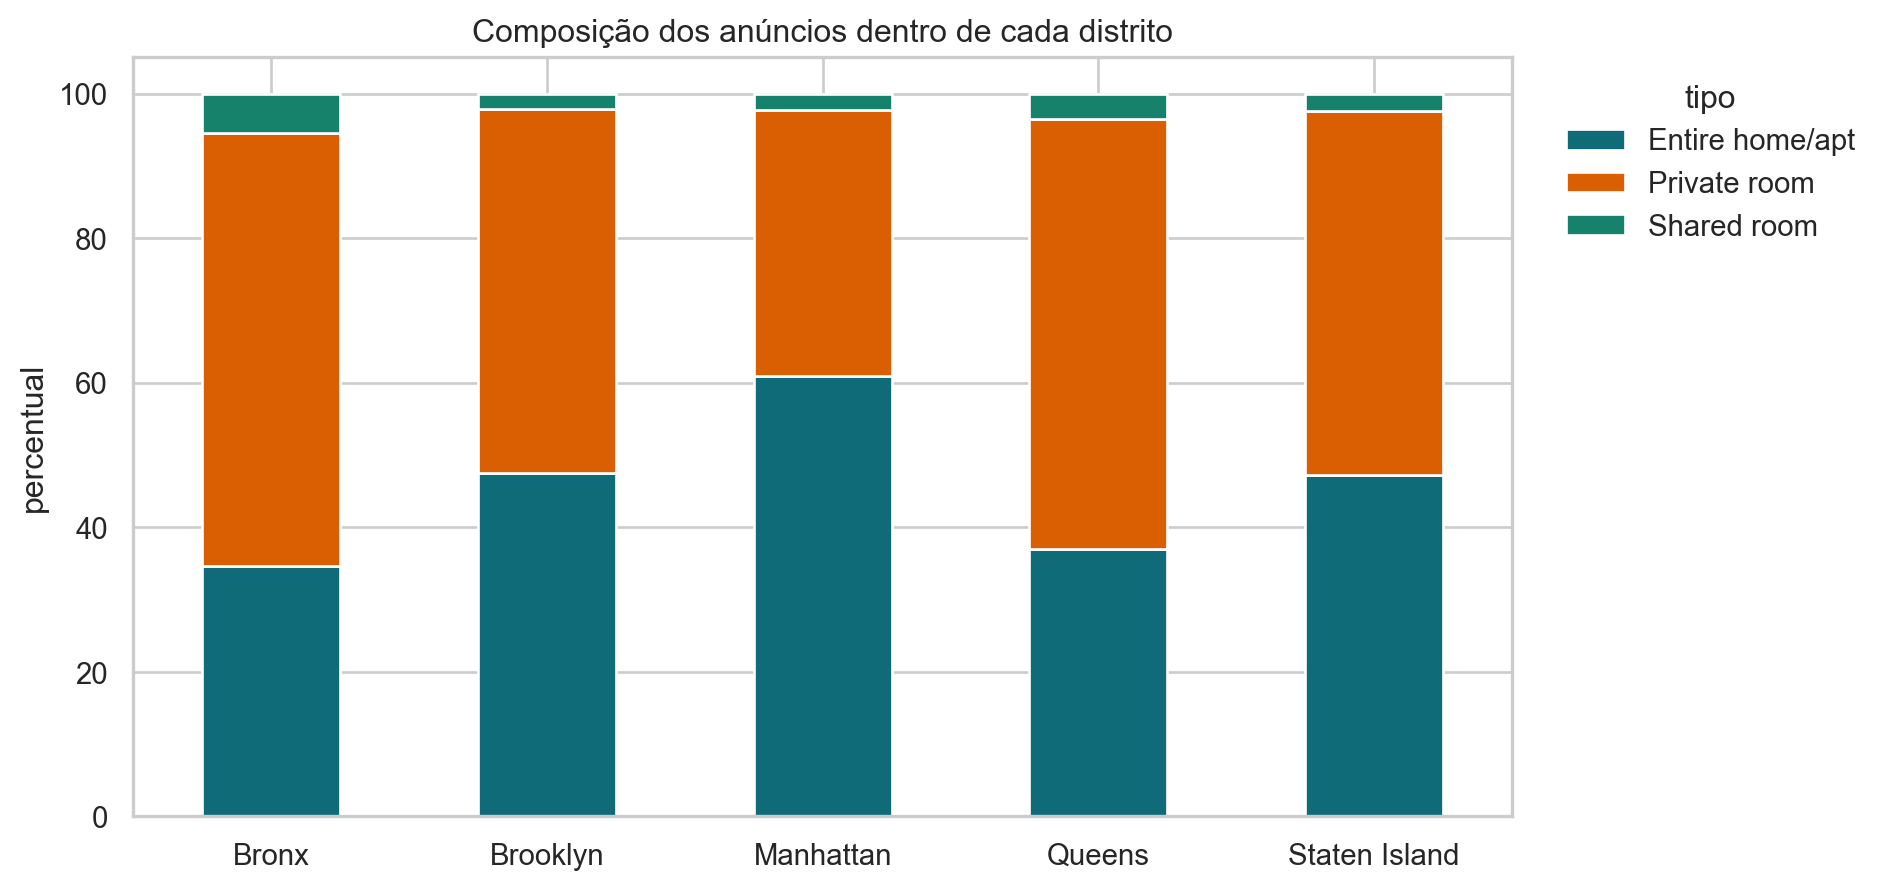
Cuidado com o denominador
normalize="index": percentual dentro de cada linha;normalize="columns": percentual dentro de cada coluna;normalize="all": percentual do total da tabela.
Sempre declare qual denominador gera a porcentagem.
19. Índices hierárquicos e reshape
Agrupar por duas colunas produz um índice com dois níveis.
grouped = (
    airbnb
    .query("price > 0")
    .groupby(["neighbourhood_group", "room_type"], observed=True)
    ["price"].median()
)
grouped.head(8)
neighbourhood_group room_type
Brooklyn Private room 65.0
Entire home/apt 145.0
Shared room 36.0
Manhattan Private room 90.0
Entire home/apt 191.0
Shared room 69.0
Queens Private room 60.0
Entire home/apt 120.0
Name: price, dtype: float64unstack move um nível do índice para as colunas.
wide = grouped.unstack("room_type")
wide| room_type | Private room | Entire home/apt | Shared room |
|---|---|---|---|
| neighbourhood_group | |||
| Brooklyn | 65.0 | 145.0 | 36.0 |
| Manhattan | 90.0 | 191.0 | 69.0 |
| Queens | 60.0 | 120.0 | 37.0 |
| Staten Island | 50.0 | 100.0 | 30.0 |
| Bronx | 54.0 | 100.0 | 40.0 |
stack faz o caminho inverso.
wide.stack().head(8)neighbourhood_group room_type
Brooklyn Private room 65.0
Entire home/apt 145.0
Shared room 36.0
Manhattan Private room 90.0
Entire home/apt 191.0
Shared room 69.0
Queens Private room 60.0
Entire home/apt 120.0
dtype: float64Formato largo e formato longo
- Largo: uma coluna para cada tipo de acomodação; útil para leitura humana.
- Longo: uma linha para cada combinação; útil para gráficos e modelagem.
long = wide.reset_index().melt(
    id_vars="neighbourhood_group",
    var_name="room_type",
    value_name="median_price",
)
long.head()| neighbourhood_group | room_type | median_price | |
|---|---|---|---|
| 0 | Brooklyn | Private room | 65.0 |
| 1 | Manhattan | Private room | 90.0 |
| 2 | Queens | Private room | 60.0 |
| 3 | Staten Island | Private room | 50.0 |
| 4 | Bronx | Private room | 54.0 |
NotaInterpretação
O formato longo facilita operações por grupo e gráficos com uma variável de categoria; o formato largo favorece comparações tabulares. A transformação muda a organização, não a informação substantiva.
20. Depuração de erros frequentes
Erro 1 — usar and em Series
Este código falha:
airbnb[(airbnb["price"] > 0) and (airbnb["price"] <= 500)]Use & e parênteses:
airbnb[(airbnb["price"] > 0) & (airbnb["price"] <= 500)].shape(47840, 20)Erro 2 — selecionar Series quando esperava DataFrame
type(airbnb["price"]), type(airbnb[["price"]])(pandas.core.series.Series, pandas.core.frame.DataFrame)Erro 3 — ordenar sem guardar o resultado
Muitos métodos retornam um novo objeto.
sorted_prices = airbnb.sort_values("price", ascending=False)
sorted_prices[["id", "price"]].head()| id | price | |
|---|---|---|
| 9151 | 7003697 | 10000 |
| 17692 | 13894339 | 10000 |
| 29238 | 22436899 | 10000 |
| 40433 | 31340283 | 9999 |
| 12342 | 9528920 | 9999 |
Erro 4 — converter datas silenciosamente
errors="coerce" transforma datas inválidas em NaT. Sempre conte quantos valores foram perdidos durante a conversão.
raw_dates = pd.read_csv(DATA, usecols=["last_review"])["last_review"]
parsed_dates = pd.to_datetime(raw_dates, errors="coerce")

pd.Series({
    "ausentes antes": raw_dates.isna().sum(),
    "ausentes depois": parsed_dates.isna().sum(),
})
ausentes antes 10052
ausentes depois 10052
dtype: int6421. Miniestudo guiado
Pergunta
Entre anúncios com preço entre US$ 1 e 500, como preço e disponibilidade variam entre distritos e tipos de acomodação?
Plano
- Definir a unidade: anúncio.
- Declarar o filtro de validade do preço.
- Descrever tamanhos dos grupos.
- Comparar medianas, não apenas médias.
- Visualizar a distribuição.
- Comunicar limitações.
study = (
    airbnb
    .query("1 <= price <= 500")
    .dropna(subset=["neighbourhood_group", "room_type"])
    .copy()
)

study.shape
(47840, 20)study_summary = (
study
.groupby(["neighbourhood_group", "room_type"], observed=True)
.agg(
n=("id", "size"),
median_price=("price", "median"),
q1_price=("price", lambda x: x.quantile(.25)),
q3_price=("price", lambda x: x.quantile(.75)),
median_availability=("availability_365", "median"),
)
.reset_index()
)
study_summary.head(10)| neighbourhood_group | room_type | n | median_price | q1_price | q3_price | median_availability | |
|---|---|---|---|---|---|---|---|
| 0 | Brooklyn | Private room | 10089 | 64.0 | 50.0 | 80.00 | 24.0 |
| 1 | Brooklyn | Entire home/apt | 9367 | 144.0 | 102.0 | 195.00 | 26.0 |
| 2 | Brooklyn | Shared room | 410 | 36.0 | 30.0 | 49.75 | 156.5 |
| 3 | Manhattan | Private room | 7887 | 90.0 | 67.0 | 120.00 | 28.0 |
| 4 | Manhattan | Entire home/apt | 12523 | 185.0 | 140.0 | 250.00 | 35.0 |
| 5 | Manhattan | Shared room | 477 | 69.0 | 49.0 | 85.00 | 81.0 |
| 6 | Queens | Private room | 3364 | 59.5 | 47.0 | 75.00 | 108.5 |
| 7 | Queens | Entire home/apt | 2078 | 120.0 | 90.0 | 165.00 | 87.5 |
| 8 | Queens | Shared room | 195 | 37.0 | 30.0 | 50.50 | 179.0 |
| 9 | Staten Island | Private room | 188 | 50.0 | 40.0 | 75.00 | 282.0 |
fig, ax = plt.subplots(figsize=(11, 5))
sns.boxplot(
    data=study,
    x="neighbourhood_group",
    y="price",
    hue="room_type",
    showfliers=False,
    ax=ax,
)
ax.set(title="Preço por distrito e tipo — outliers ocultados apenas na visualização",
       xlabel="", ylabel="US$ por noite")
ax.legend(title="tipo", frameon=False)
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()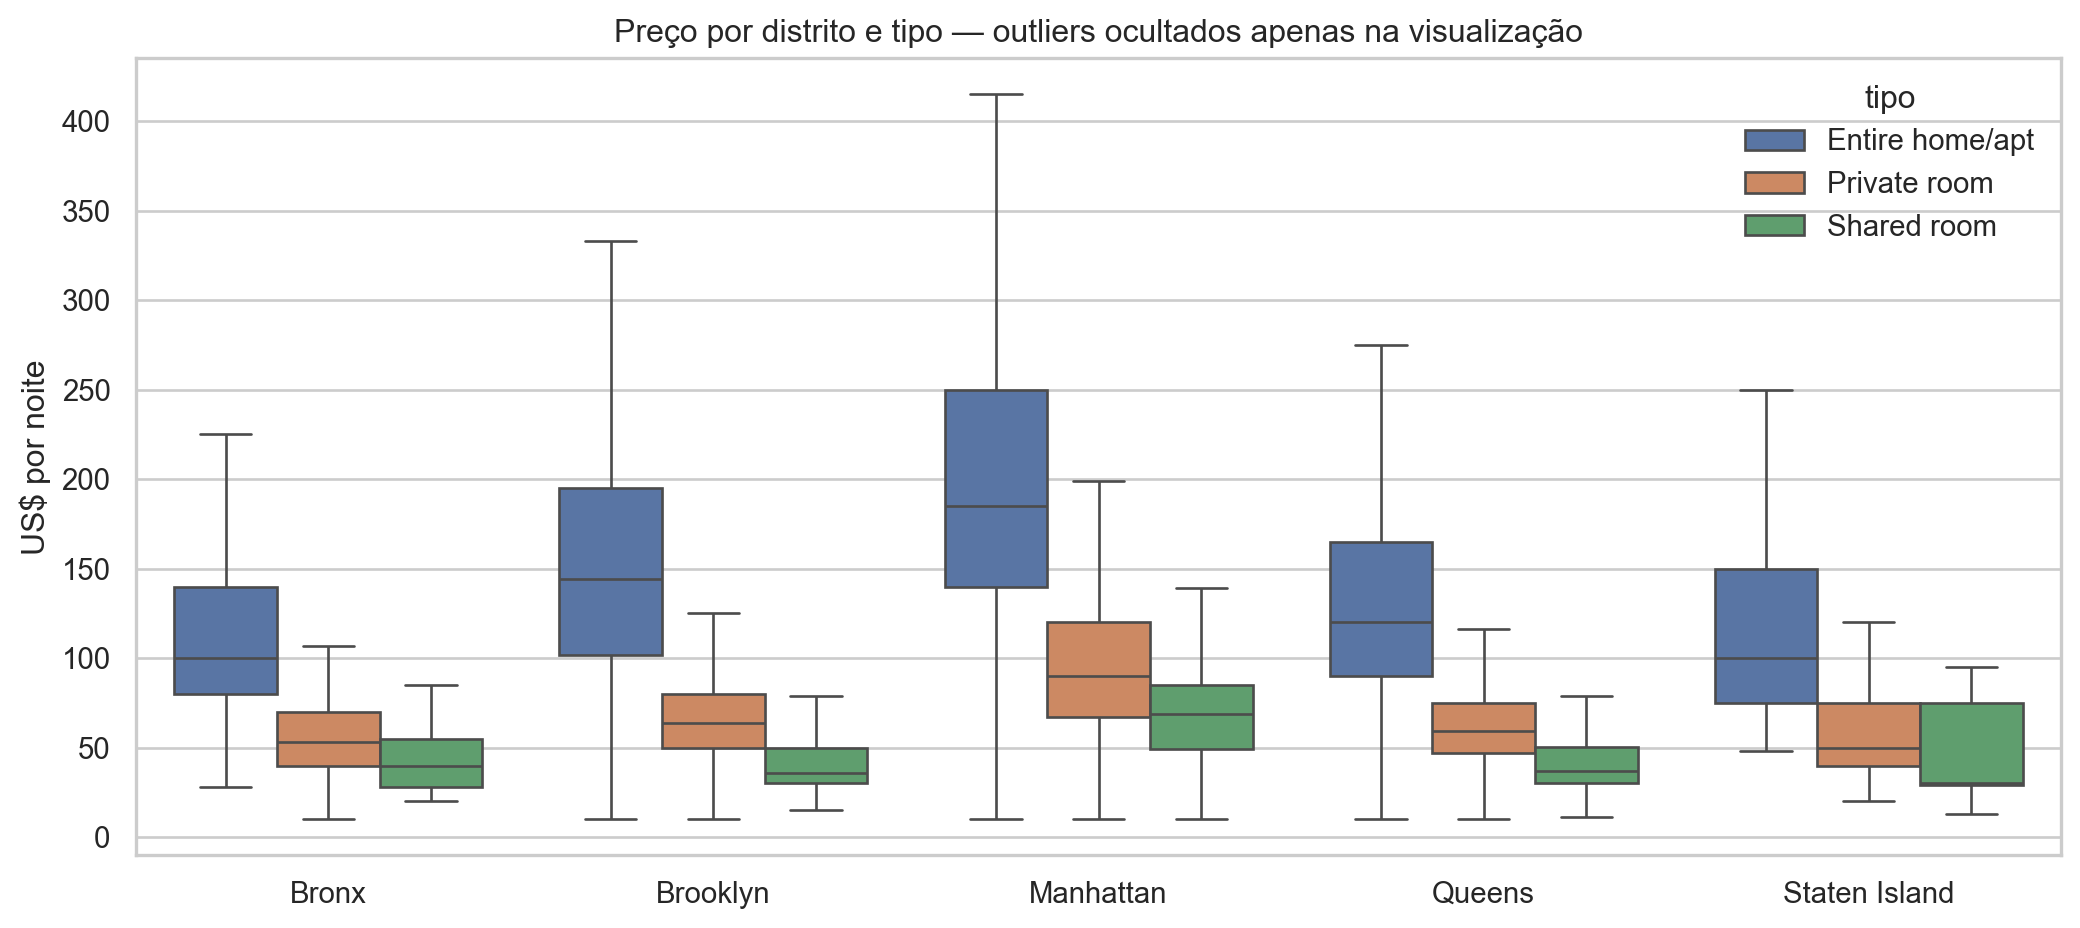
Interpretação responsável
- Manhattan apresenta preços anunciados maiores em vários tipos.
- Apartamentos/casas inteiros tendem a custar mais que quartos privados.
- O gráfico descreve anúncios publicados, não preços efetivamente pagos.
- Ausência de ocupação e características do imóvel impede explicar causalmente as diferenças.
22. Desafios adicionais
- Encontre os cinco bairros com mais anúncios, mas exija pelo menos 100 linhas.
- Compare média e mediana do preço em cada tipo de acomodação.
- Calcule a proporção de anúncios sem avaliação por distrito.
- Crie uma coluna
availability_bandcom faixas0,1–90,91–180,181–365dias. - Investigue anfitriões com muitos anúncios usando
calculated_host_listings_count. - Refaça o miniestudo usando somente anúncios com avaliação em 2019 e discuta como o filtro muda a população analisada.
23. Leituras adicionais
Guia teórico consolidado
Dados são produzidos por um processo
Uma tabela não é a realidade: é o resultado de decisões sobre quem observar, o que medir, quando registrar e como codificar. Antes de calcular qualquer resumo, identifique:
- unidade observacional: o que uma linha representa;
- população-alvo: sobre quem desejamos concluir;
- quadro amostral: quem poderia efetivamente aparecer na coleta;
- amostra: quem de fato apareceu;
- mecanismo de seleção: como as unidades entraram na base.
Amostragem aleatória simples, estratificada, por conglomerados e sistemática são desenhos probabilísticos distintos. Uma base disponibilizada por uma plataforma, como o Airbnb, normalmente combina seleção dos anfitriões, decisões comerciais e filtros administrativos; ela não deve ser tratada automaticamente como amostra aleatória de todas as acomodações da cidade.
Tipo de armazenamento não é significado
O tipo técnico de uma coluna (int, float, string, datetime) não determina seu papel analítico. Um CEP pode ser armazenado como número, mas é um identificador; uma avaliação de 1 a 5 é numérica no arquivo, mas possui interpretação ordinal.
- categórico nominal: categorias sem ordem natural;
- categórico ordinal: categorias com ordem, mas sem distâncias necessariamente iguais;
- numérico discreto: contagens;
- numérico contínuo: medidas em uma escala contínua;
- identificador: distingue unidades, mas não mede magnitude;
- data/hora: carrega ordem, duração, sazonalidade e fuso;
- texto: exige representação adequada ao objetivo.
Escolher o tipo semântico errado produz operações sem sentido, como calcular a média de códigos postais.
Ausência, duplicação e validade
Um valor ausente pode significar “não medido”, “não aplicável”, “recusado” ou “perdido”. Substituí-lo por zero altera o significado. Da mesma forma, duplicata depende da chave: duas linhas iguais podem ser erro, mas duas linhas do mesmo hóspede podem representar reservas diferentes.
Uma regra de validade combina domínio e contexto: preço deve ser não negativo, latitude deve estar no intervalo geográfico plausível e identificadores que deveriam ser únicos precisam ser testados como tal.
Por que groupby funciona
O padrão dividir–aplicar–combinar separa a tabela em grupos, aplica uma função a cada subconjunto e reúne os resultados. A unidade da tabela resultante muda: depois de agrupar por bairro, uma linha passa a representar um bairro, não um anúncio. Toda agregação perde detalhes; por isso, visualize os dados individuais antes de resumir e declare a nova unidade observacional.