from pathlib import Path

import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

sns.set_theme(style="whitegrid", context="notebook")
pd.set_option("display.max_columns", 30)
pd.set_option("display.float_format", lambda x: f"{x:,.2f}")Aula 04 — Análise Exploratória com a Olist
Estrutura, granularidade, escopo, temporalidade e corretude
Objetivos
Este material desenvolve uma auditoria exploratória completa de uma base relacional. Ao final, você deverá conseguir:
- identificar a unidade de observação de cada tabela;
- verificar chaves e cardinalidades;
- realizar
mergesem multiplicar observações indevidamente; - interpretar ausências à luz do processo de geração dos dados;
- avaliar escopo, temporalidade e regras de validade;
- produzir uma análise descritiva reproduzível.
Como estudar este capítulo
Análise exploratória não é uma lista automática de gráficos. É uma investigação sobre como os dados foram produzidos, organizados e conectados. Na Olist, um pedido pode ter vários itens e vários pagamentos; portanto, juntar tabelas sem compreender suas granularidades pode multiplicar linhas e alterar totais silenciosamente.
O capítulo constrói uma tabela analítica sem perder o vínculo com as tabelas originais. Primeiro identificamos a unidade de cada arquivo e suas chaves. Depois verificamos cardinalidades, agregamos relações um-para-muitos e validamos os merge. Só então estudamos tempo, ausências, valores extremos e relações entre variáveis.
Em cada etapa, registre uma pequena conclusão: o que uma linha representa antes e depois da transformação, quais linhas podem desaparecer ou se repetir e como verificar que os totais continuam coerentes. Essa prática transforma o notebook em uma auditoria reproduzível, e não apenas em código que “rodou sem erro”.
A base Olist
O conjunto original, publicado pela Olist no Kaggle, descreve aproximadamente 100 mil pedidos feitos em marketplaces brasileiros entre 2016 e 2018. Ele possui tabelas separadas para pedidos, clientes, itens, pagamentos, produtos, vendedores e avaliações.
Neste notebook usamos uma amostra reprodutível de 20 mil pedidos e todas as linhas relacionadas a eles. Isso mantém o notebook leve sem eliminar o principal desafio: cada tabela possui uma granularidade diferente.
Fonte: https://www.kaggle.com/datasets/olistbr/brazilian-ecommerce
Preparação
DATA = next(path for path in [
    Path("data"),
    Path("exemplos/04-eda-olist/data"),
] if path.exists())

DATAPosixPath('data')Leitura das cinco tabelas
orders = pd.read_csv(DATA / "orders.csv")
customers = pd.read_csv(DATA / "customers.csv")
items = pd.read_csv(DATA / "order_items.csv")
payments = pd.read_csv(DATA / "order_payments.csv")
reviews = pd.read_csv(DATA / "order_reviews.csv")
tables = {
"orders": orders,
"customers": customers,
"items": items,
"payments": payments,
"reviews": reviews,
}
pd.DataFrame({
"linhas": {name: len(df) for name, df in tables.items()},
"colunas": {name: df.shape[1] for name, df in tables.items()},
})| linhas | colunas | |
|---|---|---|
| orders | 20000 | 8 |
| customers | 20000 | 5 |
| items | 22735 | 7 |
| payments | 20979 | 5 |
| reviews | 19921 | 7 |
NotaInterpretação
Antes de interpretar resultados, confirme o que cada linha representa, o período coberto e as colunas realmente disponíveis. Essa definição determina quais agregações e comparações são válidas.
Dicionário mínimo
| tabela | unidade de observação | colunas centrais |
|---|---|---|
orders |
pedido | status e cinco datas do ciclo do pedido |
customers |
identificador de cliente associado a um pedido | cidade, estado e identificador persistente |
items |
item numerado dentro de um pedido | produto, vendedor, preço e frete |
payments |
parcela ou forma de pagamento | tipo, prestações e valor |
reviews |
avaliação registrada | nota, comentário e datas |
Primeira inspeção
orders.head(3)| order_id | customer_id | order_status | order_purchase_timestamp | order_approved_at | order_delivered_carrier_date | order_delivered_customer_date | order_estimated_delivery_date | |
|---|---|---|---|---|---|---|---|---|
| 0 | b9a6c5f5df52c7226ac85aee7524c27f | f160aaf480efdfa7268f0fa535f73e76 | delivered | 2018-06-12 20:07:44 | 2018-06-12 20:44:26 | 2018-06-13 13:09:00 | 2018-06-19 12:44:08 | 2018-07-17 00:00:00 |
| 1 | 261e71d2349c713eafa9f3df5972b95d | d6708bbbd2d419475869a84e41f620a1 | delivered | 2018-01-20 12:15:57 | 2018-01-20 12:37:13 | 2018-01-25 21:42:52 | 2018-01-30 11:32:35 | 2018-02-15 00:00:00 |
| 2 | 67b50899f52995848c427e361e10dde3 | 1b353c00c71689afba44554e43cc5a76 | delivered | 2018-06-16 21:24:10 | 2018-06-16 21:36:59 | 2018-06-21 13:55:00 | 2018-06-27 13:17:27 | 2018-07-16 00:00:00 |
orders.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 20000 entries, 0 to 19999
Data columns (total 8 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 order_id 20000 non-null object
1 customer_id 20000 non-null object
2 order_status 20000 non-null object
3 order_purchase_timestamp 20000 non-null object
4 order_approved_at 19963 non-null object
5 order_delivered_carrier_date 19621 non-null object
6 order_delivered_customer_date 19394 non-null object
7 order_estimated_delivery_date 20000 non-null object
dtypes: object(8)
memory usage: 1.2+ MBorders.describe(include="all").T| count | unique | top | freq | |
|---|---|---|---|---|
| order_id | 20000 | 20000 | b9a6c5f5df52c7226ac85aee7524c27f | 1 |
| customer_id | 20000 | 20000 | f160aaf480efdfa7268f0fa535f73e76 | 1 |
| order_status | 20000 | 7 | delivered | 19396 |
| order_purchase_timestamp | 20000 | 19974 | 2018-03-16 07:01:56 | 2 |
| order_approved_at | 19963 | 19540 | 2018-02-27 04:31:10 | 4 |
| order_delivered_carrier_date | 19621 | 18595 | 2018-05-09 15:48:00 | 12 |
| order_delivered_customer_date | 19394 | 19358 | 2017-05-18 11:07:45 | 2 |
| order_estimated_delivery_date | 20000 | 431 | 2018-02-06 00:00:00 | 118 |
Função reutilizável de auditoria
def audit_table(df, keys=None):
    result = pd.DataFrame({
        "dtype": df.dtypes.astype(str),
        "missing": df.isna().sum(),
        "missing_pct": df.isna().mean().mul(100).round(2),
        "unique": df.nunique(dropna=True),
    })
    if keys:
        print("duplicatas pela chave:", df.duplicated(keys).sum())
    return result.sort_values("missing", ascending=False)
audit_table(orders, ["order_id"])duplicatas pela chave: 0| dtype | missing | missing_pct | unique | |
|---|---|---|---|---|
| order_delivered_customer_date | object | 606 | 3.03 | 19358 |
| order_delivered_carrier_date | object | 379 | 1.90 | 18595 |
| order_approved_at | object | 37 | 0.18 | 19540 |
| order_id | object | 0 | 0.00 | 20000 |
| customer_id | object | 0 | 0.00 | 20000 |
| order_status | object | 0 | 0.00 | 7 |
| order_purchase_timestamp | object | 0 | 0.00 | 19974 |
| order_estimated_delivery_date | object | 0 | 0.00 | 431 |
Granularidade e chaves
Uma chave candidata deve ser única na granularidade declarada.
key_tests = pd.Series({
    "orders.order_id": orders["order_id"].is_unique,
    "customers.customer_id": customers["customer_id"].is_unique,
    "items.order_id": items["order_id"].is_unique,
    "items.(order_id, order_item_id)": ~items.duplicated(["order_id", "order_item_id"]).any(),
    "payments.(order_id, payment_sequential)": ~payments.duplicated(["order_id", "payment_sequential"]).any(),
    "reviews.review_id": reviews["review_id"].is_unique,
})
key_tests
orders.order_id True
customers.customer_id True
items.order_id False
items.(order_id, order_item_id) True
payments.(order_id, payment_sequential) True
reviews.review_id False
dtype: boolQuantas linhas existem por pedido?
items_per_order = items.groupby("order_id").size()
payments_per_order = payments.groupby("order_id").size()
reviews_per_order = reviews.groupby("order_id").size()

pd.DataFrame({
    "itens": items_per_order.describe(),
    "pagamentos": payments_per_order.describe(),
    "avaliações": reviews_per_order.describe(),
})| itens | pagamentos | avaliações | |
|---|---|---|---|
| count | 19,832.00 | 19,999.00 | 19,827.00 |
| mean | 1.15 | 1.05 | 1.00 |
| std | 0.56 | 0.42 | 0.07 |
| min | 1.00 | 1.00 | 1.00 |
| 25% | 1.00 | 1.00 | 1.00 |
| 50% | 1.00 | 1.00 | 1.00 |
| 75% | 1.00 | 1.00 | 1.00 |
| max | 21.00 | 22.00 | 3.00 |
fig, axes = plt.subplots(1, 3, figsize=(14, 3.5))
for ax, values, title in [
    (axes[0], items_per_order, "Itens"),
    (axes[1], payments_per_order, "Pagamentos"),
    (axes[2], reviews_per_order, "Avaliações"),
]:
    sns.countplot(x=values.clip(upper=5), ax=ax, color="#0f6b78")
    ax.set_title(title)
    ax.set_xlabel("linhas por pedido (5 = cinco ou mais)")
plt.tight_layout()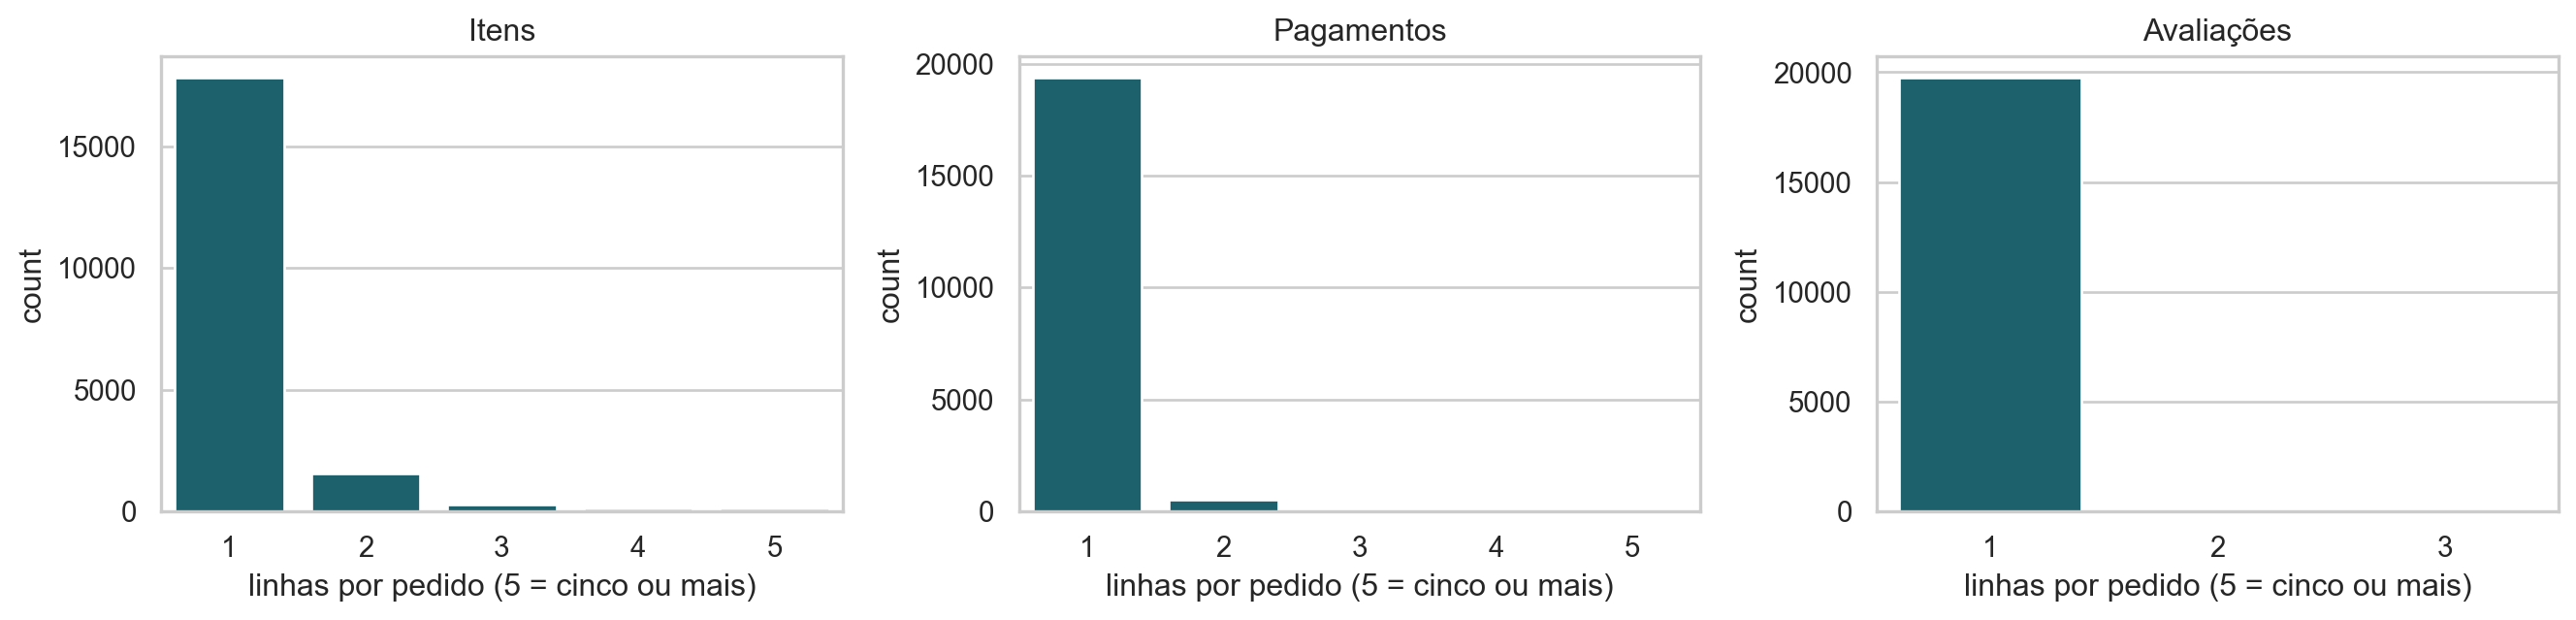
NotaInterpretação
A chave e a cardinalidade do relacionamento definem a granularidade resultante. Agregue tabelas de itens ou pagamentos antes do merge quando a pergunta exige uma linha por pedido; depois valide se a contagem de pedidos foi preservada.
Por que o merge ingênuo é perigoso?
naive = orders.merge(items, on="order_id", how="inner")
orders.shape, naive.shape
((20000, 8), (22735, 14))O merge não está tecnicamente errado. Ele apenas muda a unidade de observação: cada linha passa a ser um item do pedido.
naive["order_id"].nunique(), len(naive)(19832, 22735)O erro de contagem
true_orders = orders["order_id"].nunique()
rows_after_merge = len(naive)

pd.Series({
    "pedidos únicos": true_orders,
    "linhas após merge": rows_after_merge,
    "excesso de contagem": rows_after_merge - true_orders,
})
pedidos únicos 20000
linhas após merge 22735
excesso de contagem 2735
dtype: int64
NotaInterpretação
Contar linhas após um relacionamento um-para-muitos superestima pedidos. Conte identificadores únicos ou reconstrua previamente a tabela na unidade observacional da pergunta.
Agregando itens na granularidade de pedido
item_agg = (
    items.groupby("order_id")
    .agg(
        itens=("order_item_id", "size"),
        valor_produtos=("price", "sum"),
        frete=("freight_value", "sum"),
        vendedores=("seller_id", "nunique"),
    )
    .reset_index()
)

item_agg.head()| order_id | itens | valor_produtos | frete | vendedores | |
|---|---|---|---|---|---|
| 0 | 000229ec398224ef6ca0657da4fc703e | 1 | 199.00 | 17.87 | 1 |
| 1 | 00024acbcdf0a6daa1e931b038114c75 | 1 | 12.99 | 12.79 | 1 |
| 2 | 000aed2e25dbad2f9ddb70584c5a2ded | 1 | 144.00 | 8.77 | 1 |
| 3 | 00130c0eee84a3d909e75bc08c5c3ca1 | 1 | 27.90 | 7.94 | 1 |
| 4 | 001ac194d4a326a6fa99b581e9a3d963 | 1 | 54.00 | 8.54 | 1 |
item_agg["order_id"].is_unique, item_agg.shape(True, (19832, 5))Agregando pagamentos e avaliações
payment_agg = (
    payments.groupby("order_id")
    .agg(
        valor_pago=("payment_value", "sum"),
        parcelas_max=("payment_installments", "max"),
        formas_pagamento=("payment_type", "nunique"),
    )
    .reset_index()
)
review_agg = (
reviews.groupby("order_id")
.agg(
nota=("review_score", "mean"),
n_reviews=("review_id", "size"),
tem_comentario=("review_comment_message", lambda x: x.notna().any()),
)
.reset_index()
)Merge com validação explícita
analysis = (
    orders
    .merge(customers, on="customer_id", how="left", validate="many_to_one")
    .merge(item_agg, on="order_id", how="left", validate="one_to_one")
    .merge(payment_agg, on="order_id", how="left", validate="one_to_one")
    .merge(review_agg, on="order_id", how="left", validate="one_to_one")
)

analysis.shape
(20000, 22)assert len(analysis) == len(orders)
assert analysis["order_id"].is_uniqueVerificando reconciliação financeira
O valor pago inclui produtos e frete, mas pode conter diferenças ligadas a descontos ou regras comerciais. A comparação é uma auditoria, não uma igualdade garantida.
analysis["valor_esperado"] = analysis["valor_produtos"] + analysis["frete"]
analysis["diferenca_pagamento"] = analysis["valor_pago"] - analysis["valor_esperado"]
analysis["diferenca_pagamento"].describe()
count 19,831.00
mean 0.03
std 1.54
min -10.39
25% 0.00
50% 0.00
75% 0.00
max 182.81
Name: diferenca_pagamento, dtype: float64
NotaInterpretação
A reconciliação compara totais calculados por caminhos independentes. Diferenças inesperadas indicam duplicação no merge, pagamentos parcelados não agregados ou filtros aplicados de maneira inconsistente.
Conversão das datas
date_cols = [
    "order_purchase_timestamp",
    "order_approved_at",
    "order_delivered_carrier_date",
    "order_delivered_customer_date",
    "order_estimated_delivery_date",
]

analysis[date_cols] = analysis[date_cols].apply(pd.to_datetime)analysis[date_cols].agg(["min", "max"])| order_purchase_timestamp | order_approved_at | order_delivered_carrier_date | order_delivered_customer_date | order_estimated_delivery_date | |
|---|---|---|---|---|---|
| min | 2016-09-15 12:16:38 | 2016-09-15 12:16:38 | 2016-10-08 14:46:49 | 2016-10-11 14:46:49 | 2016-10-04 |
| max | 2018-10-03 18:55:29 | 2018-08-29 14:30:23 | 2018-08-31 15:09:00 | 2018-09-19 15:46:39 | 2018-10-23 |
Variáveis temporais derivadas
analysis = analysis.assign(
    entrega_dias=lambda d: (
        d.order_delivered_customer_date - d.order_purchase_timestamp
    ).dt.total_seconds() / 86400,
    atraso_dias=lambda d: (
        d.order_delivered_customer_date - d.order_estimated_delivery_date
    ).dt.total_seconds() / 86400,
    mes=lambda d: d.order_purchase_timestamp.dt.to_period("M").astype(str),
)
analysis["atrasou"] = analysis["atraso_dias"].gt(0)
Escopo temporal
monthly = analysis.groupby("mes").size()
monthly.tail(8)
mes
2018-03 1484
2018-04 1338
2018-05 1434
2018-06 1241
2018-07 1272
2018-08 1274
2018-09 1
2018-10 2
dtype: int64monthly.plot(figsize=(11, 4), color="#0f6b78", linewidth=2.5)
plt.title("Pedidos por mês")
plt.xlabel("")
plt.ylabel("pedidos")
plt.xticks(rotation=45)
plt.tight_layout()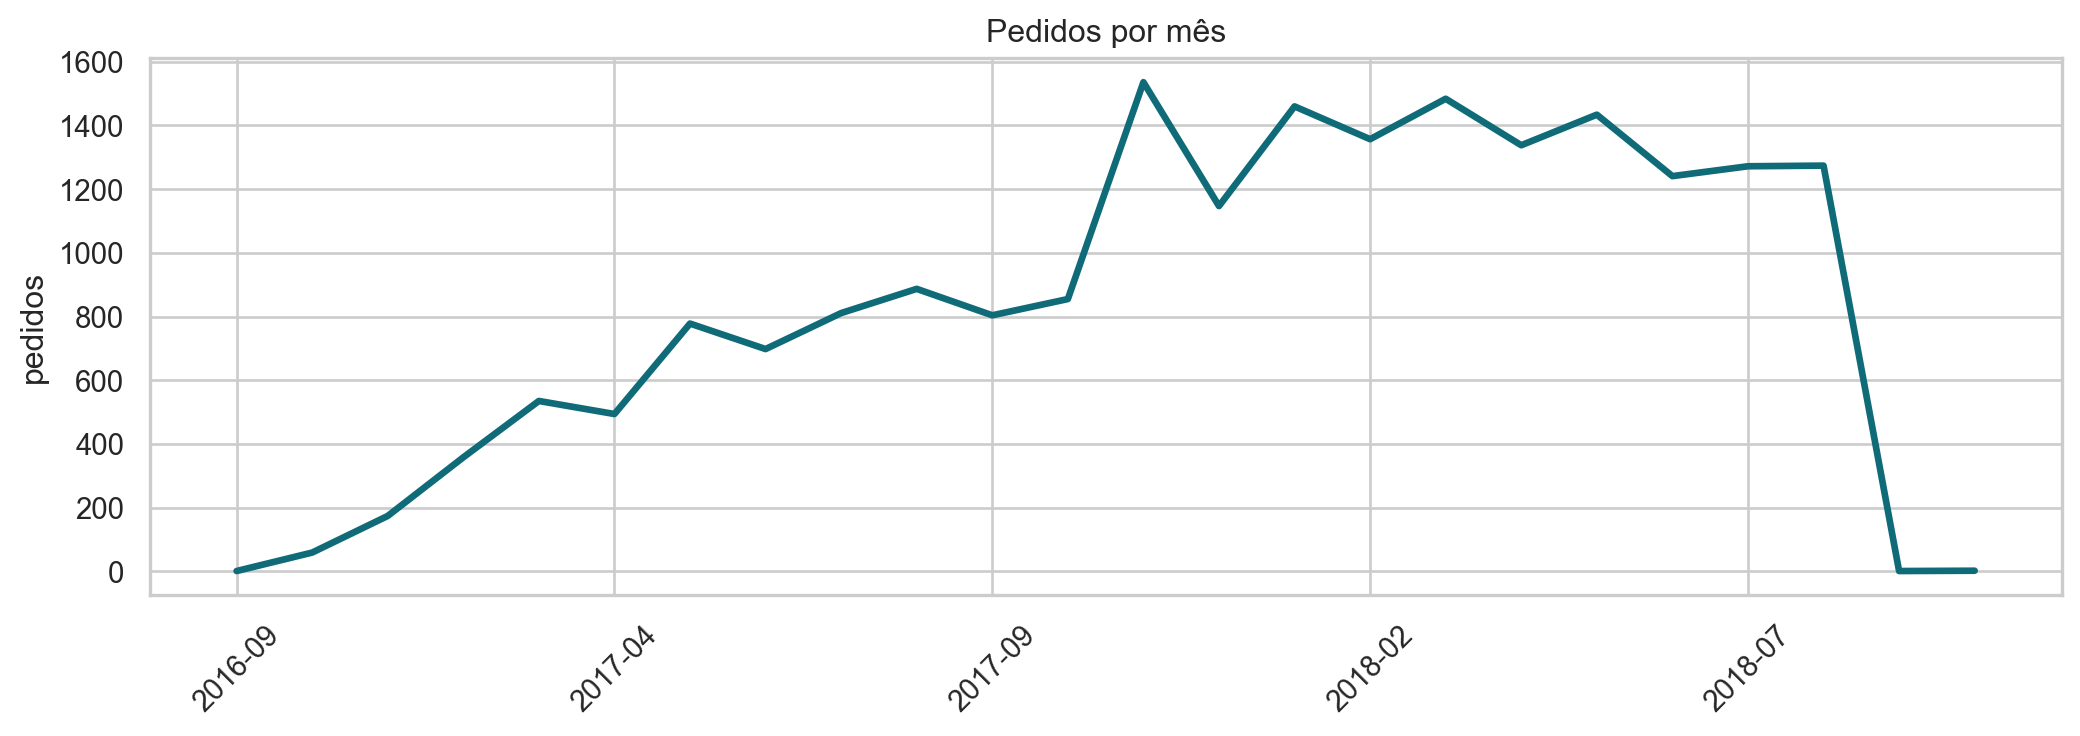
NotaInterpretação
A cobertura temporal precisa ser verificada antes de comparar períodos. Meses incompletos e datas ausentes podem produzir quedas artificiais que pertencem ao processo de coleta, não ao fenômeno estudado.
Os últimos meses possuem cobertura parcial. Uma comparação direta entre agosto e setembro de 2018 seria enganosa.
Dados ausentes
missing = pd.DataFrame({
    "n": analysis.isna().sum(),
    "pct": analysis.isna().mean().mul(100),
}).query("n > 0").sort_values("n", ascending=False)
missing| n | pct | |
|---|---|---|
| atraso_dias | 606 | 3.03 |
| order_delivered_customer_date | 606 | 3.03 |
| entrega_dias | 606 | 3.03 |
| order_delivered_carrier_date | 379 | 1.90 |
| nota | 173 | 0.86 |
| n_reviews | 173 | 0.86 |
| tem_comentario | 173 | 0.86 |
| diferenca_pagamento | 169 | 0.84 |
| valor_esperado | 168 | 0.84 |
| itens | 168 | 0.84 |
| valor_produtos | 168 | 0.84 |
| frete | 168 | 0.84 |
| vendedores | 168 | 0.84 |
| order_approved_at | 37 | 0.18 |
| formas_pagamento | 1 | 0.01 |
| valor_pago | 1 | 0.01 |
| parcelas_max | 1 | 0.01 |
missing.head(12).sort_values("n").plot.barh(y="n", legend=False, figsize=(9, 5), color="#d95f02")
plt.title("Valores ausentes após o merge")
plt.xlabel("valores ausentes")
plt.ylabel("")
plt.tight_layout()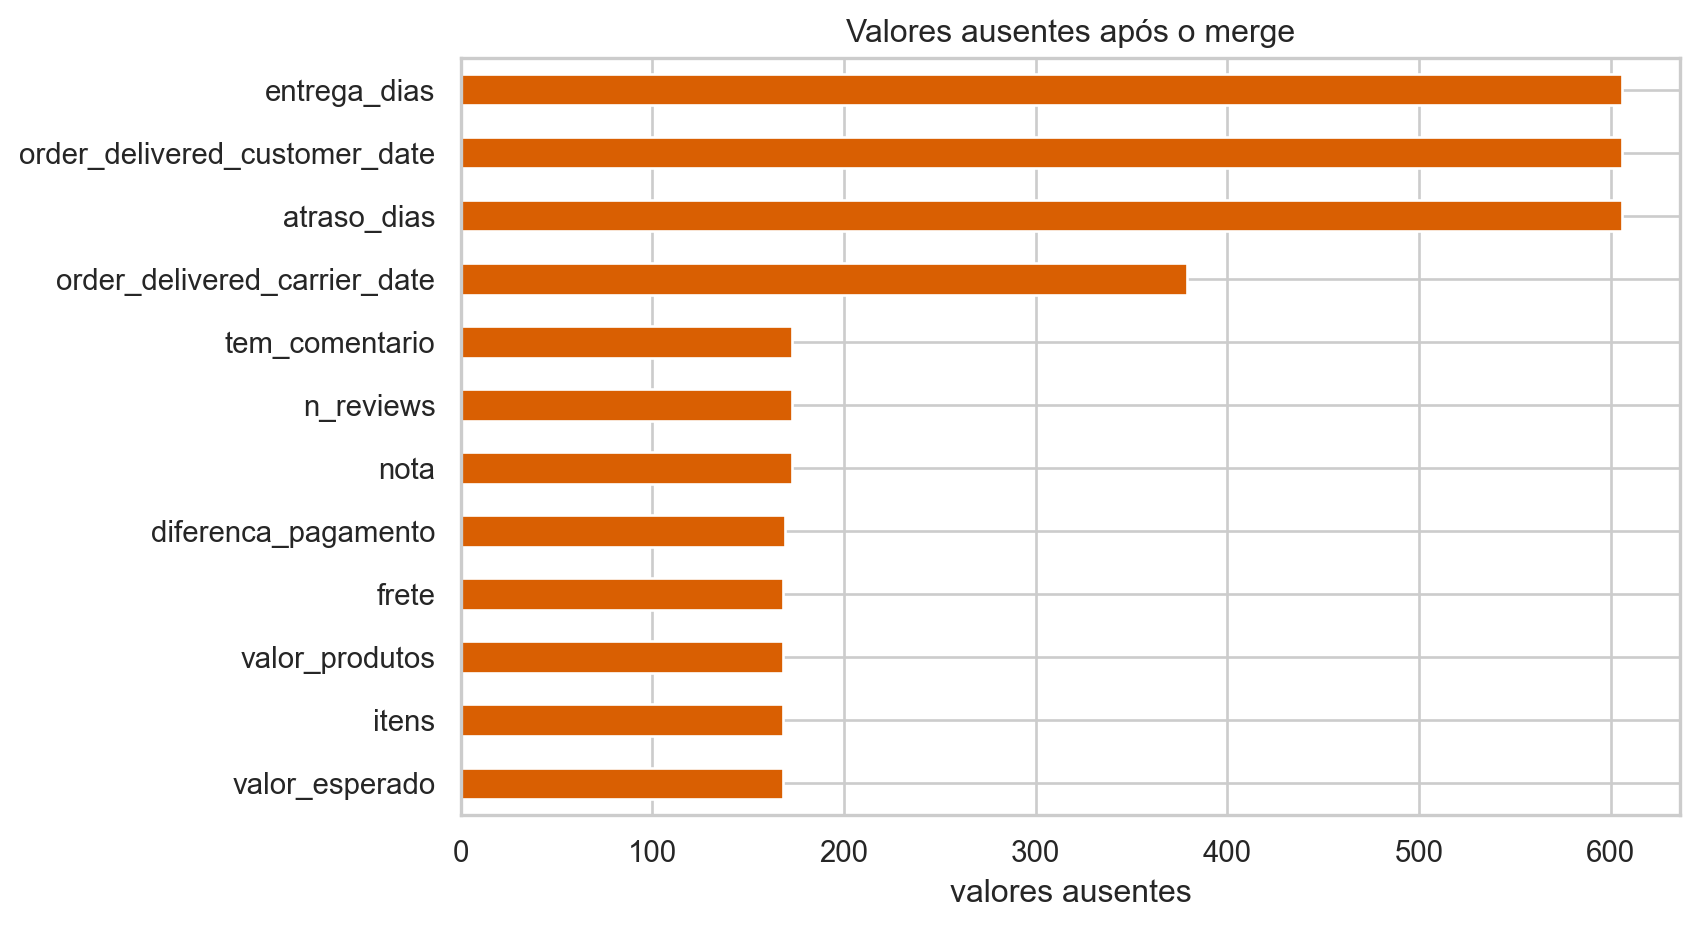
NotaInterpretação
Ausência não equivale a zero. Interprete-a à luz do processo gerador: uma avaliação pode faltar porque o pedido não foi avaliado, enquanto uma data de entrega pode faltar porque a entrega ainda não ocorreu.
Ausência condicionada ao status
pd.crosstab(
    analysis["order_status"],
    analysis["order_delivered_customer_date"].isna(),
    normalize="index",
).rename(columns={False: "tem entrega", True: "sem entrega"}).round(3)| order_delivered_customer_date | tem entrega | sem entrega |
|---|---|---|
| order_status | ||
| approved | 0.00 | 1.00 |
| canceled | 0.00 | 1.00 |
| delivered | 1.00 | 0.00 |
| invoiced | 0.00 | 1.00 |
| processing | 0.00 | 1.00 |
| shipped | 0.00 | 1.00 |
| unavailable | 0.00 | 1.00 |
Pedidos interrompidos normalmente não possuem data de entrega. Preencher essa ausência com zero dias inventaria um evento que não ocorreu.
Comentário ausente não é nota ausente
reviews[["review_score", "review_comment_message"]].isna().mean().mul(100).round(1)review_score 0.00
review_comment_message 58.50
dtype: float64Muitos clientes atribuem uma nota sem escrever um comentário. As duas ausências têm mecanismos diferentes.
Regras de corretude
checks = pd.Series({
    "order_id único": analysis["order_id"].is_unique,
    "preço não negativo": items["price"].ge(0).all(),
    "frete não negativo": items["freight_value"].ge(0).all(),
    "nota entre 1 e 5": reviews["review_score"].between(1, 5).all(),
    "item começa em 1": items["order_item_id"].ge(1).all(),
})
checks
order_id único True
preço não negativo True
frete não negativo True
nota entre 1 e 5 True
item começa em 1 True
dtype: boolDistribuição do valor do pedido
analysis["valor_produtos"].describe(percentiles=[.5, .9, .95, .99])count 19,832.00
mean 136.83
std 206.46
min 0.85
50% 86.99
90% 269.99
95% 396.18
99% 968.55
max 7,160.00
Name: valor_produtos, dtype: float64fig, axes = plt.subplots(1, 2, figsize=(13, 4))
sns.histplot(analysis["valor_produtos"], bins=70, ax=axes[0], color="#0f6b78")
sns.histplot(analysis.query("valor_produtos <= 500")["valor_produtos"], bins=50,
ax=axes[1], color="#0f6b78")
axes[0].set_title("Escala completa")
axes[1].set_title("Zoom até R$ 500")
for ax in axes:
ax.set_xlabel("valor dos produtos")
plt.tight_layout()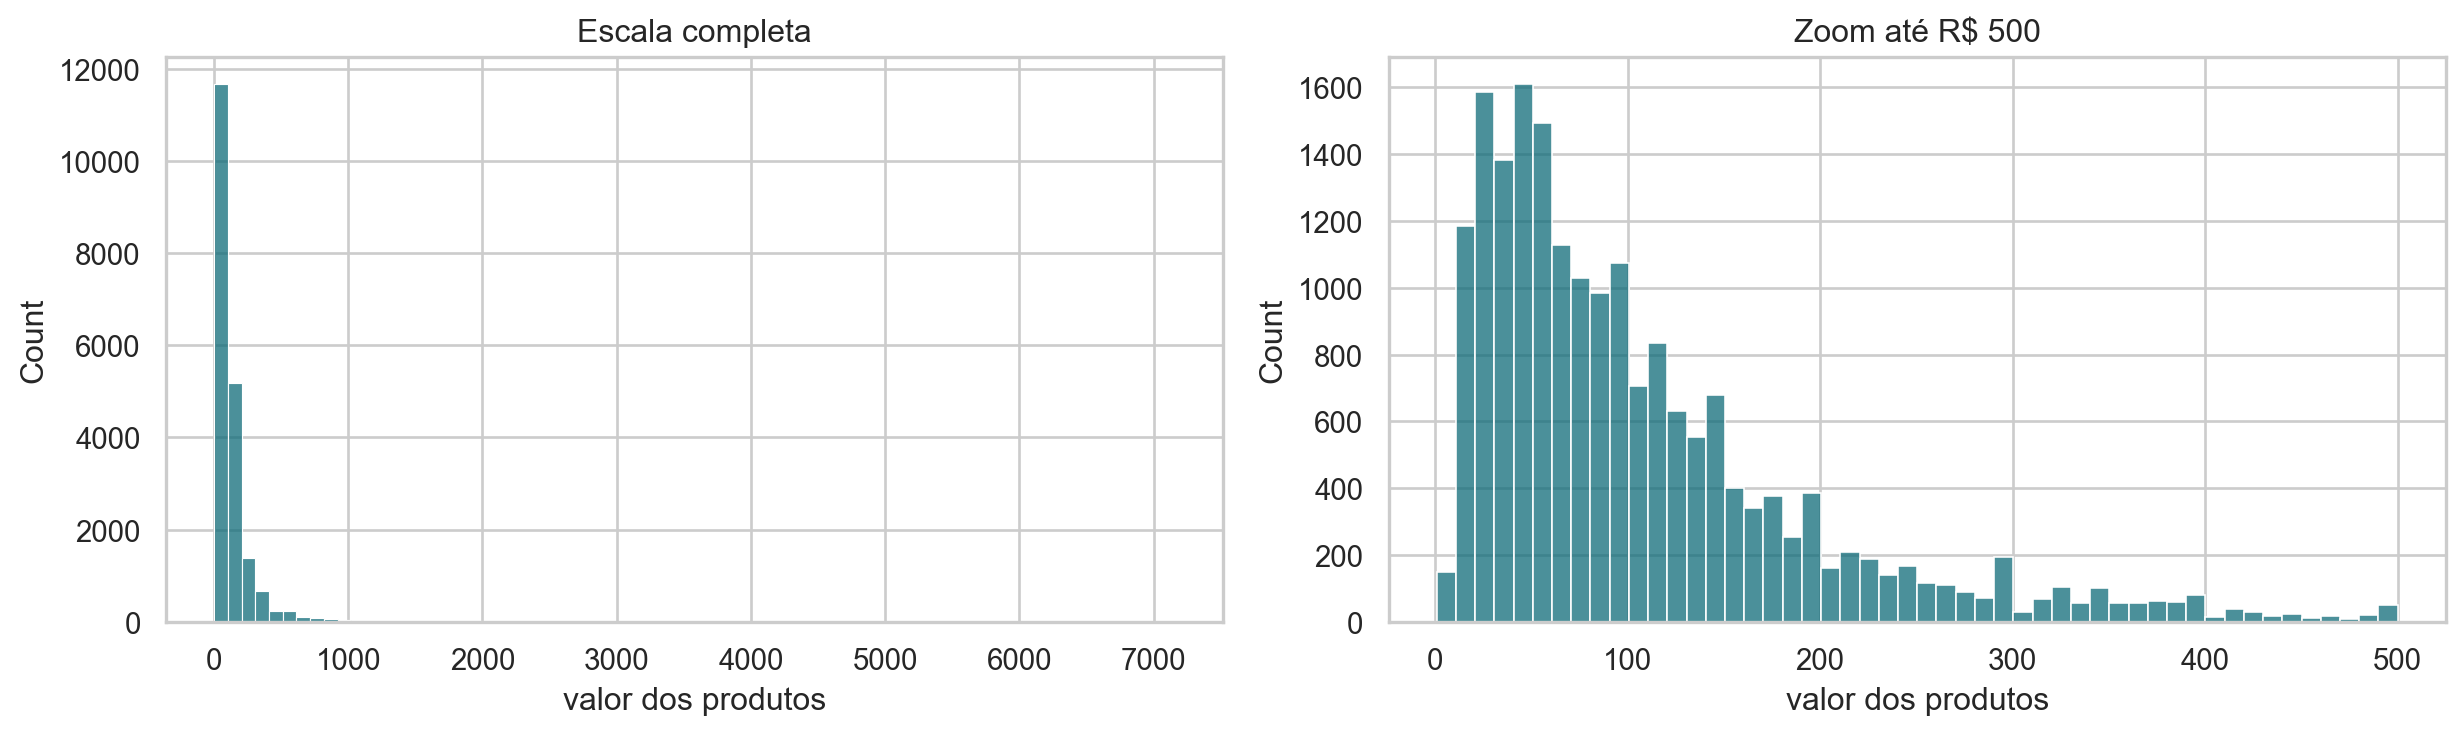
NotaInterpretação
Leia primeiro concentração, assimetria, caudas e valores extremos. Um único resumo de centro não descreve adequadamente uma distribuição longa ou multimodal.
O que torna um valor extremo?
analysis.nlargest(10, "valor_produtos")[[
    "order_id", "valor_produtos", "itens", "frete", "customer_state"
]]| order_id | valor_produtos | itens | frete | customer_state | |
|---|---|---|---|---|---|
| 435 | 736e1922ae60d0d6a89247b851902527 | 7,160.00 | 4.00 | 114.88 | ES |
| 10429 | fefacc66af859508bf1a7934eab1e97f | 6,729.00 | 1.00 | 193.21 | ES |
| 7822 | 86c4eab1571921a6a6e248ed312f5a5a | 3,999.90 | 1.00 | 17.01 | SP |
| 14277 | d3f66901a6743e15f9311547cc623b91 | 3,700.00 | 1.00 | 92.59 | PE |
| 16948 | a53e05ecd2ed1f46a2b8e1f5828be7c6 | 3,690.00 | 1.00 | 136.80 | MG |
| 16641 | 66b9c991ee308f9342f6a7f63bb68251 | 3,300.00 | 2.00 | 58.24 | BA |
| 4072 | 4412d97cb2093633afa85f11db46316c | 3,099.75 | 6.00 | 95.99 | MA |
| 2950 | 94fca82966c05ba707f4e7dc0c50aa3c | 3,099.00 | 1.00 | 252.35 | MG |
| 16124 | f0da489592c62097d0034f139386cb32 | 2,951.00 | 1.00 | 58.53 | BA |
| 7457 | 80d49171762a51f500bf6b774aa24617 | 2,749.65 | 1.00 | 38.22 | SP |
Valores extremos podem resultar de muitos itens, produtos caros ou regras comerciais. Investigue antes de excluir.
Distribuição do prazo de entrega
delivered = analysis.query("order_status == 'delivered'").copy()
delivered["entrega_dias"].describe(percentiles=[.5, .9, .95, .99])
count 19,394.00
mean 12.54
std 9.30
min 0.86
50% 10.19
90% 23.15
95% 29.41
99% 45.19
max 189.86
Name: entrega_dias, dtype: float64sns.histplot(delivered["entrega_dias"], bins=55, color="#0f6b78")
plt.axvline(delivered["entrega_dias"].median(), color="#d95f02", linestyle="--")
plt.title("Tempo entre compra e entrega")
plt.xlabel("dias")
plt.tight_layout()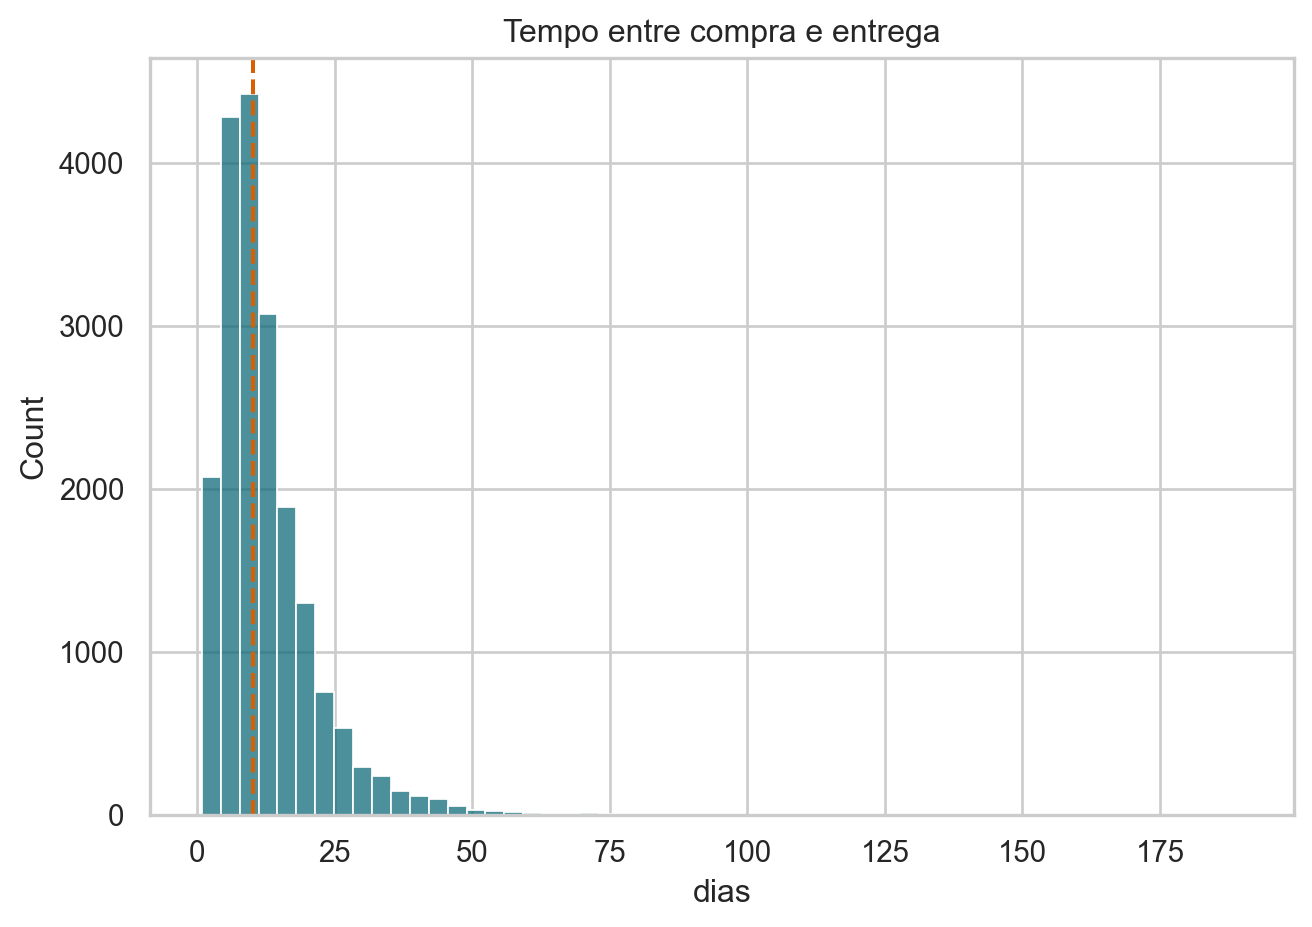
Taxa de atraso
delivered["atrasou"].value_counts(normalize=True).rename("proporção")False 0.92
True 0.08
Name: proporção, dtype: float64delivered.groupby("atrasou")["atraso_dias"].describe()| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| atrasou | ||||||||
| False | 17,822.00 | -13.02 | 7.38 | -108.42 | -17.08 | -12.32 | -7.73 | -0.00 |
| True | 1,572.00 | 9.06 | 12.44 | 0.00 | 1.87 | 5.72 | 11.74 | 167.71 |
NotaInterpretação
Defina atraso comparando entrega realizada e prazo prometido apenas entre pedidos elegíveis. Ao relacioná-lo à avaliação, separe associação de mecanismo causal e considere avaliações ausentes.
Distribuição das avaliações
reviews["review_score"].value_counts(normalize=True).sort_index().rename("proporção")1 0.12
2 0.03
3 0.09
4 0.19
5 0.57
Name: proporção, dtype: float64sns.countplot(data=reviews, x="review_score", color="#3a7d44")
plt.title("Distribuição das notas")
plt.xlabel("nota")
plt.ylabel("avaliações")
plt.tight_layout()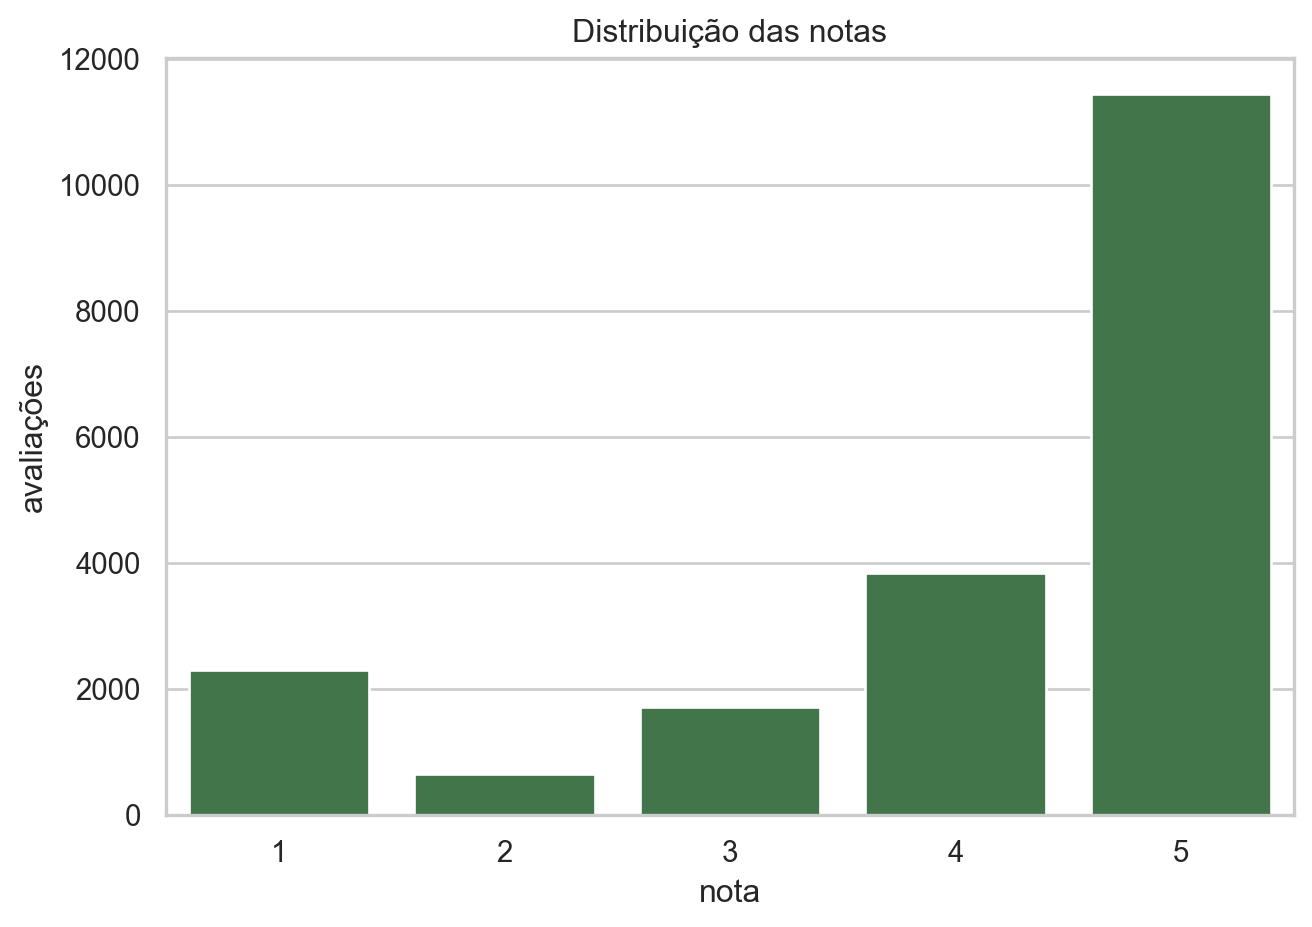
Atraso e avaliação
score_by_delay = delivered.groupby("atrasou")["nota"].agg(["count", "mean", "median"])
score_by_delay| count | mean | median | |
|---|---|---|---|
| atrasou | |||
| False | 17723 | 4.28 | 5.00 |
| True | 1533 | 2.58 | 2.00 |
sns.barplot(data=score_by_delay.reset_index(), x="atrasou", y="mean", color="#0f6b78")
plt.ylim(0, 5)
plt.title("Nota média segundo atraso")
plt.xlabel("pedido atrasou?")
plt.ylabel("nota média")
plt.tight_layout()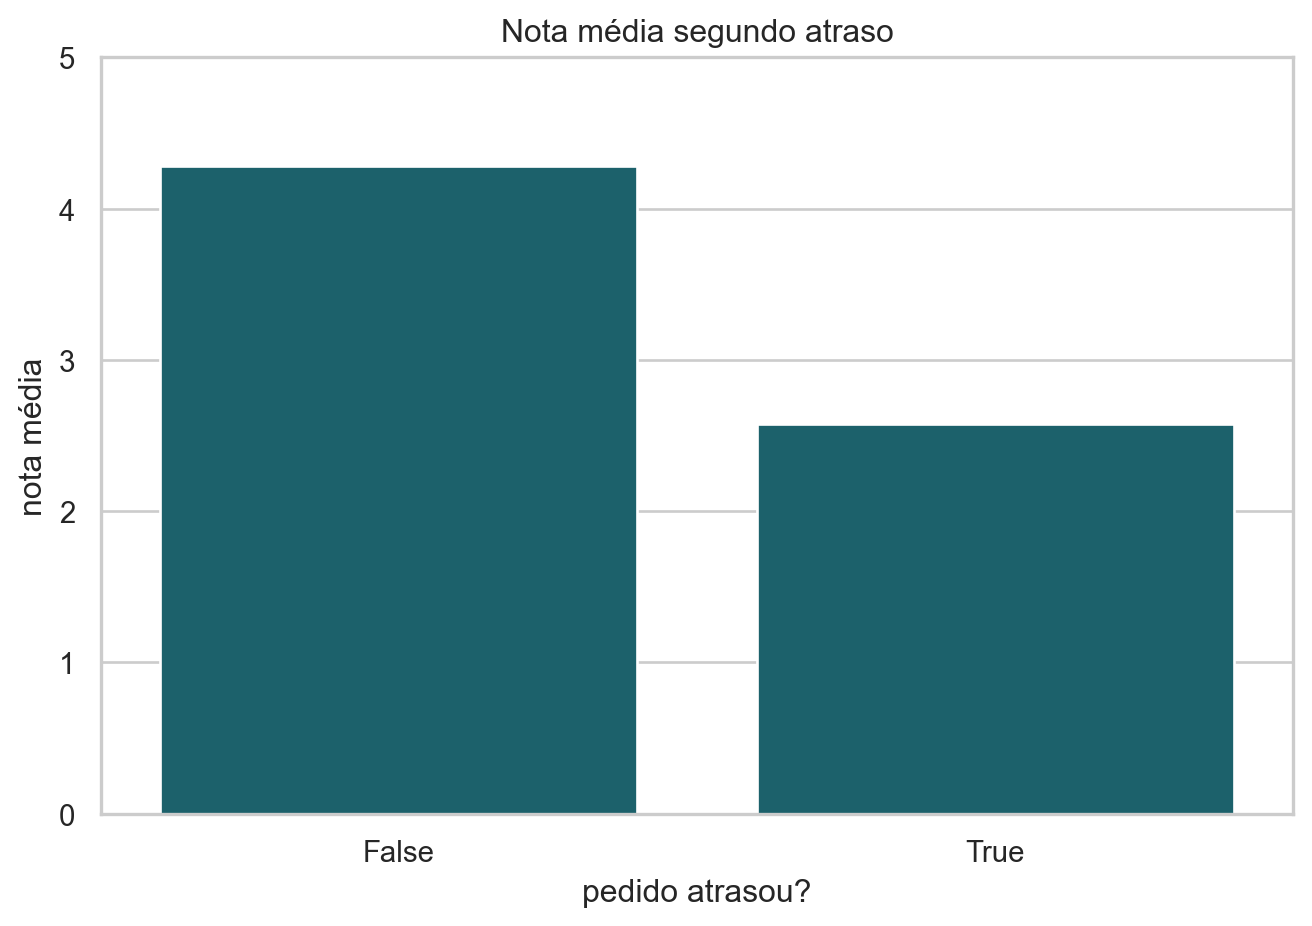
Esta associação não demonstra que o atraso, isoladamente, causou a diferença. Distância, vendedor, produto e período podem afetar os dois lados.
Análise por estado
state_summary = (
    delivered.groupby("customer_state")
    .agg(
        pedidos=("order_id", "size"),
        entrega_mediana=("entrega_dias", "median"),
        taxa_atraso=("atrasou", "mean"),
        nota_media=("nota", "mean"),
    )
    .query("pedidos >= 100")
    .sort_values("pedidos", ascending=False)
)
state_summary.head(12)| pedidos | entrega_mediana | taxa_atraso | nota_media | |
|---|---|---|---|---|
| customer_state | ||||
| SP | 8200 | 7.18 | 0.06 | 4.24 |
| RJ | 2445 | 12.00 | 0.13 | 3.92 |
| MG | 2287 | 10.28 | 0.06 | 4.18 |
| RS | 1072 | 13.37 | 0.08 | 4.21 |
| PR | 968 | 10.43 | 0.06 | 4.29 |
| SC | 699 | 13.19 | 0.09 | 4.06 |
| BA | 645 | 16.88 | 0.14 | 3.94 |
| DF | 446 | 11.80 | 0.09 | 4.08 |
| ES | 403 | 13.23 | 0.11 | 4.14 |
| GO | 396 | 14.01 | 0.08 | 4.00 |
| PE | 350 | 15.22 | 0.12 | 4.04 |
| CE | 263 | 17.82 | 0.14 | 4.00 |
NotaInterpretação
Compare grupos usando a mesma definição de métrica e mostre também seus tamanhos. Diferenças aparentes podem refletir composição, cobertura ou poucos casos, e não apenas o fator usado no agrupamento.
Relação entre frete e valor
sample_plot = delivered.sample(min(5000, len(delivered)), random_state=42)
sns.scatterplot(data=sample_plot, x="valor_produtos", y="frete", alpha=.25, s=18)
plt.xlim(0, 600)
plt.ylim(0, 150)
plt.title("Frete e valor do pedido")
plt.tight_layout()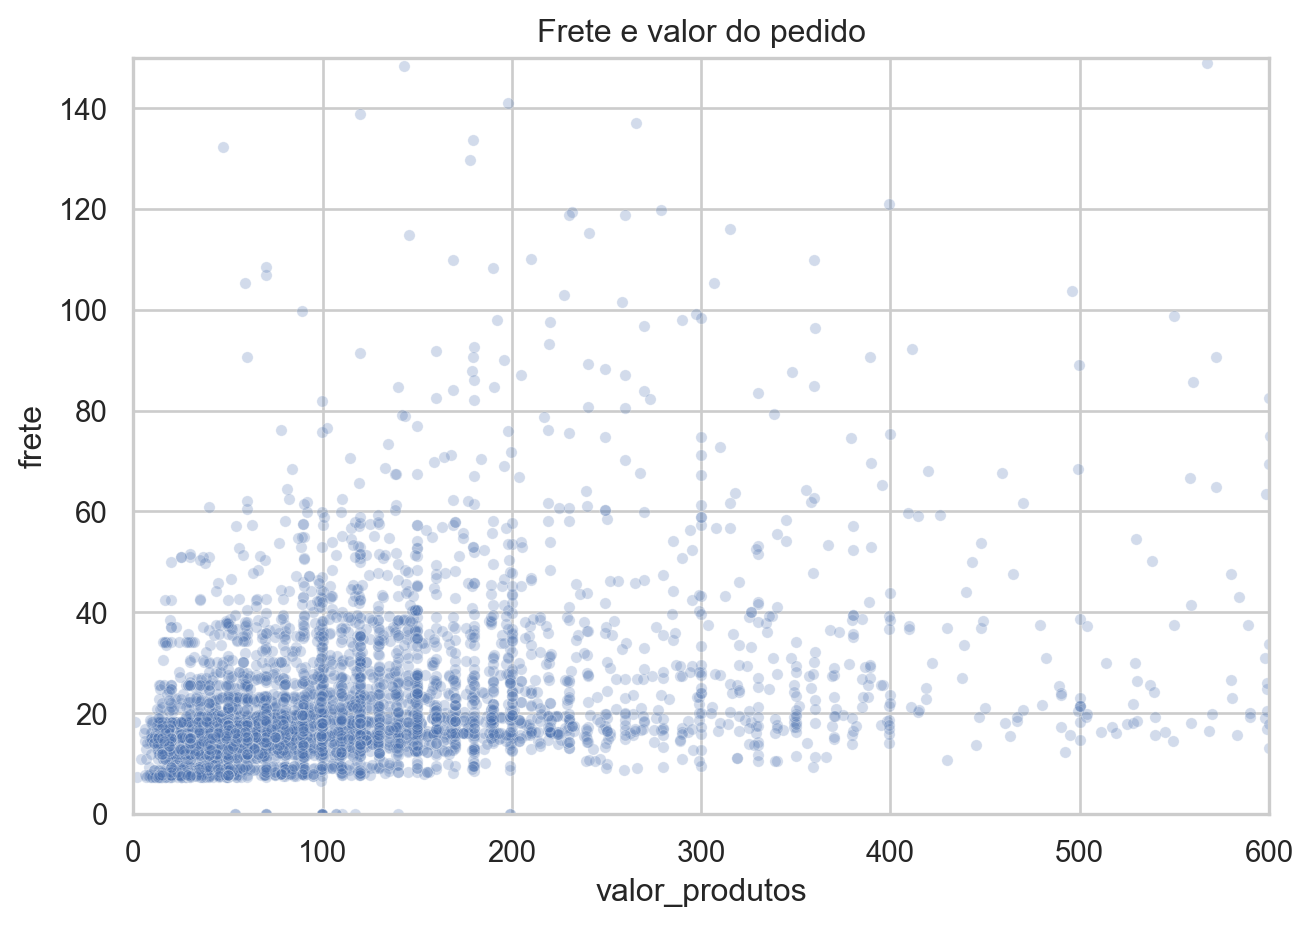
NotaInterpretação
Uma associação visual não estabelece causalidade. Verifique forma, grupos, valores influentes e possíveis variáveis de confusão antes de resumir a relação por uma única correlação.
Uma tabela analítica final
analytic_cols = [
    "order_id", "customer_unique_id", "customer_state", "order_status",
    "order_purchase_timestamp", "itens", "valor_produtos", "frete",
    "valor_pago", "nota", "entrega_dias", "atraso_dias", "atrasou",
]
analytic = analysis[analytic_cols].copy()
analytic.head()| order_id | customer_unique_id | customer_state | order_status | order_purchase_timestamp | itens | valor_produtos | frete | valor_pago | nota | entrega_dias | atraso_dias | atrasou | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | b9a6c5f5df52c7226ac85aee7524c27f | 2d1bf256227e4d22d10ea6c0b81809d7 | RS | delivered | 2018-06-12 20:07:44 | 1.00 | 99.00 | 18.79 | 117.79 | 5.00 | 6.69 | -27.47 | False |
| 1 | 261e71d2349c713eafa9f3df5972b95d | 12bf514b8d413d8cbe66a2665f4b724c | MG | delivered | 2018-01-20 12:15:57 | 1.00 | 157.77 | 14.85 | 172.62 | 5.00 | 9.97 | -15.52 | False |
| 2 | 67b50899f52995848c427e361e10dde3 | 83c6df0d47130de38c99cebe96521e8a | PR | delivered | 2018-06-16 21:24:10 | 1.00 | 90.00 | 18.43 | 108.43 | 1.00 | 10.66 | -18.45 | False |
| 3 | 32733fc014b67ef70fa6039dd8c6ba82 | 29b186723b197669f69b7d63c3e27c07 | RJ | delivered | 2017-08-30 21:12:28 | 1.00 | 229.99 | 26.06 | 256.05 | 5.00 | 25.86 | 3.75 | True |
| 4 | 39a70e9e9b729b11dee34ac12478597f | a59129ed35da4c3e3f2a005b4c6582fc | PR | delivered | 2017-08-10 21:26:25 | 1.00 | 108.90 | 20.00 | 128.90 | 3.00 | 11.80 | -20.30 | False |
analytic.shape, analytic["order_id"].is_unique((20000, 13), True)Exercícios
- Compare a mediana do frete entre os cinco estados com mais pedidos.
- Calcule a proporção de pedidos com mais de um item.
- Verifique se pedidos com mais de um pagamento possuem maior valor mediano.
- Compare a taxa de comentários escritos entre notas 1 e 5.
- Refaça a análise de atraso excluindo os meses incompletos de 2018.
- Explique por que juntar
itemsepaymentsdiretamente pode criar uma relação muitos-para-muitos.
Respostas sugeridas — 1 e 2
top_states = analytic["customer_state"].value_counts().head(5).index
analytic.query("customer_state in @top_states").groupby("customer_state")["frete"].median().sort_values()
customer_state
SP 13.51
PR 17.76
MG 18.02
RJ 18.05
RS 18.26
Name: frete, dtype: float64analytic["itens"].gt(1).mean()0.1004Respostas sugeridas — 3 e 4
analysis.assign(multiplos_pagamentos=analysis["formas_pagamento"].gt(1)).groupby(
    "multiplos_pagamentos"
)["valor_produtos"].median()
multiplos_pagamentos
False 87.00
True 81.70
Name: valor_produtos, dtype: float64reviews.assign(tem_comentario=reviews["review_comment_message"].notna()).groupby(
"review_score"
)["tem_comentario"].mean().loc[[1, 5]]review_score
1 0.78
5 0.35
Name: tem_comentario, dtype: float64Resposta sugerida — 5
complete = delivered.query("order_purchase_timestamp < '2018-09-01'")
complete["atrasou"].mean(), delivered["atrasou"].mean()
(0.08104763868838936, 0.08104763868838936)Resposta conceitual — 6
Se um pedido possui dois itens e três pagamentos, um merge direto entre as duas tabelas produz seis combinações. Isso é um produto cartesiano dentro do pedido. Valores de item e pagamento seriam repetidos.
O caminho seguro é agregar cada tabela à granularidade de pedido antes de juntá-las.
Desafios adicionais
- Construa um indicador de frete como proporção do valor total.
- Compare atrasos por trimestre, descartando períodos incompletos.
- Investigue pedidos sem item associado e seus status.
- Crie uma função que valide chaves e cardinalidades antes de qualquer merge.
- Compare nota média por quintil de tempo de entrega.
- Escreva um parágrafo sobre limites de representatividade da base.
Leituras adicionais
- Kaggle: Brazilian E-Commerce Public Dataset by Olist.
- Computational and Inferential Thinking, capítulo de visualização.
- Documentação do pandas:
merge,groupby,resample, dados ausentes. - Wickham e Grolemund, R for Data Science, capítulos sobre dados relacionais e transformação — conceitos transferíveis para pandas.
Checklist final
Guia teórico consolidado
EDA é uma investigação estruturada
Análise exploratória não é uma coleção de gráficos. Ela testa se os dados conseguem sustentar a pergunta. Um roteiro útil percorre cinco lentes:
- estrutura: arquivos, colunas, tipos e chaves;
- granularidade: o que cada linha representa;
- escopo: população, período, filtros e cobertura;
- qualidade: ausências, duplicatas, valores impossíveis e inconsistências;
- distribuição e relações: forma, centro, dispersão, grupos e associações.
Chaves, cardinalidade e merges
Uma chave identifica unidades. Em um relacionamento um-para-muitos, juntar pedidos e itens multiplica linhas porque cada pedido pode conter vários itens. Isso não é necessariamente erro, mas muda a granularidade. Se a pergunta está no nível do pedido, agregue os itens antes de retornar à tabela de pedidos.
Declare a cardinalidade esperada (one_to_one, one_to_many, many_to_one) e confira quantas linhas e unidades únicas existem antes e depois do merge. inner, left, right e outer respondem perguntas distintas porque preservam populações diferentes.
Ausência pode carregar informação
Dados ausentes podem depender do processo: pedidos cancelados não possuem data de entrega; avaliações só existem para quem respondeu. Remover linhas com dropna() pode redefinir silenciosamente a população analisada. As estratégias principais são excluir, imputar ou modelar a ausência, sempre descrevendo qual pergunta passa a ser respondida.
Tempo, cobertura e censura
Séries temporais exigem datas válidas e períodos completos. Os meses finais de uma base podem parecer ter menos pedidos apenas porque a coleta terminou antes de todos os eventos amadurecerem. Duração de entrega também exige duas datas e uma regra clara para pedidos não entregues.
Associação não encerra a análise
A relação entre atraso e avaliação pode refletir efeito causal, seleção de quem avalia, tipo de produto, região ou período. A EDA descreve padrões e produz hipóteses; ela não identifica sozinha o mecanismo causal. Uma conclusão responsável separa o que foi observado, o que foi inferido e quais explicações alternativas permanecem.