from pathlib import Path
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

sns.set_theme(style="whitegrid", context="notebook")
DATA = Path("data")
penguins = pd.read_csv(DATA / "penguins.csv").rename(columns={
    "culmen_length_mm": "bill_length_mm",
    "culmen_depth_mm": "bill_depth_mm",
})
penguins["species"] = penguins["species"].str.split().str[0]
penguins["sex"] = penguins["sex"].replace(".", pd.NA)
datasaurus = pd.read_csv(DATA / "datasaurus.tsv", sep="\t")Material de apoio — Fundamentos de visualização
Palmer Penguins e Datasaurus Dozen
Objetivos
Este notebook conecta tipos de variáveis, perguntas e representações. Ao final, você deverá conseguir construir e interpretar barras, histogramas, ECDFs, estimativas de densidade por kernel (KDE), boxplots, violinplots e dispersões.
Como estudar este capítulo
Um gráfico é uma forma de codificar dados em marcas visuais — pontos, linhas ou áreas — e associá-las a posição, comprimento, cor e forma. A escolha deve partir da pergunta e do tipo das variáveis. Contagens de categorias, distribuição de uma medida e relação entre duas medidas exigem representações diferentes.
O capítulo compara gráficos que respondem a perguntas próximas, mas não idênticas. Histograma e KDE enfatizam a forma da distribuição; a ECDF permite ler proporções acumuladas; boxplot resume posição e dispersão; violinplot acrescenta uma estimativa da densidade. Nenhuma dessas opções é universalmente superior.
Ao estudar uma figura, procure descrevê-la antes de julgá-la: identifique eixos, unidade, população, padrão principal e exceções. Depois compare sua leitura com os resumos numéricos. O Datasaurus mostra por que médias, desvios e correlações iguais podem esconder formas completamente distintas.
Conhecendo a base Palmer Penguins
Uma linha representa um pinguim observado. As colunas registram espécie, ilha, sexo e medidas corporais. A base foi criada para estudar variação morfológica entre espécies no arquipélago Palmer.
penguins.shape, penguins.head()((344, 7),
species island bill_length_mm bill_depth_mm flipper_length_mm \
0 Adelie Torgersen 39.1 18.7 181.0
1 Adelie Torgersen 39.5 17.4 186.0
2 Adelie Torgersen 40.3 18.0 195.0
3 Adelie Torgersen NaN NaN NaN
4 Adelie Torgersen 36.7 19.3 193.0
body_mass_g sex
0 3750.0 MALE
1 3800.0 FEMALE
2 3250.0 FEMALE
3 NaN NaN
4 3450.0 FEMALE )penguins.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 344 entries, 0 to 343
Data columns (total 7 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 species 344 non-null object
1 island 344 non-null object
2 bill_length_mm 342 non-null float64
3 bill_depth_mm 342 non-null float64
4 flipper_length_mm 342 non-null float64
5 body_mass_g 342 non-null float64
6 sex 333 non-null object
dtypes: float64(4), object(3)
memory usage: 18.9+ KBpenguins.isna().sum().sort_values(ascending=False)sex 11
bill_length_mm 2
bill_depth_mm 2
flipper_length_mm 2
body_mass_g 2
species 0
island 0
dtype: int64penguins.groupby("species").agg(
n=("species", "size"),
massa_media=("body_mass_g", "mean"),
massa_mediana=("body_mass_g", "median"),
nadadeira_media=("flipper_length_mm", "mean"),
).round(1)| n | massa_media | massa_mediana | nadadeira_media | |
|---|---|---|---|---|
| species | ||||
| Adelie | 152 | 3700.7 | 3700.0 | 190.0 |
| Chinstrap | 68 | 3733.1 | 3700.0 | 195.8 |
| Gentoo | 124 | 5076.0 | 5000.0 | 217.2 |
NotaInterpretação
Antes de interpretar resultados, confirme o que cada linha representa, o período coberto e as colunas realmente disponíveis. Essa definição determina quais agregações e comparações são válidas.
Variáveis categóricas
ordem = penguins["species"].value_counts().index
sns.countplot(data=penguins, y="species", order=ordem, color="#176b87")
plt.xlabel("pinguins"); plt.ylabel(""); plt.show()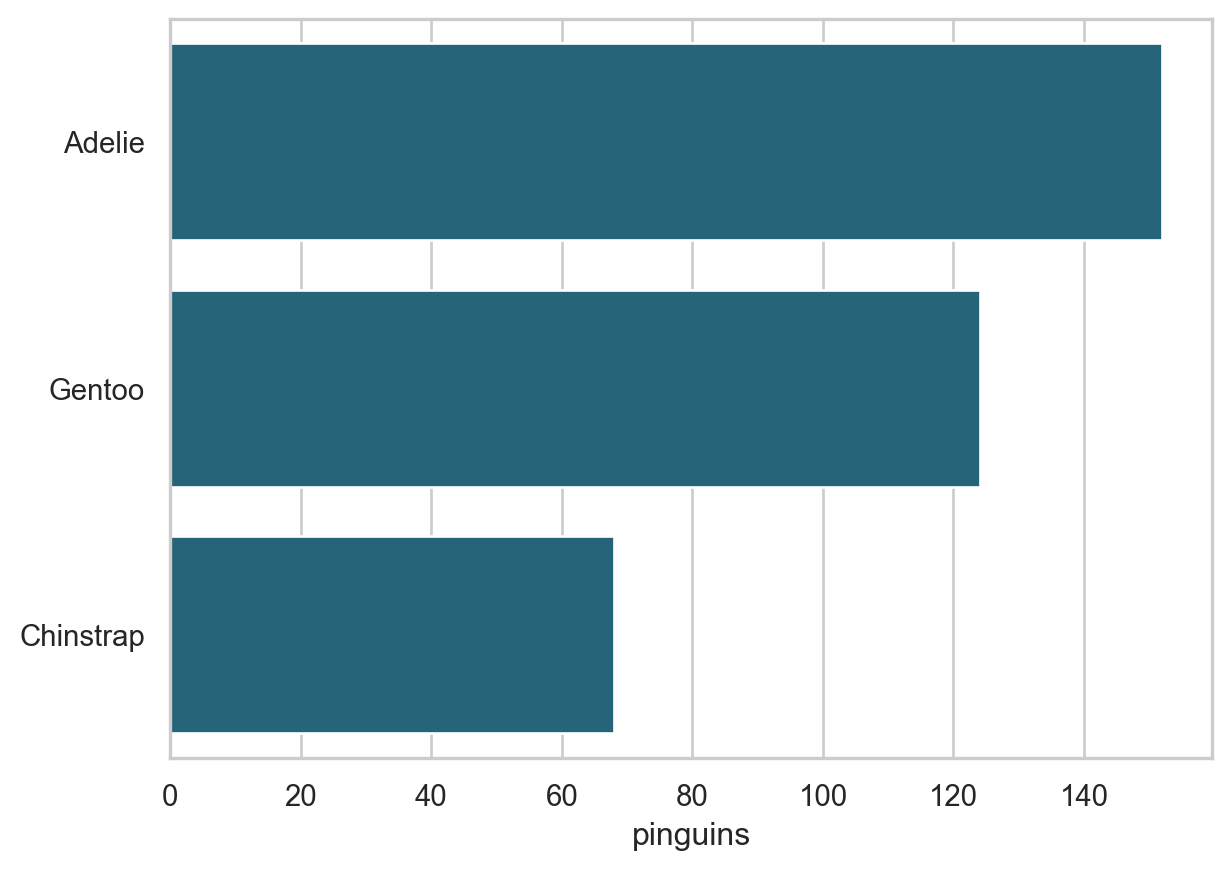
Exercício 1
Construa um gráfico de barras para island. Ordene as ilhas pela frequência e explique por que a contagem não mede abundância real das espécies no arquipélago.
# Resposta sugerida
sns.countplot(data=penguins, y="island",
              order=penguins["island"].value_counts().index,
              color="#d97727")
plt.xlabel("observações"); plt.ylabel(""); plt.show()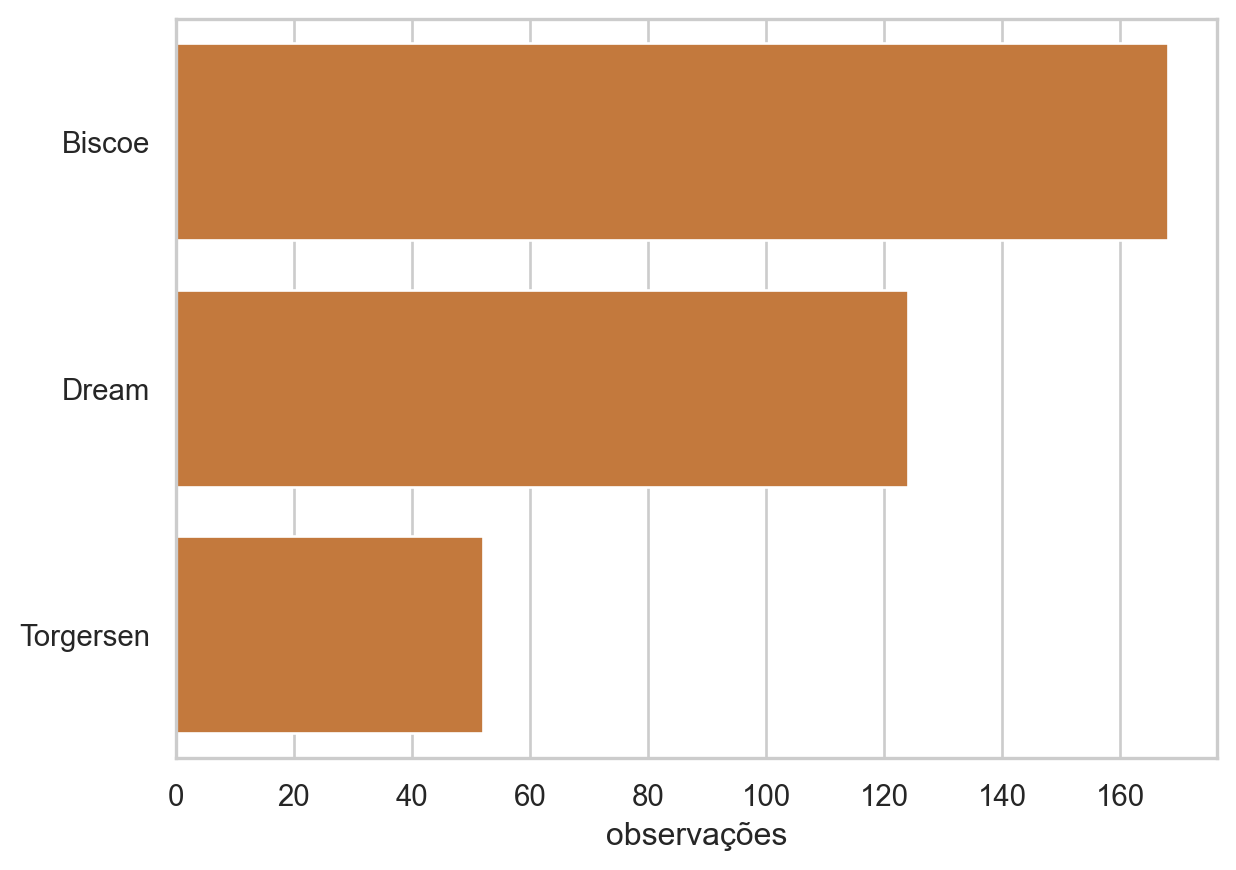
A base descreve a amostra coletada, não um censo de todos os pinguins.
Distribuições numéricas
fig, axes = plt.subplots(1, 3, figsize=(13, 3.6), sharey=True)
for ax, bins in zip(axes, [6, 15, 35]):
    sns.histplot(penguins["body_mass_g"].dropna(), bins=bins, ax=ax, color="#176b87")
    ax.set_title(f"{bins} bins")
plt.tight_layout(); plt.show()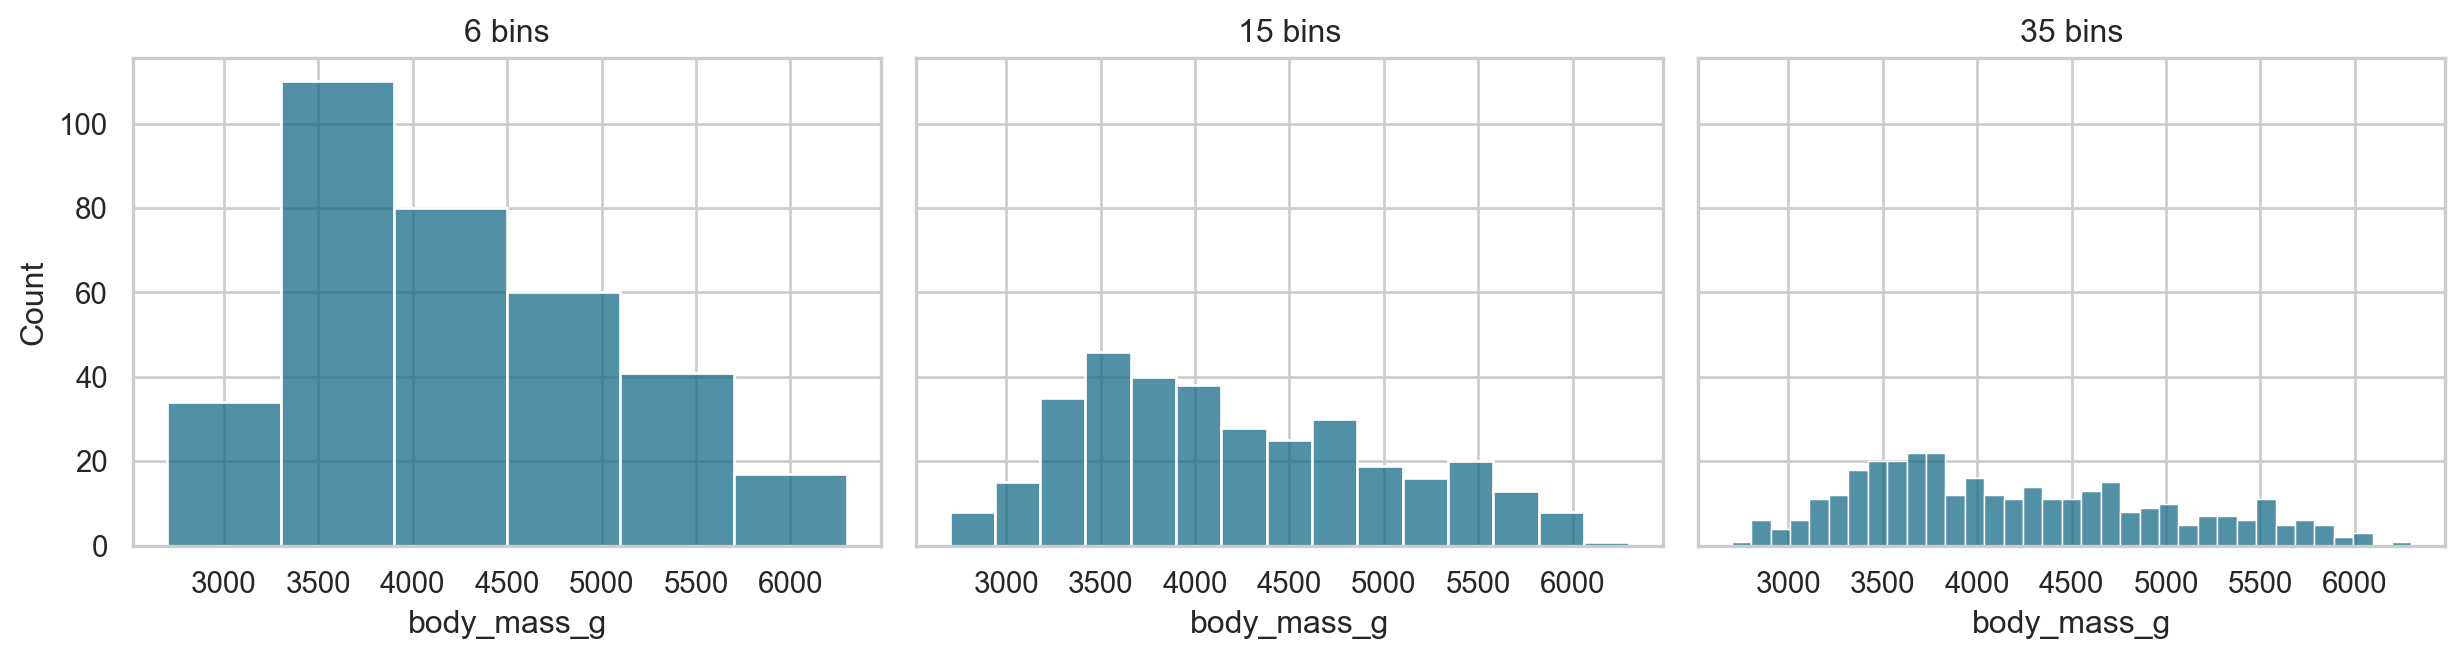
sns.ecdfplot(data=penguins, x="body_mass_g", hue="species")
plt.xlabel("massa corporal (g)"); plt.ylabel("proporção acumulada"); plt.show()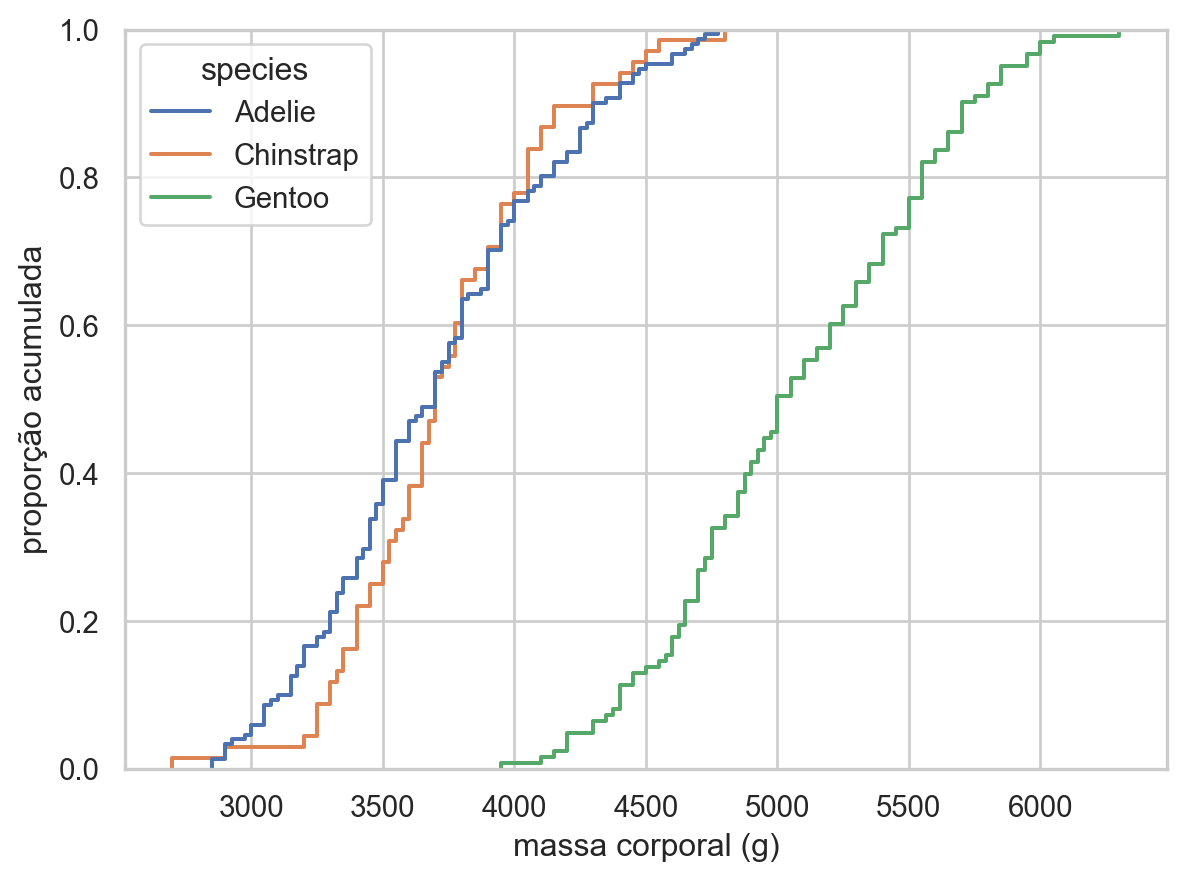
NotaInterpretação
Leia primeiro concentração, assimetria, caudas e valores extremos. Um único resumo de centro não descreve adequadamente uma distribuição longa ou multimodal.
Estimativa de densidade por kernel (KDE)
A KDE coloca um kernel em cada observação e soma essas contribuições. Na fórmula com o kernel gaussiano padrão \(K\), que tem variância 1, a transformação \(K_h(x-x_i)=h^{-1}K((x-x_i)/h)\) produz em cada observação uma Normal com desvio-padrão \(h\) e variância \(h^2\). O fator \(1/n\) faz a mistura ter área total igual a 1. Valores pequenos de \(h\) acompanham detalhes e ruído; valores grandes podem esconder estrutura. No Seaborn, bw_adjust é um multiplicador da largura de banda escolhida automaticamente, não o valor de \(h\) nas unidades dos dados.
mass = penguins["body_mass_g"].dropna()
fig, axes = plt.subplots(1, 3, figsize=(12, 3.5), sharex=True, sharey=True)
for ax, adjust in zip(axes, [0.25, 1, 2.5]):
    sns.kdeplot(x=mass, bw_adjust=adjust, fill=True, ax=ax, color="#176b87")
    sns.rugplot(x=mass, height=.04, alpha=.25, ax=ax)
    ax.set_title(f"bw_adjust = {adjust}")
plt.tight_layout(); plt.show()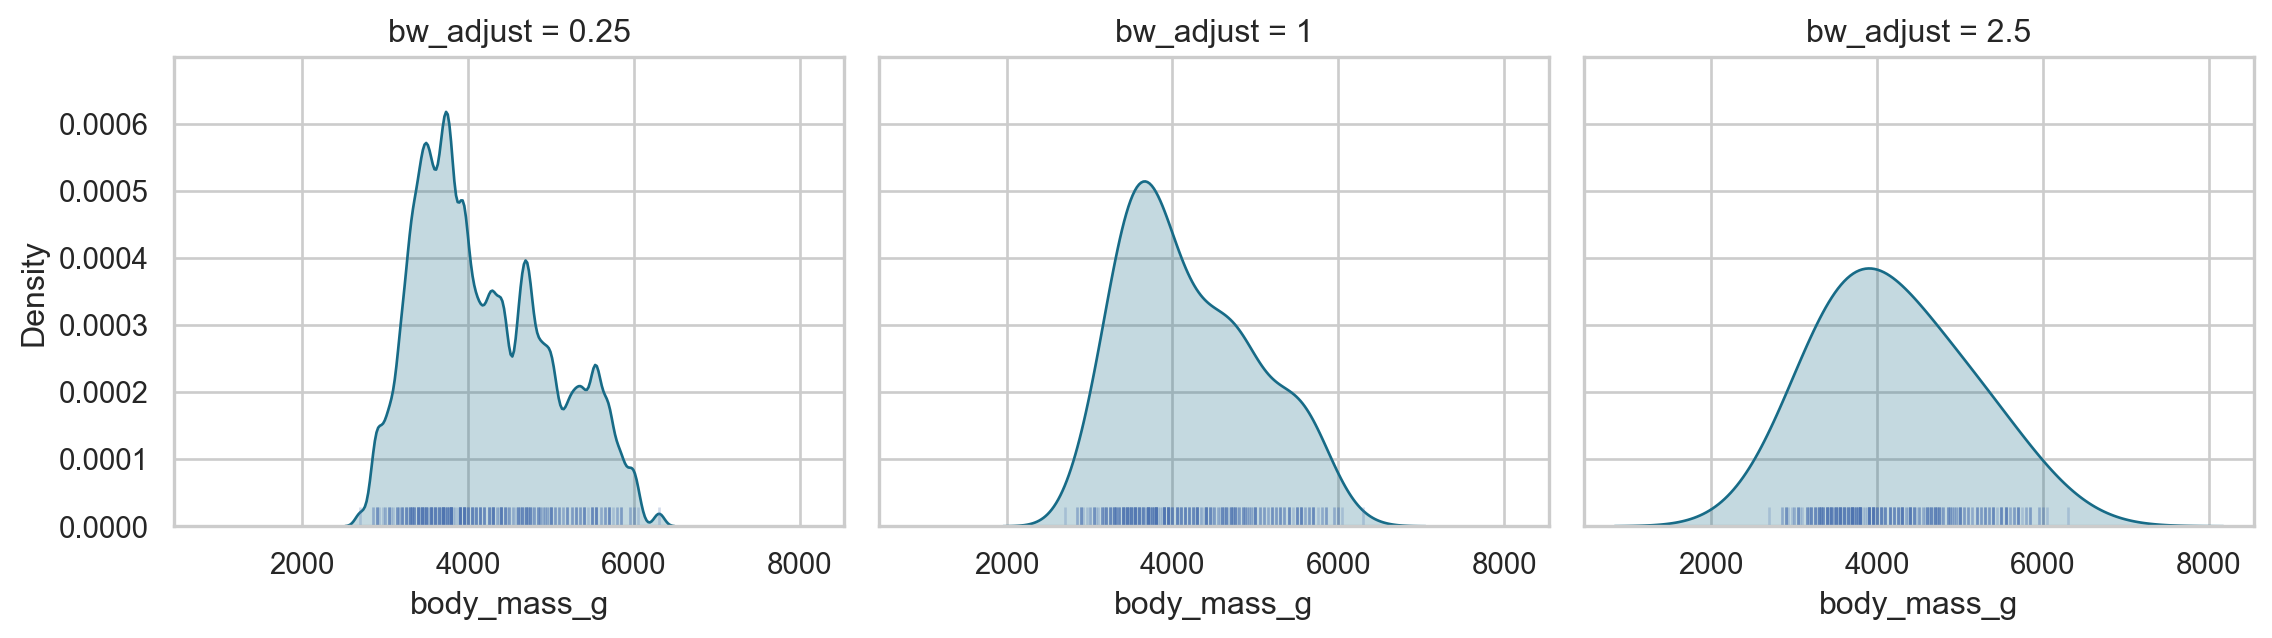
O cálculo abaixo explicita a soma de kernels gaussianos para cinco observações.
x_obs = np.array([3200, 3500, 3800, 4300, 4750])
x_grid = np.linspace(2600, 5400, 700)
h = 260
u = (x_grid[:, None] - x_obs[None, :]) / h
kernels = np.exp(-0.5 * u**2) / (np.sqrt(2*np.pi) * h)
density = kernels.mean(axis=1)

plt.plot(x_grid, density, color="#176b87", lw=2.5)
plt.fill_between(x_grid, density, alpha=.2, color="#176b87")
plt.plot(x_obs, np.zeros_like(x_obs), "|", color="#b23b3b", ms=14)
plt.xlabel("massa corporal (g)"); plt.ylabel("densidade"); plt.show()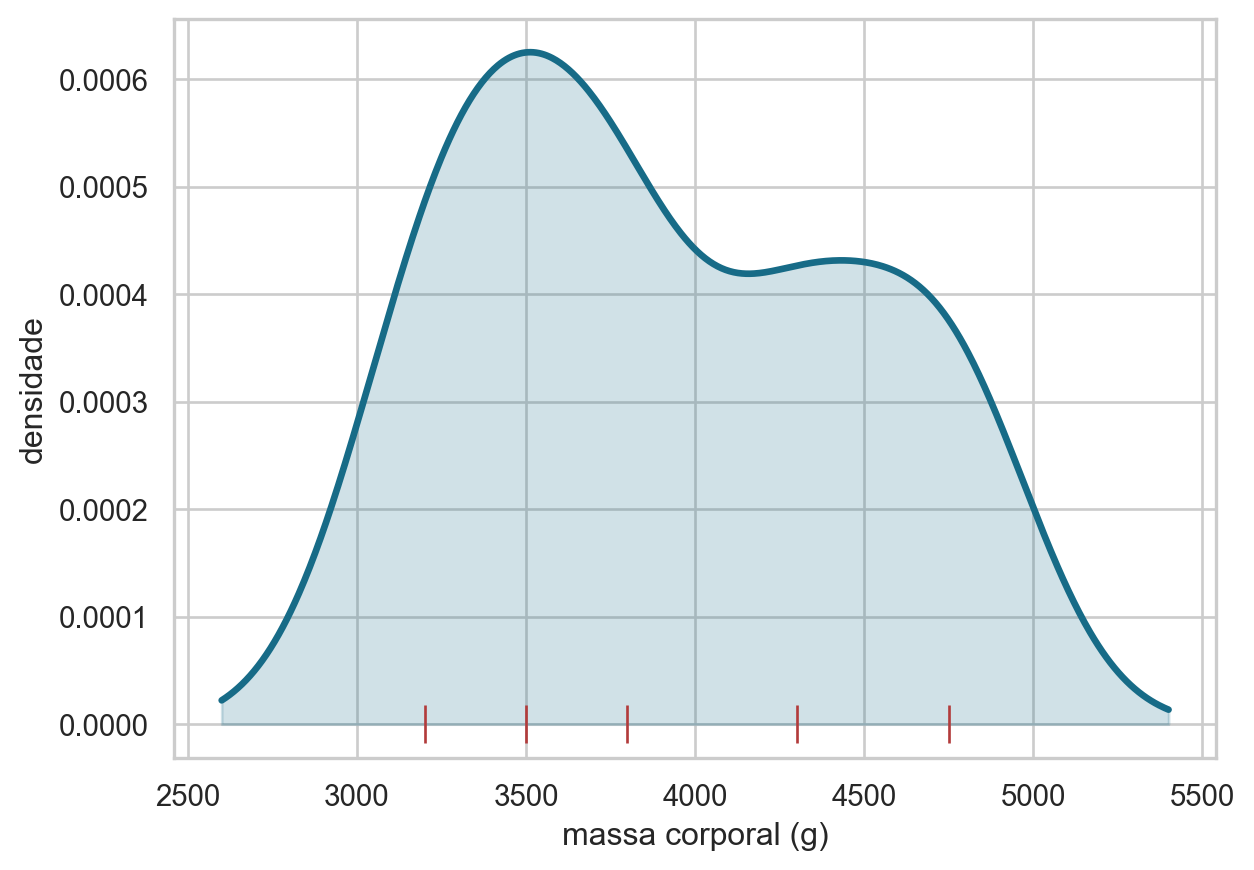
NotaInterpretação
A KDE é uma estimativa, não os dados brutos. A largura de banda controla o compromisso entre ruído e suavização; conclusões sobre picos devem ser estáveis a escolhas razoáveis desse parâmetro.
Exercício: suavização é uma escolha
Repita a KDE por espécie com hue="species". Teste ao menos três valores de bw_adjust e registre quais características persistem.
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
sns.boxplot(data=penguins, x="species", y="body_mass_g", ax=axes[0])
sns.violinplot(data=penguins, x="species", y="body_mass_g", inner="quart", ax=axes[1])
plt.tight_layout(); plt.show()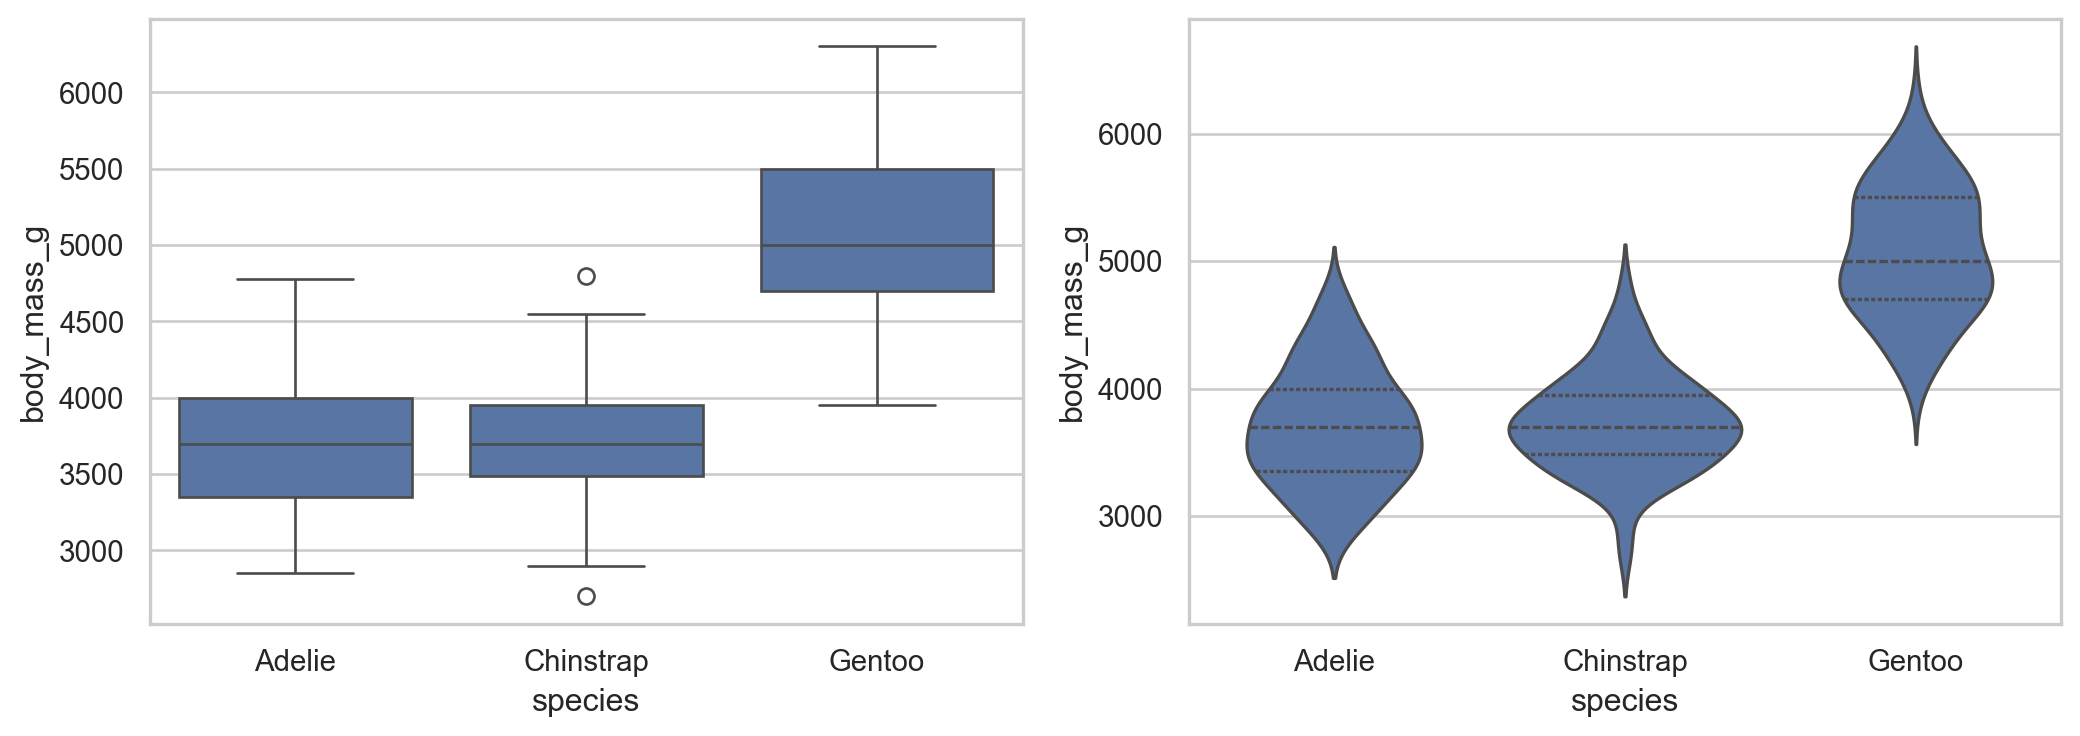
Exercício 2
Calcule, usando a ECDF, a proporção de pinguins com massa de até 4.000 g e confira diretamente com uma expressão booleana.
(penguins["body_mass_g"] <= 4000).mean()0.4941860465116279Relações entre duas medidas
sns.scatterplot(data=penguins, x="flipper_length_mm", y="body_mass_g",
                hue="species", style="species", s=65)
plt.show()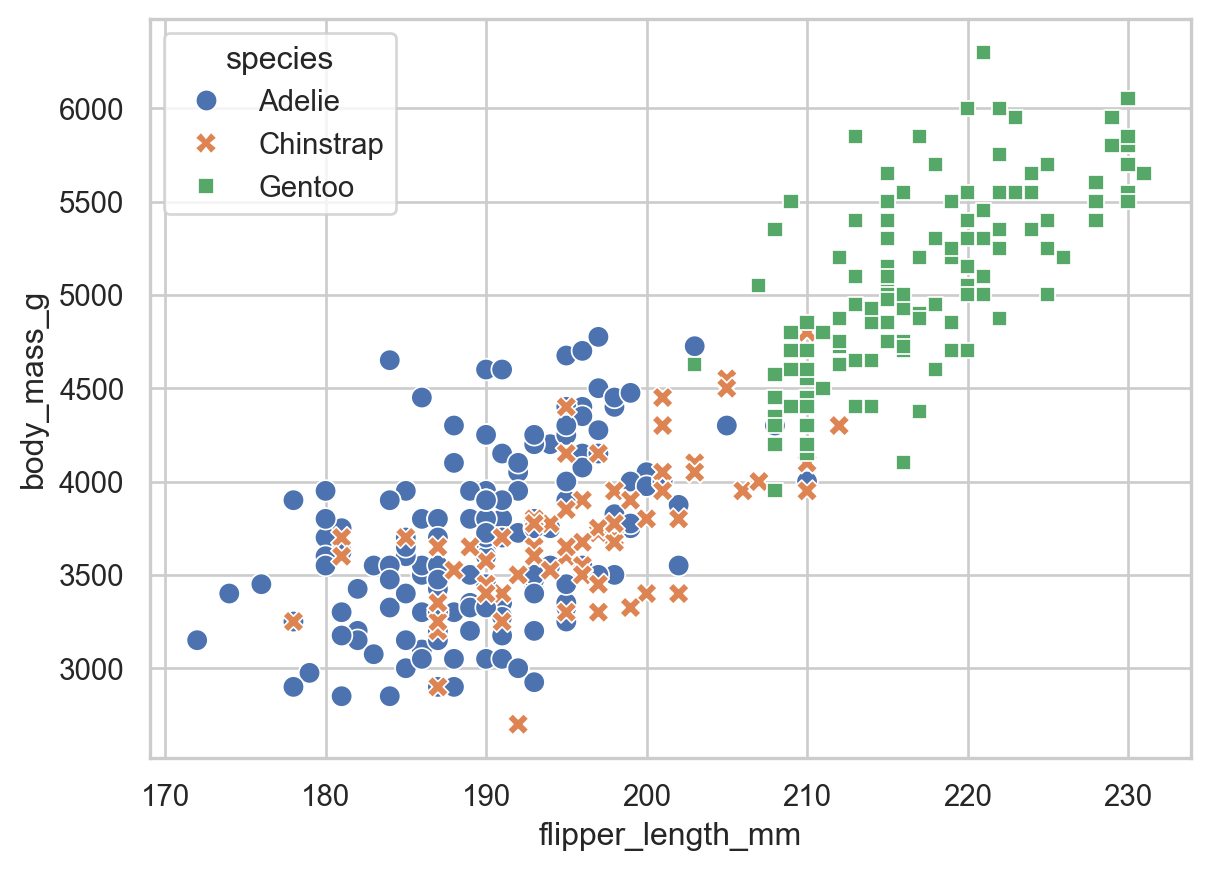
penguins[["flipper_length_mm", "body_mass_g"]].corr()| flipper_length_mm | body_mass_g | |
|---|---|---|
| flipper_length_mm | 1.000000 | 0.871202 |
| body_mass_g | 0.871202 | 1.000000 |
penguins.groupby("species")[["flipper_length_mm", "body_mass_g"]].corr().iloc[0::2, -1]species
Adelie flipper_length_mm 0.468202
Chinstrap flipper_length_mm 0.641559
Gentoo flipper_length_mm 0.702667
Name: body_mass_g, dtype: float64
NotaInterpretação
Uma associação visual não estabelece causalidade. Verifique forma, grupos, valores influentes e possíveis variáveis de confusão antes de resumir a relação por uma única correlação.
O valor agregado mistura diferenças entre espécies com relações dentro de cada espécie. O gráfico torna essa estrutura visível.
Datasaurus Dozen
Cada conjunto possui 142 pontos. A pergunta é se seus resumos bastam para descrevê-los.
datasaurus.shape, datasaurus["dataset"].value_counts().head()((1846, 3),
dino 142
away 142
h_lines 142
v_lines 142
x_shape 142
Name: dataset, dtype: int64)resumo = datasaurus.groupby("dataset").apply(
lambda d: pd.Series({
"media_x": d.x.mean(), "media_y": d.y.mean(),
"var_x": d.x.var(), "var_y": d.y.var(),
"correlacao": d.x.corr(d.y),
})
).round(2)
resumo| media_x | media_y | var_x | var_y | correlacao | |
|---|---|---|---|---|---|
| dataset | |||||
| away | 54.27 | 47.83 | 281.23 | 725.75 | -0.06 |
| bullseye | 54.27 | 47.83 | 281.21 | 725.53 | -0.07 |
| circle | 54.27 | 47.84 | 280.90 | 725.23 | -0.07 |
| dino | 54.26 | 47.83 | 281.07 | 725.52 | -0.06 |
| dots | 54.26 | 47.84 | 281.16 | 725.24 | -0.06 |
| h_lines | 54.26 | 47.83 | 281.10 | 725.76 | -0.06 |
| high_lines | 54.27 | 47.84 | 281.12 | 725.76 | -0.07 |
| slant_down | 54.27 | 47.84 | 281.12 | 725.55 | -0.07 |
| slant_up | 54.27 | 47.83 | 281.19 | 725.69 | -0.07 |
| star | 54.27 | 47.84 | 281.20 | 725.24 | -0.06 |
| v_lines | 54.27 | 47.84 | 281.23 | 725.64 | -0.07 |
| wide_lines | 54.27 | 47.83 | 281.23 | 725.65 | -0.07 |
| x_shape | 54.26 | 47.84 | 281.23 | 725.22 | -0.07 |
g = sns.relplot(data=datasaurus, x="x", y="y", col="dataset",
                col_wrap=4, height=2.1, color="#176b87")
g.set_axis_labels("", "")
plt.show()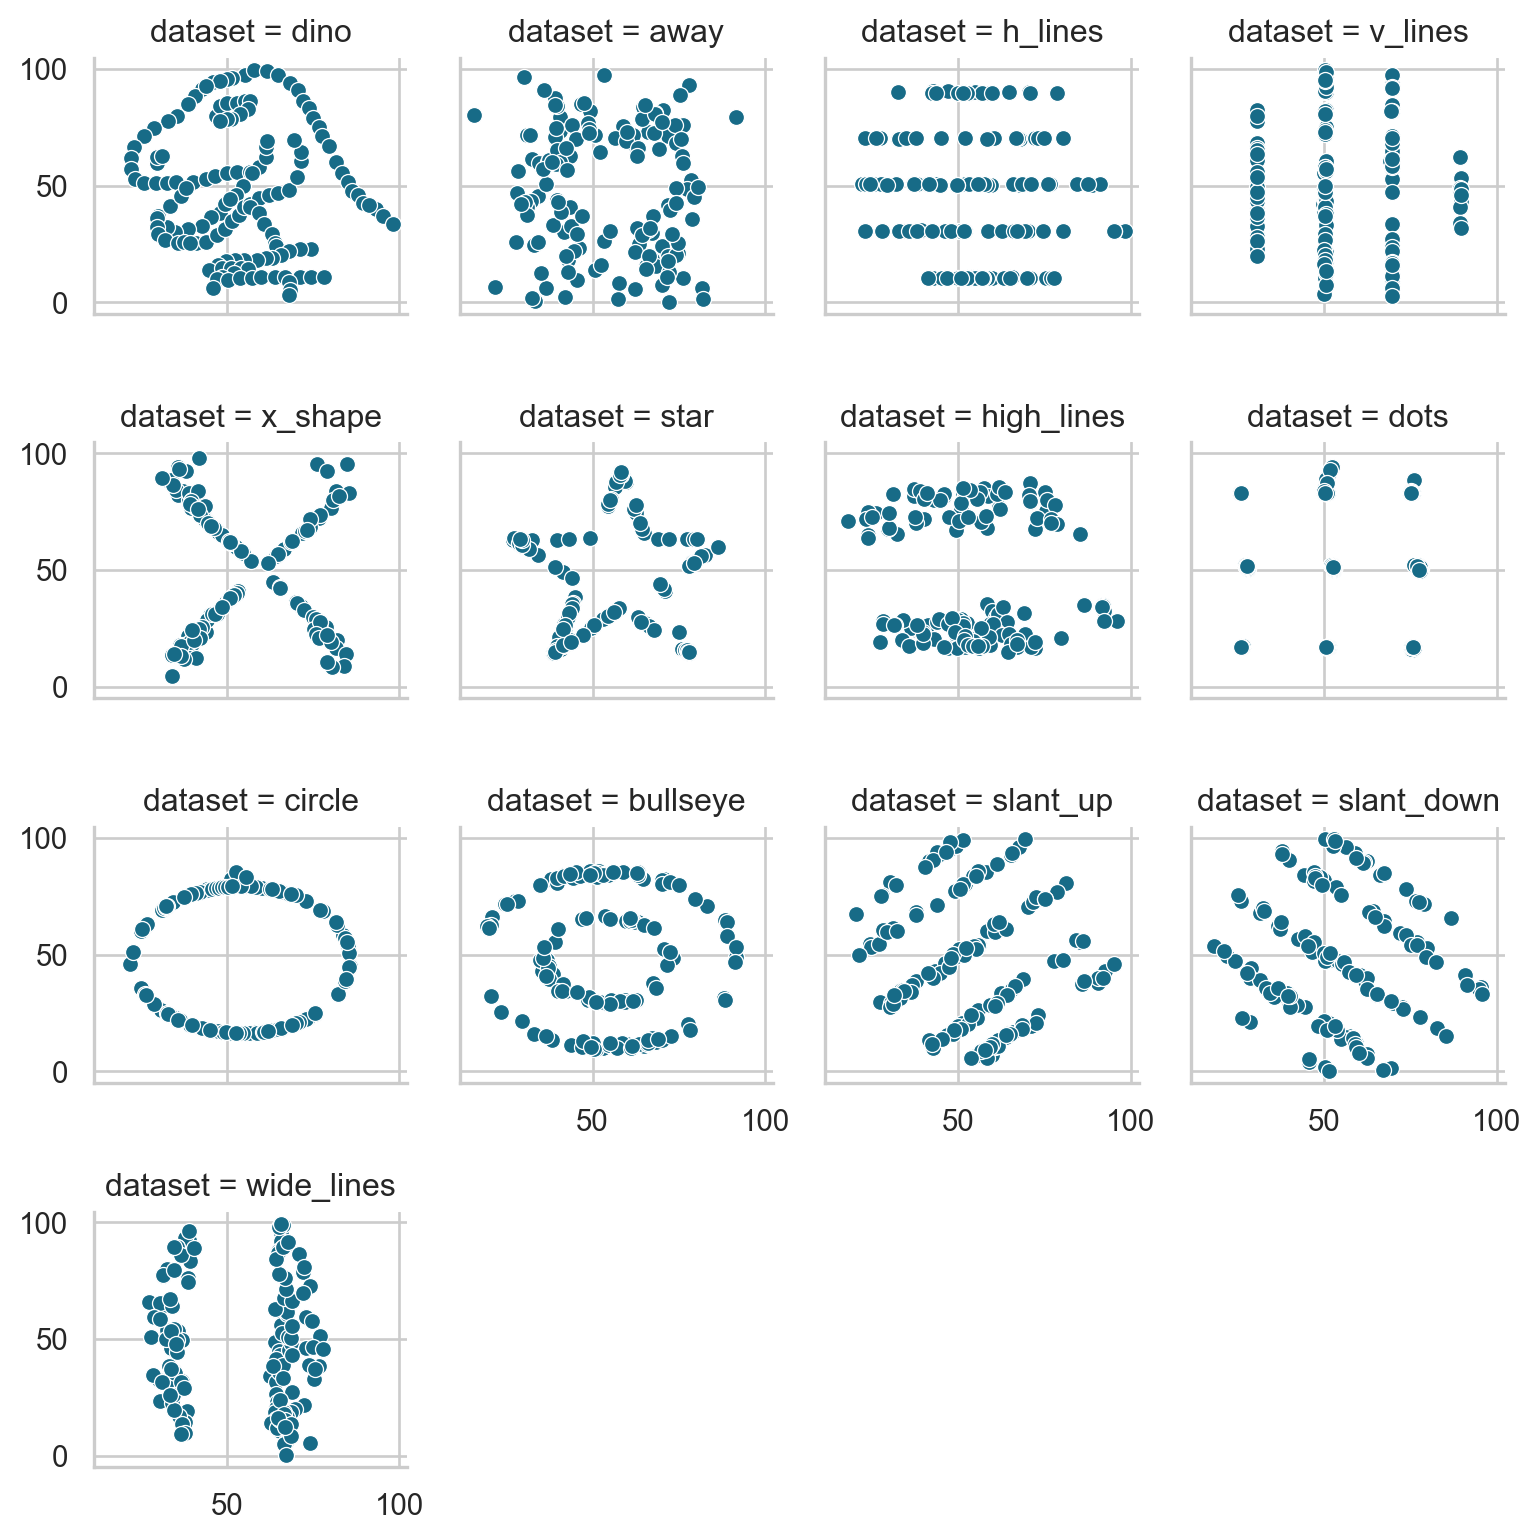
NotaInterpretação
A cobertura temporal precisa ser verificada antes de comparar períodos. Meses incompletos e datas ausentes podem produzir quedas artificiais que pertencem ao processo de coleta, não ao fenômeno estudado.
Exercício 3
Escolha dois conjuntos visualmente muito distintos e compare seus cinco resumos. O que esse exemplo ensina sobre correlação?
resumo.loc[["dino", "circle"]]| media_x | media_y | var_x | var_y | correlacao | |
|---|---|---|---|---|---|
| dataset | |||||
| dino | 54.26 | 47.83 | 281.07 | 725.52 | -0.06 |
| circle | 54.27 | 47.84 | 280.90 | 725.23 | -0.07 |
Correlação linear semelhante não implica forma semelhante, ausência de grupos ou relação linear adequada.
Desafio
Crie uma função visualizar_variavel(df, coluna) que escolha barras para uma coluna categórica e histograma + ECDF para uma coluna numérica. Inclua títulos e rótulos de eixo.
def visualizar_variavel(df, coluna):
    if pd.api.types.is_numeric_dtype(df[coluna]):
        fig, axes = plt.subplots(1, 2, figsize=(10, 3.5))
        sns.histplot(df[coluna].dropna(), bins="fd", ax=axes[0])
        sns.ecdfplot(df[coluna].dropna(), ax=axes[1])
    else:
        ordem = df[coluna].value_counts().index
        sns.countplot(data=df, y=coluna, order=ordem)
    plt.show()

visualizar_variavel(penguins, "bill_length_mm")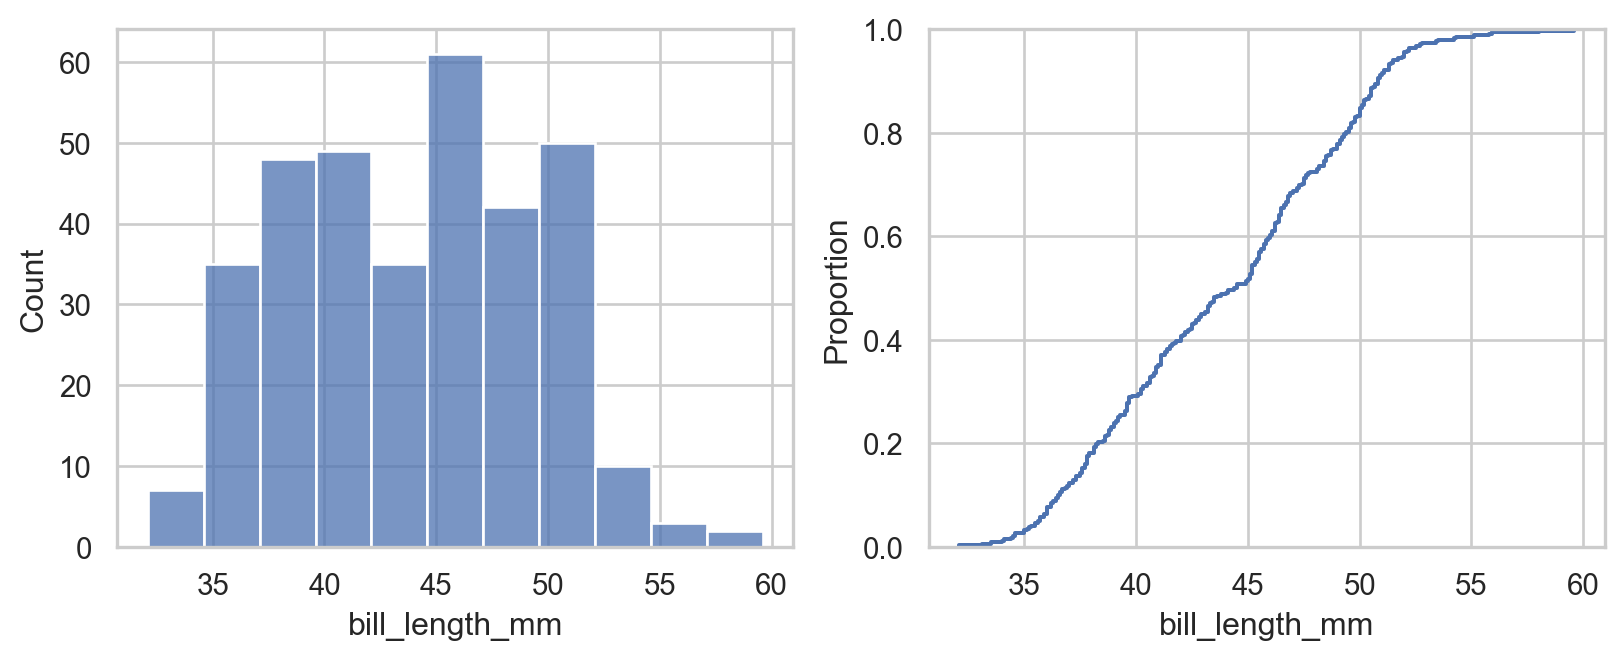
Para guardar
O gráfico é uma transformação dos dados. Toda escolha preserva algumas relações e enfraquece outras. Antes de escolher a biblioteca ou a estética, defina a pergunta e a comparação que o leitor precisa realizar.
Guia teórico consolidado
Visualização como codificação
Um gráfico mapeia variáveis para marcas — pontos, linhas e áreas — e para canais visuais, como posição, comprimento, ângulo, área, forma, cor e luminância. Para comparação quantitativa, posição em uma escala comum e comprimento alinhado costumam ser mais precisos que área ou ângulo.
O gráfico deve ser escolhido pela pergunta: barras comparam categorias, linhas representam evolução em uma dimensão ordenada, histogramas e densidades mostram forma, ECDFs respondem proporções acumuladas e dispersões mostram relações entre duas medidas.
Histograma, ECDF e KDE
O histograma depende da origem e largura dos bins. A ECDF não suaviza:
\[\widehat F(x)=\frac1n\sum_{i=1}^n\mathbf 1(X_i\le x),\]
e responde diretamente qual proporção é menor ou igual a \(x\).
A KDE estima uma densidade suave:
\[\widehat f_h(x)=\frac{1}{nh}\sum_{i=1}^nK\left(\frac{x-x_i}{h}\right).\]
Para um kernel Normal padrão, \(K\) possui variância 1. Depois da escala, cada kernel centrado em \(x_i\) possui desvio-padrão \(h\) e variância \(h^2\). Um \(h\) pequeno preserva oscilações e ruído; um \(h\) grande pode esconder grupos e assimetrias. No Seaborn, bw_adjust multiplica a largura escolhida automaticamente e não é necessariamente \(h\) nas unidades dos dados.
Resumo não substitui forma
Datasaurus e exemplos semelhantes mostram que médias, variâncias e correlações quase idênticas podem coexistir com formas radicalmente diferentes. Agregar é perder informação. Resumos devem ser acompanhados por visualização, inspeção de valores impossíveis e comparação dentro de grupos relevantes.
Condicionamento e causalidade
Facetas condicionam a análise a uma variável e ajudam a verificar se uma associação agregada persiste dentro dos grupos. Ainda assim, relação visual não implica mecanismo causal: desenho do estudo, temporalidade e variáveis de confusão continuam essenciais.