Este notebook usa pedidos reais do e-commerce brasileiro Olist para conectar distribuições amostrais, Teorema Central do Limite, intervalos de confiança e testes de hipóteses.
Ao final, você deve conseguir:
simular a distribuição amostral de uma média ou proporção;
comparar erro padrão empírico e teórico;
construir e interpretar intervalos de confiança;
simular a cobertura de um procedimento;
formular hipóteses e calcular uma estatística de teste;
estimar um p-valor por aproximação e por simulação;
investigar erros tipo I e poder estatístico.
Como estudar este capítulo
Este material conecta variação amostral e decisão estatística. O Teorema Central do Limite descreve por que, sob condições adequadas, a distribuição de muitas médias amostrais se aproxima de uma Normal. Essa aproximação permite calcular erros padrão e intervalos sem enumerar todas as amostras possíveis.
O ponto de partida não é a curva Normal, mas a repetição imaginária do estudo. Cada nova amostra produz uma média diferente. A distribuição dessas médias é a distribuição amostral; seu desvio padrão é o erro padrão. Um intervalo de confiança usa essa variabilidade para construir um procedimento que cobre o parâmetro em uma proporção conhecida de repetições.
Na parte de testes, a pergunta muda: verificamos quão incompatível a estatística observada é com uma hipótese nula. O valor-p não é a probabilidade de a hipótese ser verdadeira; ele é calculado assumindo a hipótese nula. Leia as simulações como representações de experimentos repetidos e não como tentativas de “provar” uma afirmação.
Duas aulas, um encadeamento
A Aula 10 desenvolve LGN, TCL, erro padrão e intervalos. A Aula 11 utiliza a mesma lógica de distribuição amostral para construir testes, erros tipo I e poder. O material específico e mais detalhado da Aula 11 complementa este capítulo com uma análise completa da taxa de atrasos.
Warning: Looks like you're using an outdated `kagglehub` version (installed: 0.3.13), please consider upgrading to the latest version (1.0.2).
/Users/ramosh/.cache/kagglehub/datasets/olistbr/brazilian-ecommerce/versions/2
2. Preparação
from pathlib import Pathimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport seaborn as snsfrom scipy.stats import binom, norm, tsns.set_theme(style="whitegrid", context="notebook")rng = np.random.default_rng(20260824)orders_path =next(Path(path).rglob("olist_orders_dataset.csv"))orders = pd.read_csv(orders_path)date_cols = ["order_purchase_timestamp","order_delivered_customer_date","order_estimated_delivery_date",]orders[date_cols] = orders[date_cols].apply(pd.to_datetime)orders = orders.dropna(subset=date_cols).copy()orders["delivery_days"] = ( orders["order_delivered_customer_date"]- orders["order_purchase_timestamp"]).dt.total_seconds() /86400orders["delay_days"] = ( orders["order_delivered_customer_date"]- orders["order_estimated_delivery_date"]).dt.total_seconds() /86400orders["late"] = (orders["delay_days"] >0).astype(int)orders[["delivery_days", "delay_days", "late"]].describe()
Pedidos válidos: 96,476
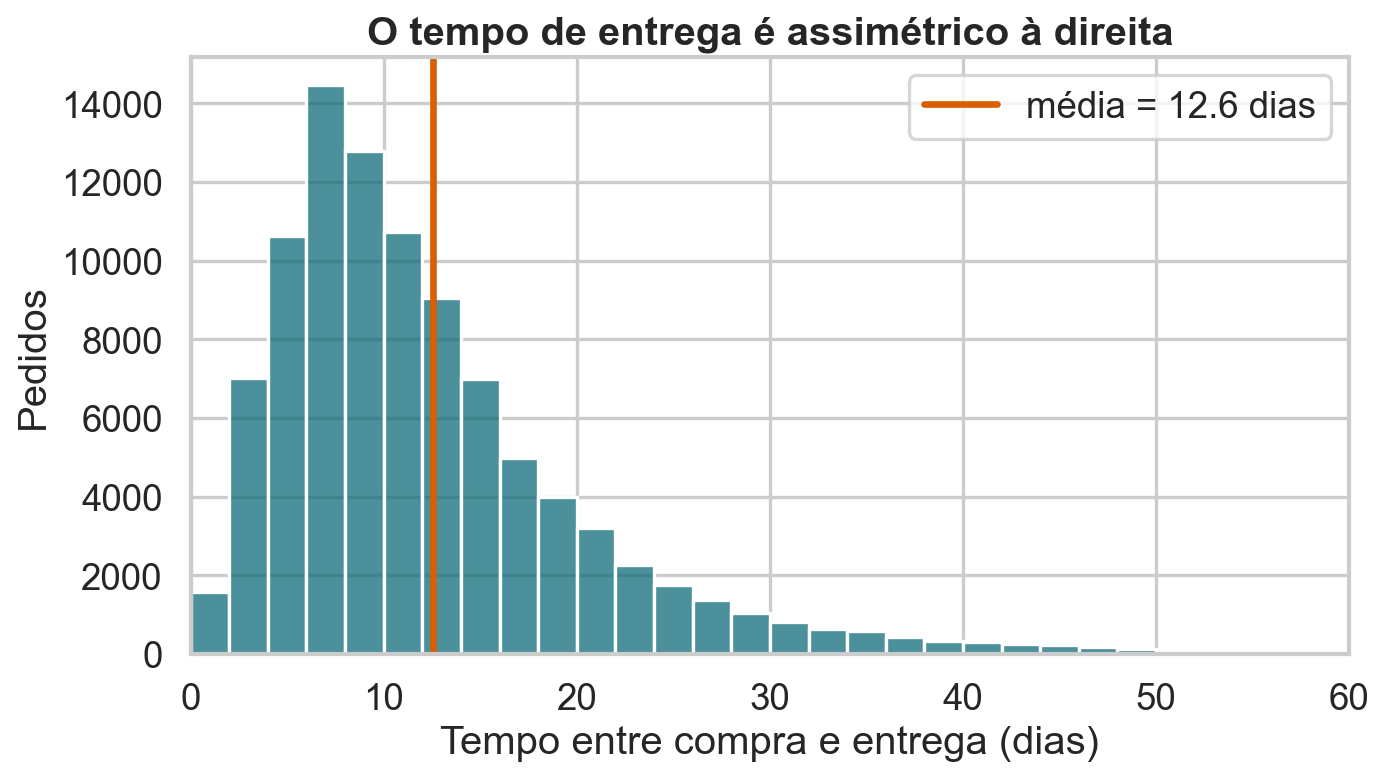
Tempo médio: 12.56 dias
Desvio padrão: 9.55 dias
Taxa de atraso: 8.11%
NotaInterpretação
A distribuição amostral descreve como a estatística varia entre amostras. O TCL aproxima a média por uma Normal quando as condições são adequadas; aumentar n reduz o erro padrão, mas não corrige viés de seleção ou dependência.
3.1 Duas amostras da mesma população
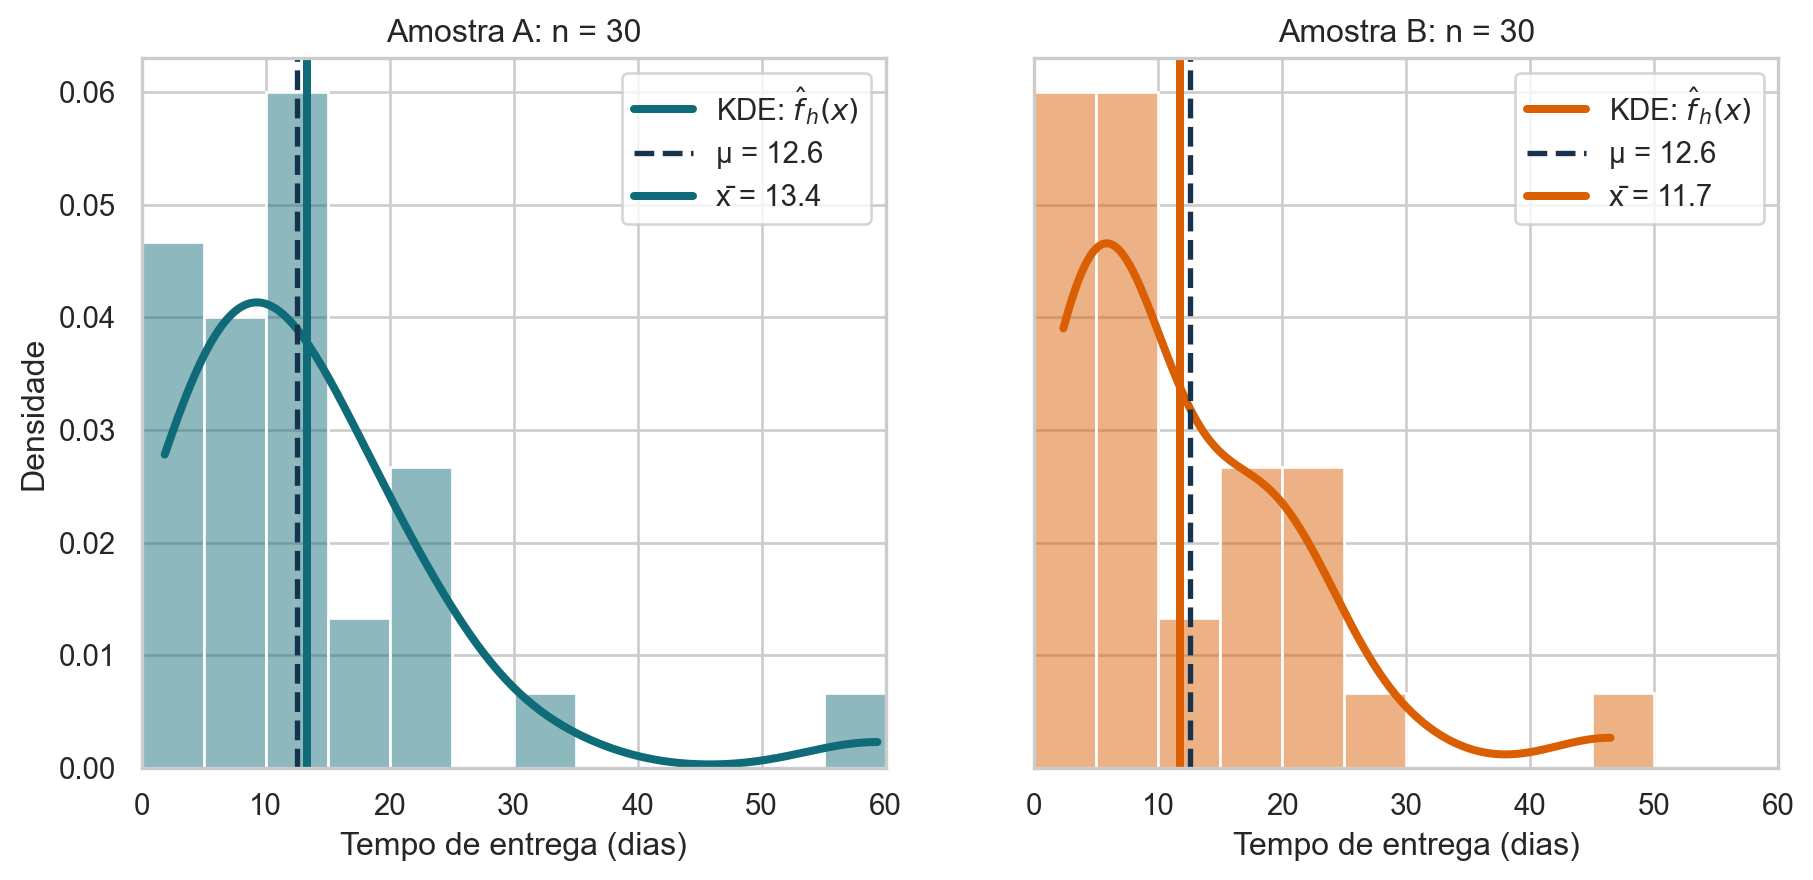
Uma amostra representa apenas uma das muitas seleções que poderiam ter sido obtidas. Para tornar essa ideia visível, retiramos duas amostras independentes de 30 pedidos da mesma população didática e usamos exatamente os mesmos intervalos e escalas nos dois histogramas. Como agora comparamos densidades, normalizamos os histogramas para que a área total seja 1. A curva sobreposta é uma estimativa não paramétrica da função densidade de probabilidade obtida por KDE (kernel density estimation).
Média da amostra A: 13.37 dias
Média da amostra B: 11.72 dias
Média populacional: 12.56 dias
NotaInterpretação
Os histogramas e as curvas \(\hat f_h(x)\) diferem mesmo com o mesmo tamanho amostral e a mesma população de origem. As médias também não coincidem entre si nem com \(\mu\). Essa diferença não indica erro no cálculo: ela representa a variabilidade natural introduzida pela seleção aleatória de apenas 30 pedidos. O estimador KDE suaviza o histograma, mas também varia de uma amostra para outra e depende da largura de banda \(h\) usada na suavização.
4. Distribuição amostral da média
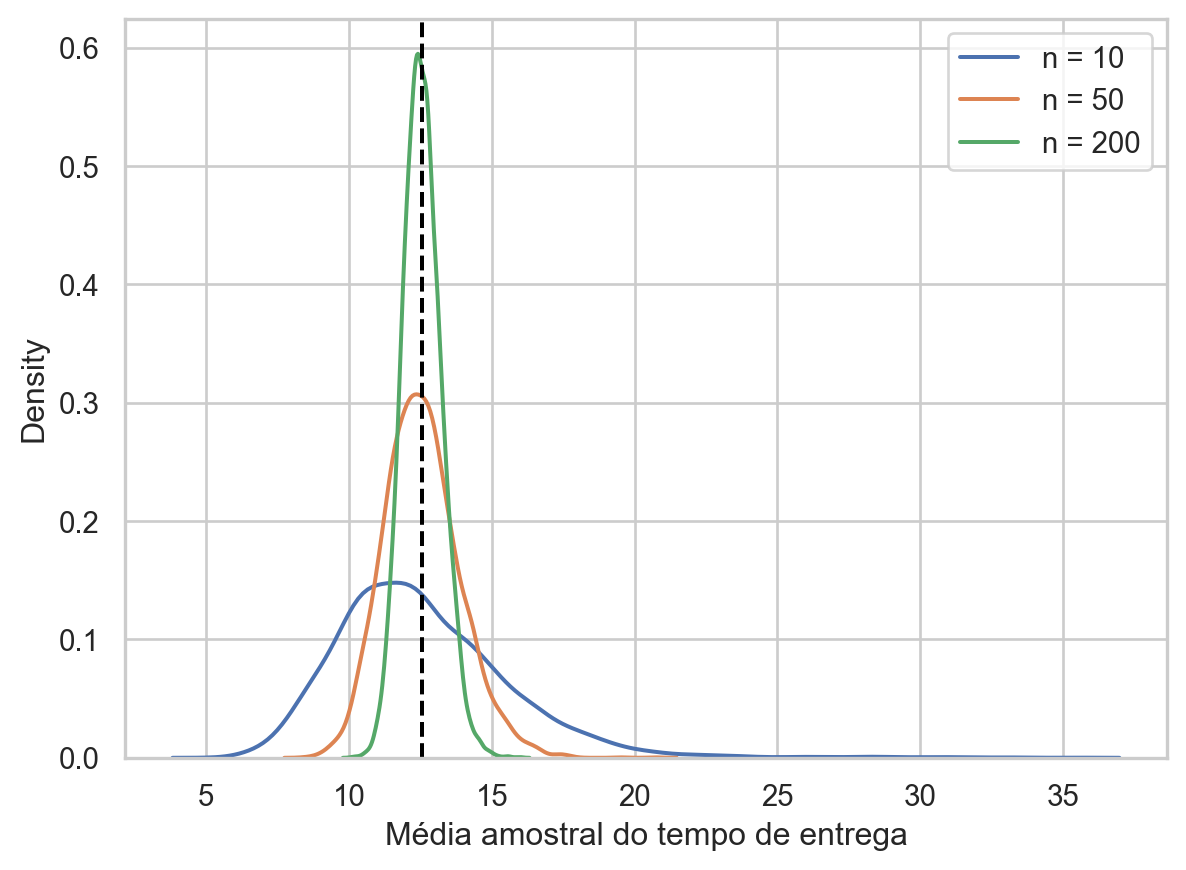
def sample_means(values, n, reps=5000):return np.array([ rng.choice(values, size=n, replace=True).mean()for _ inrange(reps) ])for n in [10, 50, 200]: means = sample_means(delivery, n) sns.kdeplot(means, label=f"n = {n}")plt.axvline(mu, color="black", linestyle="--")plt.xlabel("Média amostral do tempo de entrega")plt.legend()plt.show()
Compare o erro padrão empírico com \(\sigma/\sqrt{n}\):
for n in [10, 50, 200, 1000]: empirical = sample_means(delivery, n).std(ddof=1) theoretical = sigma / np.sqrt(n)print(f"n={n:>4}: simulado={empirical:.3f} | teórico={theoretical:.3f}")
As médias amostrais permanecem centradas perto da média populacional, enquanto sua dispersão diminui com \(n\). A concordância entre simulação e \(\sigma/\sqrt n\) mostra que o erro padrão descreve a variabilidade entre amostras, não a dispersão dos pedidos individuais.
5. Padronização
Condições usuais para aplicar o TCL
Na versão clássica para a média, o TCL parte de observações independentes e provenientes da mesma distribuição, com média \(\mu\) e variância finita \(\sigma^2\). Em aplicações, essas hipóteses precisam ser conectadas ao modo como os dados foram coletados:
Amostragem adequada: o mecanismo de seleção deve sustentar a inferência para a população de interesse. O TCL não corrige viés de seleção.
Independência: medidas repetidas, séries temporais, redes e amostras por conglomerados podem exigir métodos que representem a dependência.
Variância finita: caudas tão pesadas que produzam variância infinita ficam fora do TCL clássico.
Tamanho suficiente: não existe uma regra universal \(n\geq30\). Quanto maiores a assimetria e o peso das caudas, maior tende a ser a amostra necessária para uma aproximação Normal satisfatória.
Em uma população finita de tamanho \(N\), a amostragem sem reposição introduz dependência. Quando \(n/N<10\%\), ela costuma ser pequena. Para frações amostrais maiores, o erro padrão da média incorpora a correção
Aqui, \(N\) é o tamanho da população e \(n\) é o tamanho da amostra.
Uma amostra pequena pode esconder a cauda
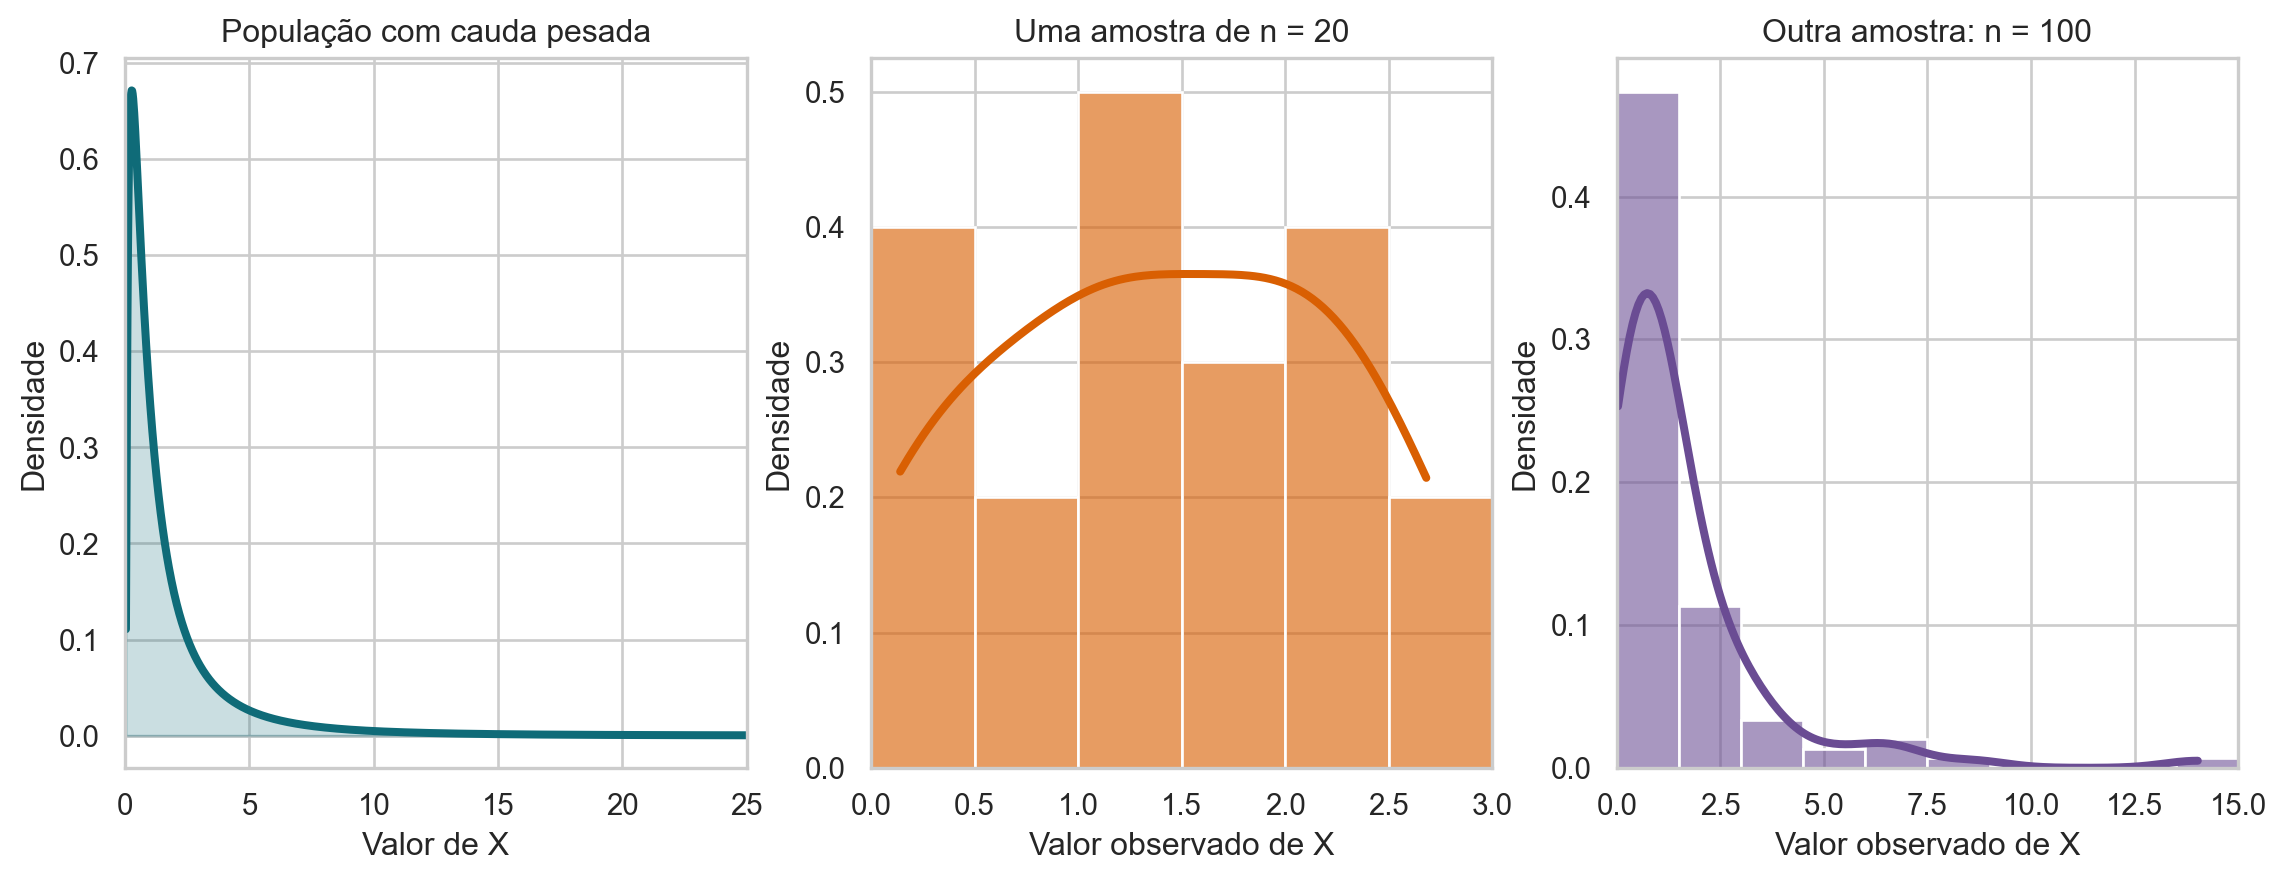
Considere uma população lognormal, fortemente assimétrica à direita. Mesmo assim, uma amostra pequena pode não conter nenhum valor raro da cauda e produzir um histograma que parece aproximadamente simétrico. Uma segunda amostra, agora com 100 observações, ajuda a visualizar como o aumento de \(n\) torna mais provável capturar valores da cauda.
sigma_log =1.15x = np.linspace(0.03, 25, 1200)population_pdf = ( np.exp(-(np.log(x) **2) / (2* sigma_log**2))/ (x * sigma_log * np.sqrt(2* np.pi)))rng_shape = np.random.default_rng(20260228)small_sample = rng_shape.lognormal(mean=0, sigma=sigma_log, size=20)larger_sample = rng_shape.lognormal(mean=0, sigma=sigma_log, size=100)fig, axes = plt.subplots(1, 3, figsize=(14.2, 4.8))axes[0].plot(x, population_pdf, color="#0f6b78", linewidth=3)axes[0].fill_between(x, population_pdf, color="#0f6b78", alpha=.22)axes[0].set(xlim=(0, 25), title="População com cauda pesada", xlabel="Valor de X", ylabel="Densidade")sns.histplot(small_sample, bins=np.linspace(0, 3, 7), stat="density", color="#d95f02", alpha=.62, ax=axes[1])sns.kdeplot(small_sample, color="#d95f02", linewidth=3, cut=0, clip=(0, 3), ax=axes[1])axes[1].set(xlim=(0, 3), title="Uma amostra de n = 20", xlabel="Valor observado de X", ylabel="Densidade")sns.histplot(larger_sample, bins=np.linspace(0, 15, 11), stat="density", color="#6a4c93", alpha=.58, ax=axes[2])sns.kdeplot(larger_sample, color="#6a4c93", linewidth=3, cut=0, clip=(0, 15), ax=axes[2])axes[2].set(xlim=(0, 15), title="Outra amostra: n = 100", xlabel="Valor observado de X", ylabel="Densidade")plt.show()print(f"Maior valor observado na amostra: {small_sample.max():.2f}")print(f"Maior valor observado com n=100: {larger_sample.max():.2f}")print(f"Percentil 99% da população: {np.exp(sigma_log *2.326):.2f}")
Maior valor observado na amostra: 2.68
Maior valor observado com n=100: 14.03
Percentil 99% da população: 14.51
NotaInterpretação
Na amostra de tamanho 20, o maior valor ficou muito abaixo do percentil 99% da população e o histograma não revelou a cauda longa. Na amostra de tamanho 100, aparecem valores bem maiores e a assimetria fica clara. O segundo resultado é mais provável com uma amostra maior, mas não é garantido em uma realização específica. Por isso, a ausência visual de assimetria em uma amostra pequena não justifica automaticamente a aproximação Normal da média.
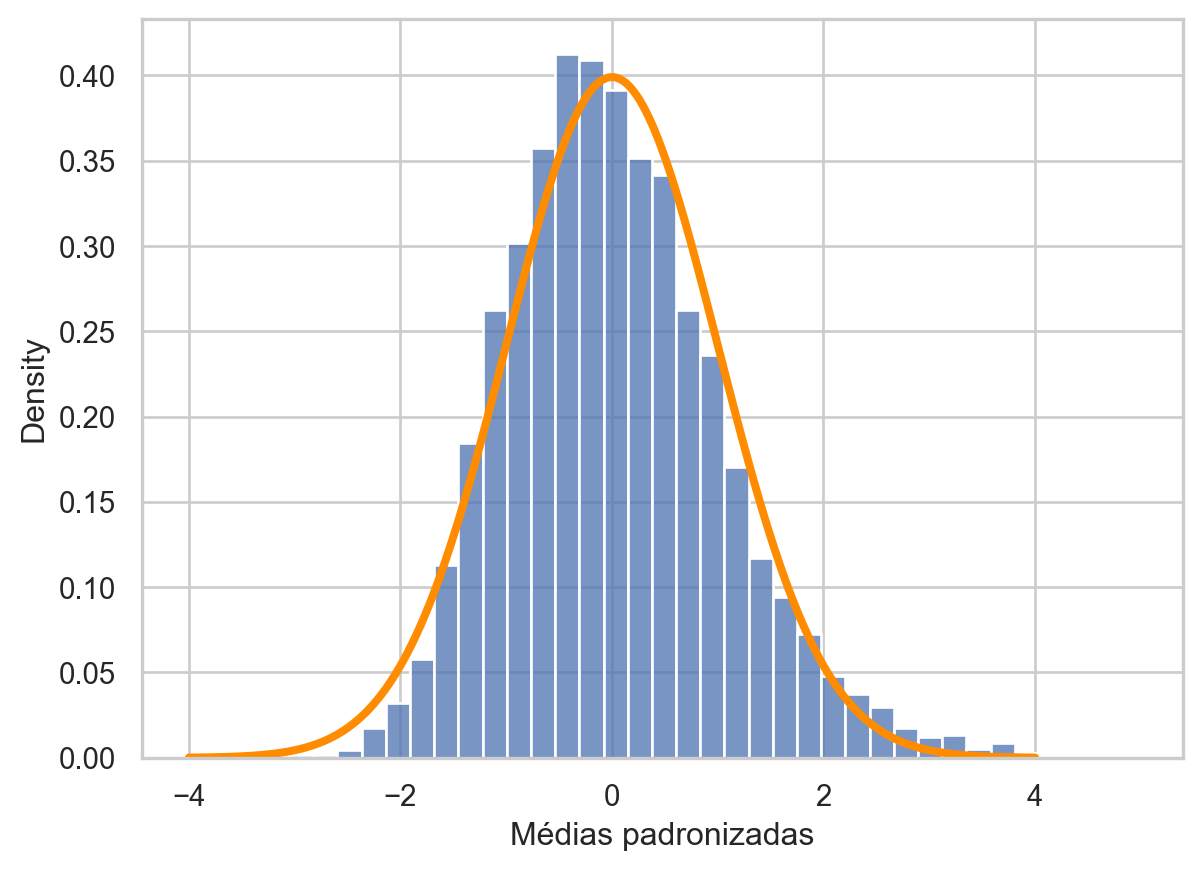
Depois de subtrair \(\mu\) e dividir pelo erro padrão, a distribuição fica aproximadamente centrada em zero e com escala unitária. A comparação com a curva Normal avalia visualmente a aproximação fornecida pelo TCL.
6. Um intervalo de confiança
Uma analogia útil vem do GPS. O pino no mapa funciona como uma estimativa pontual: a média amostral \(\bar X\) fornece uma localização específica para a média populacional \(\mu\). Essa estimativa é informativa, mas sozinha não mostra quanto poderia variar se repetíssemos a amostragem.
O círculo de precisão do GPS funciona como uma região de confiança. Em uma dimensão, seu análogo é o intervalo \([L,U]\), que reúne valores plausíveis para \(\mu\) de acordo com a variabilidade amostral. Aumentar a região eleva a frequência com que o procedimento cobre o parâmetro, mas diminui a precisão da estimativa.
NotaA analogia e a interpretação frequentista
Imagine repetir a coleta e obter um novo pino e uma nova região a cada amostra. Um procedimento de 95% produz intervalos que contêm o parâmetro fixo em aproximadamente 95% dessas repetições. Depois que observamos uma amostra e calculamos seu intervalo, ele contém ou não contém \(\mu\).
O TCL fornece, sob as condições discutidas anteriormente, a aproximação
Aqui, \(\bar X\) é a média amostral, \(\mu\) é a média populacional, \(\sigma\) é o desvio padrão populacional e \(n\) é o tamanho da amostra. O termo \(\sigma/\sqrt n\) é o erro padrão de \(\bar X\).
Para obter uma faixa para \(\mu\), primeiro multiplicamos toda a desigualdade por \(\sigma/\sqrt n\). Esse termo é positivo, portanto as desigualdades mantêm o sentido:
Na prática, \(\sigma\) costuma ser desconhecido. O exemplo abaixo substitui o erro padrão populacional por sua estimativa \(s/\sqrt n\), em que \(s\) é o desvio padrão calculado na amostra.
Média amostral: 11.98
Erro padrão: 0.80
IC 95%: [10.41, 13.56]
NotaInterpretação
O intervalo combina a estimativa observada com sua incerteza. Os 95% referem-se ao desempenho do procedimento em repetições: não significam que exista 95% de probabilidade de o parâmetro fixo estar neste intervalo já calculado.
7. Cobertura
def confidence_interval(values, n=100, z_star=1.96): sample = rng.choice(values, size=n, replace=True) mean = sample.mean() se = sample.std(ddof=1) / np.sqrt(n)return mean - z_star * se, mean + z_star * seintervals = [confidence_interval(delivery) for _ inrange(5000)]coverage = np.mean([lower <= mu <= upper for lower, upper in intervals])print(f"Cobertura simulada: {coverage:.2%}")
Cobertura simulada: 93.32%
NotaInterpretação
A cobertura simulada deve ficar próxima do nível nominal. Aumentar o valor crítico eleva a cobertura, mas também produz intervalos mais largos; reduzir o valor crítico faz a troca oposta.
DicaUma previsão infalível
Perguntado sobre quanto tempo falta para entregar o código pronto, um desenvolvedor responde: “entre 5 minutos e 6 meses”. A faixa tem grande chance de conter o prazo verdadeiro, mas sua precisão e sua utilidade são praticamente nulas. Intervalos de confiança também envolvem esse compromisso: aumentar a cobertura exige, mantidos os demais fatores, aceitar intervalos mais largos.
Altere z_star para 1,645 e 2,576. Compare cobertura e largura média.
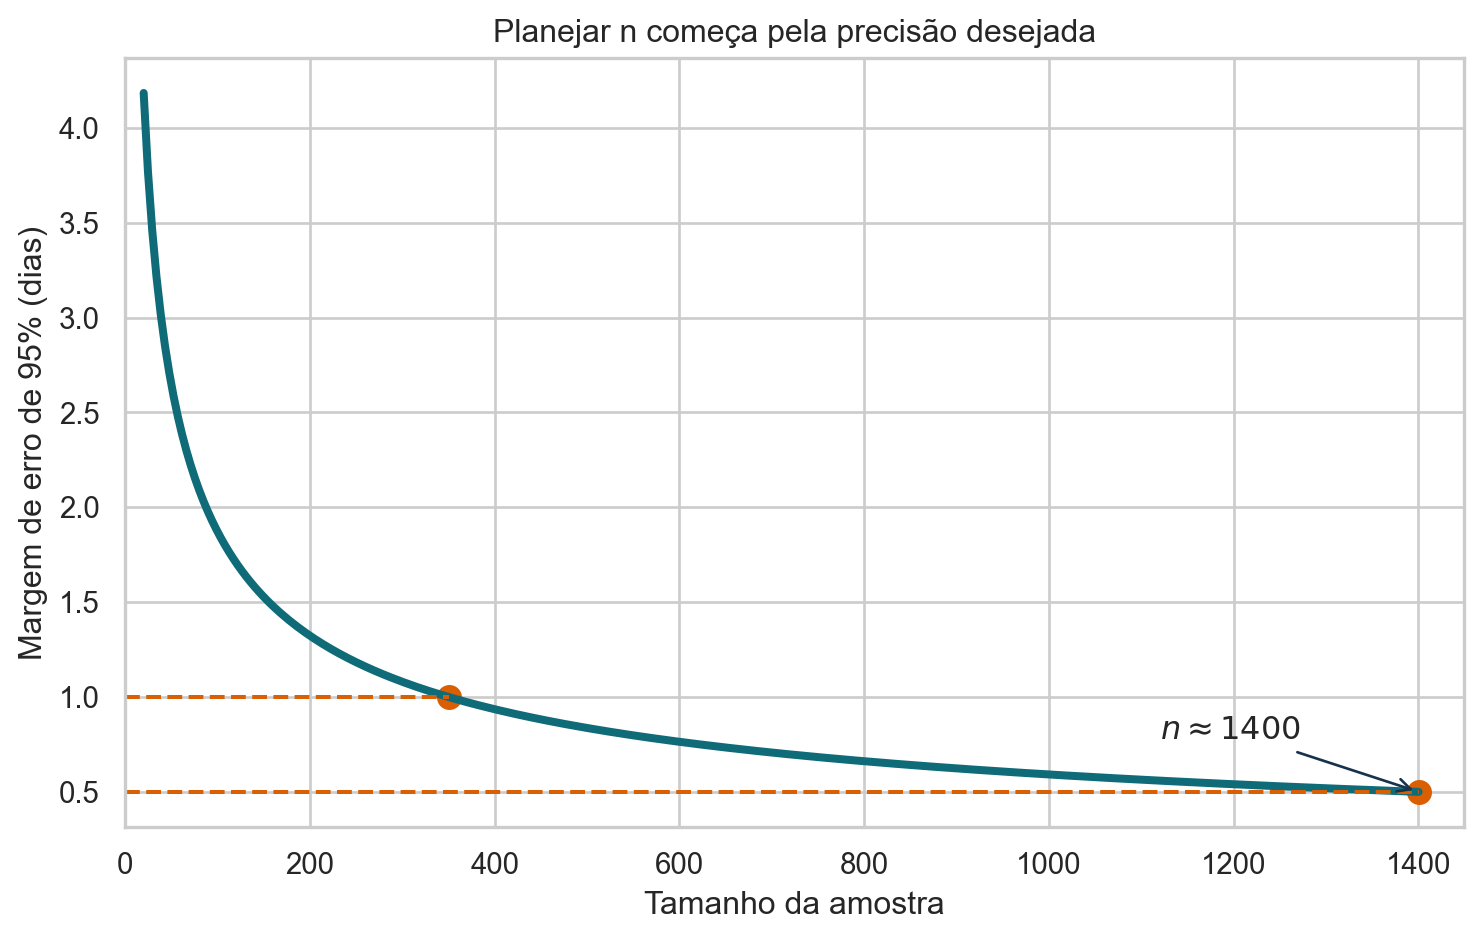
A curva abaixo prolonga a relação entre margem de erro e tamanho amostral até o ponto necessário para obter uma margem de aproximadamente meio dia. A linha azul termina em \(n\approx1400\), deixando visível a interseção com a meta \(m=0{,}5\).
need_half_day = (1.96* sigma /0.5) **2ns_margin = np.linspace(20, need_half_day, 300)margin_curve =1.96* sigma / np.sqrt(ns_margin)plt.figure(figsize=(9, 5.2))plt.plot(ns_margin, margin_curve, color="#0f6b78", linewidth=3)for target in [1.0, 0.5]: need = (1.96* sigma / target) **2 plt.hlines(target, xmin=0, xmax=need, color="#d95f02", linewidth=1.5, linestyle="--") plt.scatter(need, target, color="#d95f02", s=70)plt.annotate(r"$n\approx 1400$", xy=(need_half_day, 0.5), xytext=(1120, 0.78), arrowprops={"arrowstyle": "->", "color": "#17324d"})plt.xlim(0, 1450)plt.xlabel("Tamanho da amostra")plt.ylabel("Margem de erro de 95% (dias)")plt.title("Planejar n começa pela precisão desejada")plt.show()
NotaInterpretação
Como \(n\) depende do inverso do quadrado da margem, reduzir a margem de erro pela metade exige aproximadamente quatro vezes mais observações, mantidos o nível de confiança e a variabilidade.
8.1 Amostras pareadas
Em alguns estudos, as duas medidas comparadas pertencem à mesma unidade. Isso acontece em desenhos antes e depois, em pares formados por características semelhantes e na comparação entre uma previsão e o resultado observado para o mesmo caso. Tratar essas medidas como duas amostras independentes desperdiça o pareamento e calcula a incerteza de forma inadequada.
Para cada par, definimos uma única variável diferença:
\[
D_i=Y_i-X_i.
\]
\(X_i\) é a primeira medida da unidade \(i\), \(Y_i\) é a segunda medida e \(D_i\) é a mudança observada dentro do par. O problema passa a ser uma inferência para a média populacional das diferenças, \(\mu_D=E[D_i]\). A estimativa é
\[
\bar D=\frac{1}{n}\sum_{i=1}^nD_i,
\]
e seu erro padrão estimado é \(s_D/\sqrt n\), em que \(s_D\) é o desvio padrão das diferenças. Quando as condições da distribuição t são adequadas, usamos
\[
\bar D\pm t^*_{n-1}\frac{s_D}{\sqrt n}.
\]
O valor \(t^*_{n-1}\) é o quantil da distribuição t com \(n-1\) graus de liberdade. Ele aparece porque o desvio padrão populacional das diferenças, \(\sigma_D\), é desconhecido e precisa ser substituído pelo desvio padrão amostral \(s_D\). Essa substituição acrescenta incerteza. Se as diferenças são Normais, a estatística
\[
T=\frac{\bar D-\mu_D}{s_D/\sqrt n}
\]
segue exatamente uma distribuição t com \(n-1\) graus de liberdade. A distribuição t tem caudas mais pesadas que a Normal, produzindo valores críticos um pouco maiores em amostras pequenas. À medida que \(n\) cresce, \(t_{n-1}\) converge para \(N(0,1)\). A regra \(n>30\) é uma referência prática: nesse ponto, os quantis já costumam ser próximos, embora a convergência seja gradual. Para um intervalo de 95%, por exemplo, \(t^*_{29}=2{,}045\), enquanto \(z^*=1{,}96\).
As duas medidas dentro de cada par podem ser dependentes. A condição relevante é que as diferenças de pares distintos sejam independentes, além de uma forma aproximadamente Normal para \(D_i\) quando \(n\) é pequeno.
Exemplo numérico simples
Considere cinco pedidos. \(X_i\) é o prazo estimado, \(Y_i\) é o tempo efetivo de entrega e \(D_i=Y_i-X_i\). Uma diferença negativa representa uma entrega anterior ao prazo estimado.
Média das diferenças: -1.20 dias
Desvio padrão das diferenças: 1.48 dias
Erro padrão: 0.66 dia
t* com 4 graus de liberdade: 2.776
IC de 95%: [-3.04, 0.64] dias
NotaInterpretação
A diferença média observada é \(-1{,}20\) dia: nessa pequena amostra, as entregas ocorreram, em média, antes do previsto. O intervalo \([-3{,}04;0{,}64]\) contém zero, portanto os dados também são compatíveis com ausência de diferença média. O cálculo usa a variabilidade das cinco diferenças, não os desvios padrão de \(X\) e \(Y\) separadamente.
Na base Olist, a data estimada e a data efetiva de entrega pertencem ao mesmo pedido. Portanto, delay_days já representa uma diferença pareada:
Número de pares: 96,476
Diferença média: -11.18 dias
Erro padrão: 0.033 dia
IC de 95% para a diferença média: [-11.24, -11.11]
NotaInterpretação
Valores negativos de delay_days indicam entrega anterior à data estimada. O intervalo estima a antecipação ou o atraso médio, mantendo juntas as duas datas de cada pedido. Ele não compara dois grupos independentes.
8.2 Resposta da atividade de comunicação
Para \(n=100\), \(\bar x=13{,}1\) dias e \(s=9\) dias, o erro padrão estimado é
Usando um procedimento que cobre \(\mu\) em cerca de 95% das repetições, estimamos o tempo médio da população-alvo entre 11,34 e 14,86 dias. Essa frase descreve a cobertura do procedimento, não uma probabilidade de 95% atribuída ao parâmetro fixo.
Mantendo o mesmo nível de confiança e a mesma variabilidade, reduzir a margem pela metade exige aproximadamente quadruplicar a amostra, passando de 100 para 400 pedidos. A suposição mais preocupante é que os pedidos representem a população-alvo e sejam aproximadamente independentes. Uma amostra concentrada em poucos vendedores, clientes ou períodos pode produzir dependência e viés.
A estatística \(z\) mede quantos erros padrão separam a taxa observada dos 8% postulados por \(H_0\). O valor-p é a probabilidade, sob essa hipótese, de observar uma taxa pelo menos tão alta quanto a encontrada.
Os valores-p Normal, binomial exato e simulado devem ser próximos quando a aproximação Normal é adequada e a simulação é grande. Diferenças pequenas decorrem da aproximação contínua e do erro de Monte Carlo; em amostras pequenas, prefira o cálculo exato.
Como os dados são gerados com \(p=0{,}08\), toda rejeição é um falso positivo. A proporção simulada deve ficar próxima de \(\alpha\), mostrando o significado operacional do nível de significância.
O poder cresce quando a taxa verdadeira se afasta de 8%, pois o sinal se torna maior em relação ao ruído amostral. Em 8%, a proporção de rejeições representa erro tipo I, não poder para uma diferença real.
14. Investigue
Como a distribuição amostral muda para \(n=10\), 50 e 200?
Qual tamanho amostral fornece margem de erro de meio dia?
Compare intervalos de 90%, 95% e 99%.
Compare os p-valores exato, Normal e simulado.
Como o poder muda com \(n\) e com a taxa verdadeira?
Repita o teste bilateral e explique a diferença.
Fonte
Brazilian E-Commerce Public Dataset by Olist, disponibilizado no Kaggle em olistbr/brazilian-ecommerce. O conjunto reúne cerca de 100 mil pedidos reais, anonimizados, realizados entre 2016 e 2018.
Guia teórico consolidado
Distribuição amostral, LGN e TCL
A distribuição dos dados individuais não é a distribuição da média amostral. Para observações i.i.d. com média \(\mu\) e variância finita \(\sigma^2\):
Aqui, \(X_i\) é a observação aleatória da unidade \(i\); \(\bar X=n^{-1}\sum_{i=1}^nX_i\) é o estimador da média; \(\mu=E[X_i]\) e \(\sigma^2=\operatorname{Var}(X_i)\) são parâmetros populacionais; \(n\) é o tamanho amostral. \(\operatorname{SE}(\bar X)\) é o desvio padrão de \(\bar X\) entre amostras repetidas, não o desvio padrão dos valores individuais.
A Lei dos Grandes Números afirma que \(\bar X_n\) converge para \(\mu\). O Teorema Central do Limite descreve a distribuição do erro:
O símbolo \(\xrightarrow{d}\) indica convergência em distribuição e \(N(0,1)\) denota a Normal padrão. A variável padronizada subtrai o centro \(\mu\) e mede o erro na unidade natural de variabilidade de \(\bar X\), que é \(\sigma/\sqrt n\).
LGN responde “para onde vai?”; TCL responde “como oscila?”. O TCL não afirma que os dados originais sejam Normais.
Condições e aproximação
Independência ou dependência suficientemente fraca, amostra representativa e variância finita são centrais. Assimetria forte e caudas pesadas podem exigir amostras maiores. Em amostragem sem reposição de uma população finita, a fração amostral pode exigir correção do erro padrão.
Intervalos de confiança
Substituindo \(\sigma\) por uma estimativa adequada, um intervalo aproximado tem a forma
\(\theta\) é o parâmetro-alvo; \(\widehat\theta\) é seu estimador; \(\operatorname{SE}(\widehat\theta)\) mede a oscilação do estimador; e \(z^*\) é o quantil da distribuição de referência determinado pelo nível de confiança. Para uma média com \(\sigma\) desconhecido, substituímos o erro padrão por \(s/\sqrt n\) e, em amostras pequenas sob condições adequadas, usamos um quantil da distribuição t.
A interpretação frequentista é sobre o procedimento: em repetidas amostras, aproximadamente 95% dos intervalos de 95% cobririam o parâmetro. Depois de calculado, o intervalo específico cobre ou não cobre o parâmetro; não atribuímos 95% de probabilidade a um parâmetro fixo.
Mais confiança aumenta a largura. A margem diminui como \(1/\sqrt n\), portanto reduzir a margem pela metade exige aproximadamente quadruplicar a amostra. Nenhuma fórmula de intervalo corrige seleção enviesada ou mensuração ruim.
Questões de revisão da Aula 10
Qual é a diferença entre as afirmações da LGN e do TCL?
O que significa dizer que um procedimento produz intervalos de 95% de confiança?
Respostas comentadas
A LGN descreve a convergência de \(\bar X_n\) para \(\mu\); o TCL descreve a distribuição aproximadamente Normal do erro padronizado.
Em repetições do procedimento, aproximadamente 95% dos intervalos cobrem o parâmetro fixo. Não é uma probabilidade posterior sobre o intervalo já observado.