Este notebook transforma a pergunta operacional da Aula 11 em um teste completo. Você irá formular hipóteses, construir a distribuição nula, comparar três formas de calcular o valor-p e estudar erros tipo I, poder e importância prática. Ao final, organizará essas ideias em um teste A/B didático no contexto da Olist.
Como estudar este capítulo
Um teste de hipóteses é um procedimento para medir compatibilidade entre dados e uma afirmação de referência. Ele começa antes do cálculo: definimos a população, o parâmetro, a hipótese nula, a alternativa e uma estatística que represente o afastamento relevante.
Depois construímos o comportamento da estatística se a hipótese nula fosse verdadeira. O valor observado é comparado com essa distribuição de referência. O valor-p corresponde à proporção de resultados nulos tão ou mais extremos que o observado, na direção definida pela alternativa.
O capítulo apresenta cálculo exato, aproximação Normal e simulação para a mesma pergunta. Compare os métodos e observe que todos dependem do mesmo modelo nulo. Ao final, separe claramente evidência estatística, tamanho do efeito e importância prática: rejeitar \(H_0\) não informa, por si só, se a diferença é grande ou útil.
A seção final transforma o problema operacional em um experimento A/B. Como a base Olist não registra uma intervenção randomizada, os grupos e resultados do A/B são explicitamente simulados; a base real fornece apenas o contexto e uma ordem de grandeza plausível para a taxa de atraso.
1. A base e a pergunta
Usaremos o Brazilian E-Commerce Public Dataset by Olist, disponível no Kaggle. Cada linha da tabela de pedidos representa um pedido. As colunas centrais são as datas de compra, entrega efetiva e entrega prevista. A pergunta é:
A taxa de pedidos atrasados excede o limite operacional de 8%?
Warning: Looks like you're using an outdated `kagglehub` version (installed: 0.3.13), please consider upgrading to the latest version (1.0.2).
3. Descrição rápida
orders[["delay_days", "late"]].describe()
delay_days
late
count
96476.000000
96476.000000
mean
-11.179120
0.081129
std
10.186113
0.273035
min
-146.016123
0.000000
25%
-16.244384
0.000000
50%
-11.948941
0.000000
75%
-6.390000
0.000000
max
188.975081
1.000000
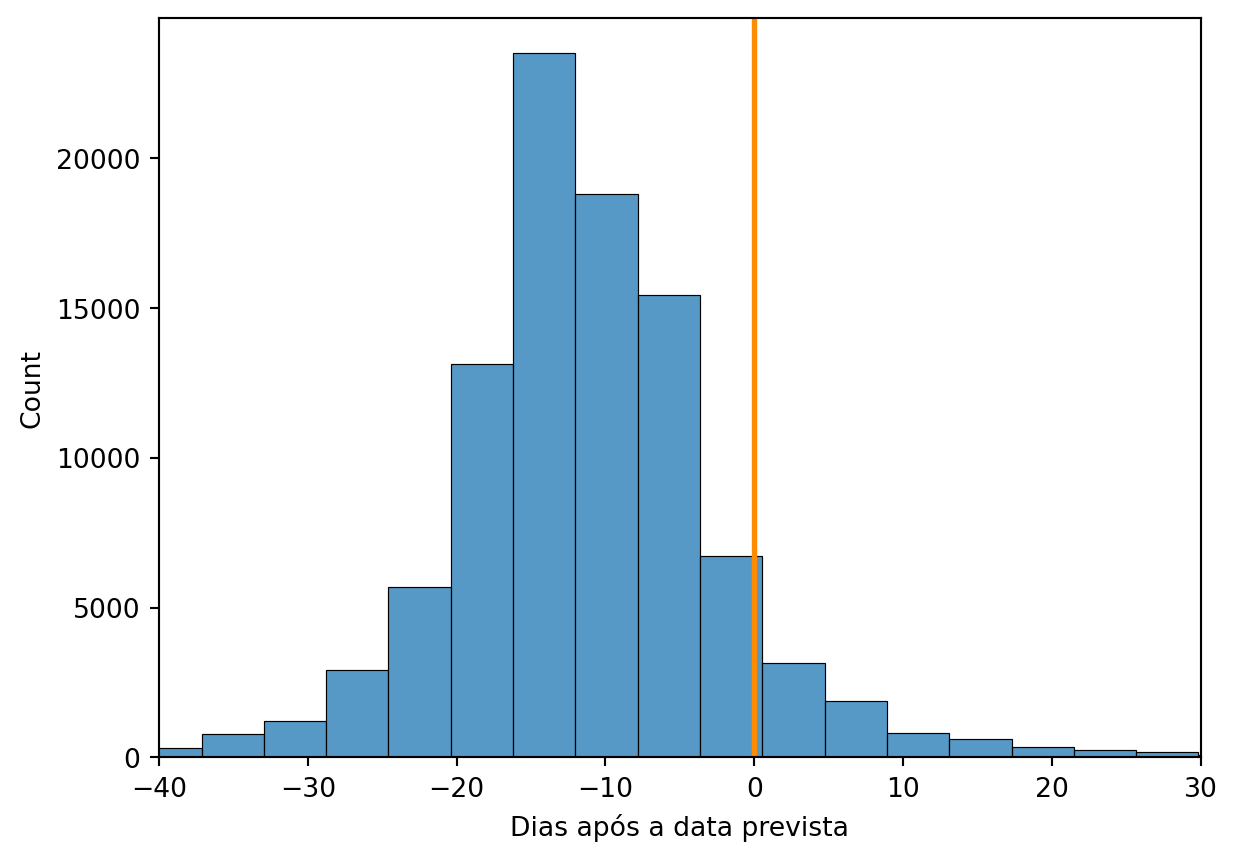
sns.histplot(orders["delay_days"], bins=80)plt.axvline(0, color="darkorange", linewidth=2)plt.xlim(-40, 30)plt.xlabel("Dias após a data prevista")plt.show()
NotaInterpretação
Interprete o resultado sob H0: o valor-p mede quão extremo seria o observado no modelo nulo. Ele não é a probabilidade de H0 e deve ser lido junto com efeito, incerteza e regra de decisão.
Interprete a unidade: late=1 indica pedido entregue depois da previsão, e não pedido cancelado ou ainda em trânsito. Observe também que a base contém apenas pedidos com as três datas disponíveis.
4. População didática e amostra
Trataremos os pedidos válidos como uma população didática e retiraremos uma amostra de 1.200 pedidos. Isso permite repetir o experimento em simulações.
A taxa amostral é a evidência observada que será comparada aos 8% de \(H_0\). Uma nova amostra produziria outro valor; o teste precisa quantificar se a diferença atual é grande em relação à variabilidade esperada.
A estatística será \(\widehat p\), a proporção de atrasos. Sob \(H_0\), o número de atrasos em \(n\) pedidos segue uma Binomial com parâmetros \(n\) e \(p_0=0{,}08\).
6. Distribuição nula por simulação
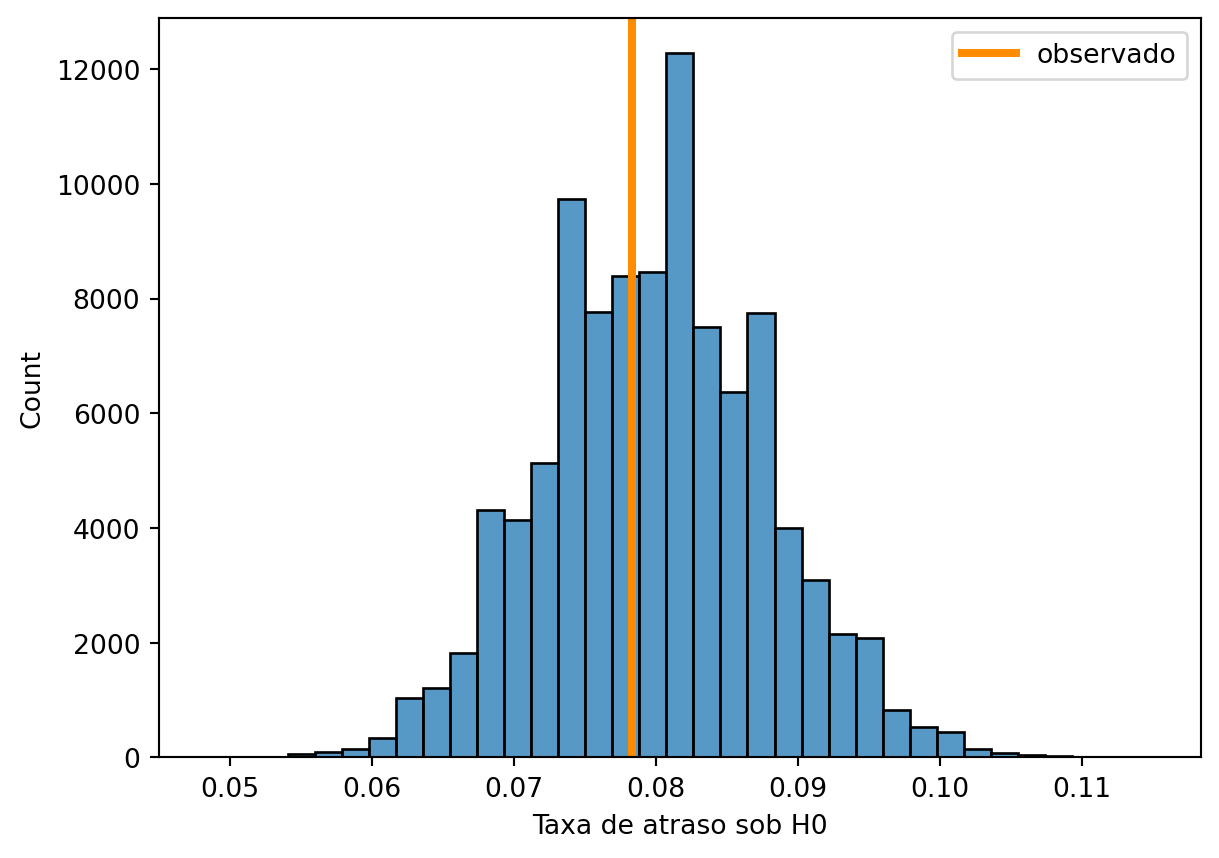
p0 =0.08null_counts = rng.binomial(n=n, p=p0, size=100_000)null_proportions = null_counts / nsns.histplot(null_proportions, bins=35)plt.axvline(p_hat, color="darkorange", linewidth=3, label="observado")plt.xlabel("Taxa de atraso sob H0")plt.legend()plt.show()
NotaInterpretação
A distribuição nula mostra as taxas que surgiriam apenas por flutuação amostral se \(p=8\%\). A posição da linha observada nessa distribuição determina quão incompatíveis são os dados com \(H_0\).
simulação                              0.026440
Binomial exata                         0.026835
Normal com correção de continuidade    0.024504
dtype: float64
Para a amostra usada nos slides, \(n=1200\), \(k=115\) e \(\widehat p=0{,}0958\). Os resultados esperados são aproximadamente 0,0265 por simulação, 0,0268 pela Binomial exata e 0,0245 pela aproximação Normal com correção de continuidade.
NotaPor que usamos 114,5?
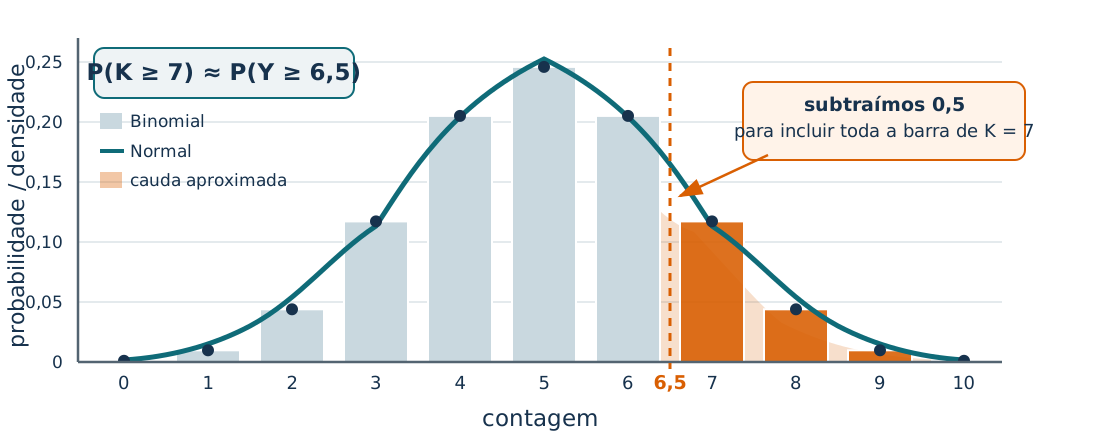
A Binomial concentra probabilidade nos valores inteiros. Quando a aproximamos por uma Normal contínua, representamos a massa associada ao inteiro \(k\) pela área da curva entre os pontos médios \(k-0{,}5\) e \(k+0{,}5\). Para incluir toda a massa de \(k\), uma probabilidade acumulada até \(k\) precisa terminar na borda direita, \(k+0{,}5\). Uma cauda que começa em \(k\) precisa começar na borda esquerda, \(k-0{,}5\):
Assim, somamos 0,5 ao aproximar uma probabilidade acumulada até \(k\) e subtraímos 0,5 ao aproximar uma cauda que começa em \(k\). Neste exemplo, \(K\ge115\) inclui os inteiros 115, 116 e assim por diante. A cauda Normal equivalente começa em 114,5, logo \(P(K\ge115)\approx P(Y\ge114{,}5)\).
A pequena diferença restante decorre do erro de Monte Carlo na simulação e do fato de a Normal ainda ser uma aproximação.
Explique por que os resultados são próximos e em quais amostras a aproximação Normal poderia falhar.
NotaInterpretação
O cálculo exato usa a distribuição binomial; a simulação a reproduz com erro de Monte Carlo; e a Normal é uma aproximação. A concordância é esperada quando \(np_0\) e \(n(1-p_0)\) não são pequenos, mas pode falhar com amostras pequenas ou probabilidades próximas de zero ou um.
“Não rejeitar” não significa aceitar que a taxa seja exatamente 8%. Significa que a amostra não forneceu evidência suficiente contra esse modelo no nível escolhido.
9. Erro tipo I
O erro tipo I ocorre quando rejeitamos \(H_0\) apesar de ela ser verdadeira. Para um teste calibrado com nível exato \(\alpha\),
\[
P_{H_0}(\text{rejeitar }H_0)=\alpha,
\]
em que \(P_{H_0}\) indica que a probabilidade é calculada sob a hipótese nula. Portanto, se repetíssemos o estudo muitas vezes em situações nas quais \(H_0\) fosse verdadeira, a fração de rejeições tenderia a \(\alpha\).
Há uma precisão importante: a definição geral de um teste de nível \(\alpha\) exige
\[
P_{H_0}(\text{rejeitar }H_0)\leq\alpha.
\]
A igualdade ocorre quando o teste usa exatamente todo o nível disponível. Em testes com estatísticas discretas, como certos testes binomiais exatos, nem sempre existe uma região de rejeição cuja probabilidade sob \(H_0\) seja exatamente \(\alpha\). Nesse caso, o teste costuma ser conservador e sua probabilidade real de erro tipo I fica abaixo de \(\alpha\).
def rejection_rate(true_p, n=1200, reps=10000, alpha=.05): counts = rng.binomial(n, true_p, size=reps) p_values = binom.sf(counts -1, n=n, p=.08)return np.mean(p_values < alpha)print("Erro tipo I sob p=8%:", rejection_rate(.08))
Erro tipo I sob p=8%: 0.0411
NotaInterpretação
Sob \(H_0\), qualquer rejeição é um erro tipo I. A taxa simulada próxima de 5% confirma que \(\alpha\) limita a frequência de falsos positivos no longo prazo, e não a probabilidade de esta decisão específica estar errada.
10. Poder
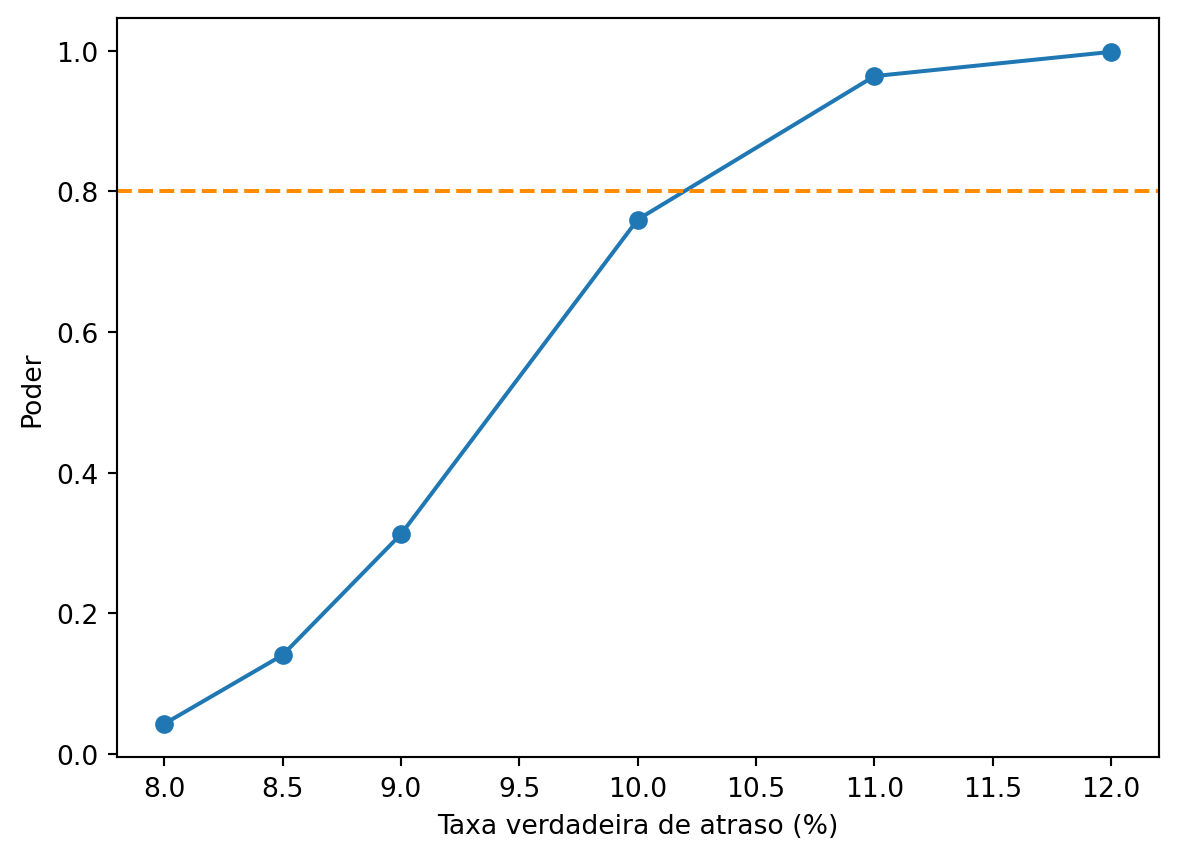
effects = np.array([.08, .085, .09, .10, .11, .12])power = [rejection_rate(p) for p in effects]plt.plot(100*effects, power, marker="o")plt.axhline(.80, color="darkorange", linestyle="--")plt.xlabel("Taxa verdadeira de atraso (%)")plt.ylabel("Poder")plt.show()
NotaInterpretação
O poder é baixo para alternativas muito próximas de 8% e cresce com o tamanho do efeito. A linha de 80% é uma referência de planejamento, não uma garantia de detectar toda diferença relevante.
Visualizando poder sob \(H_0\) e \(H_1\)
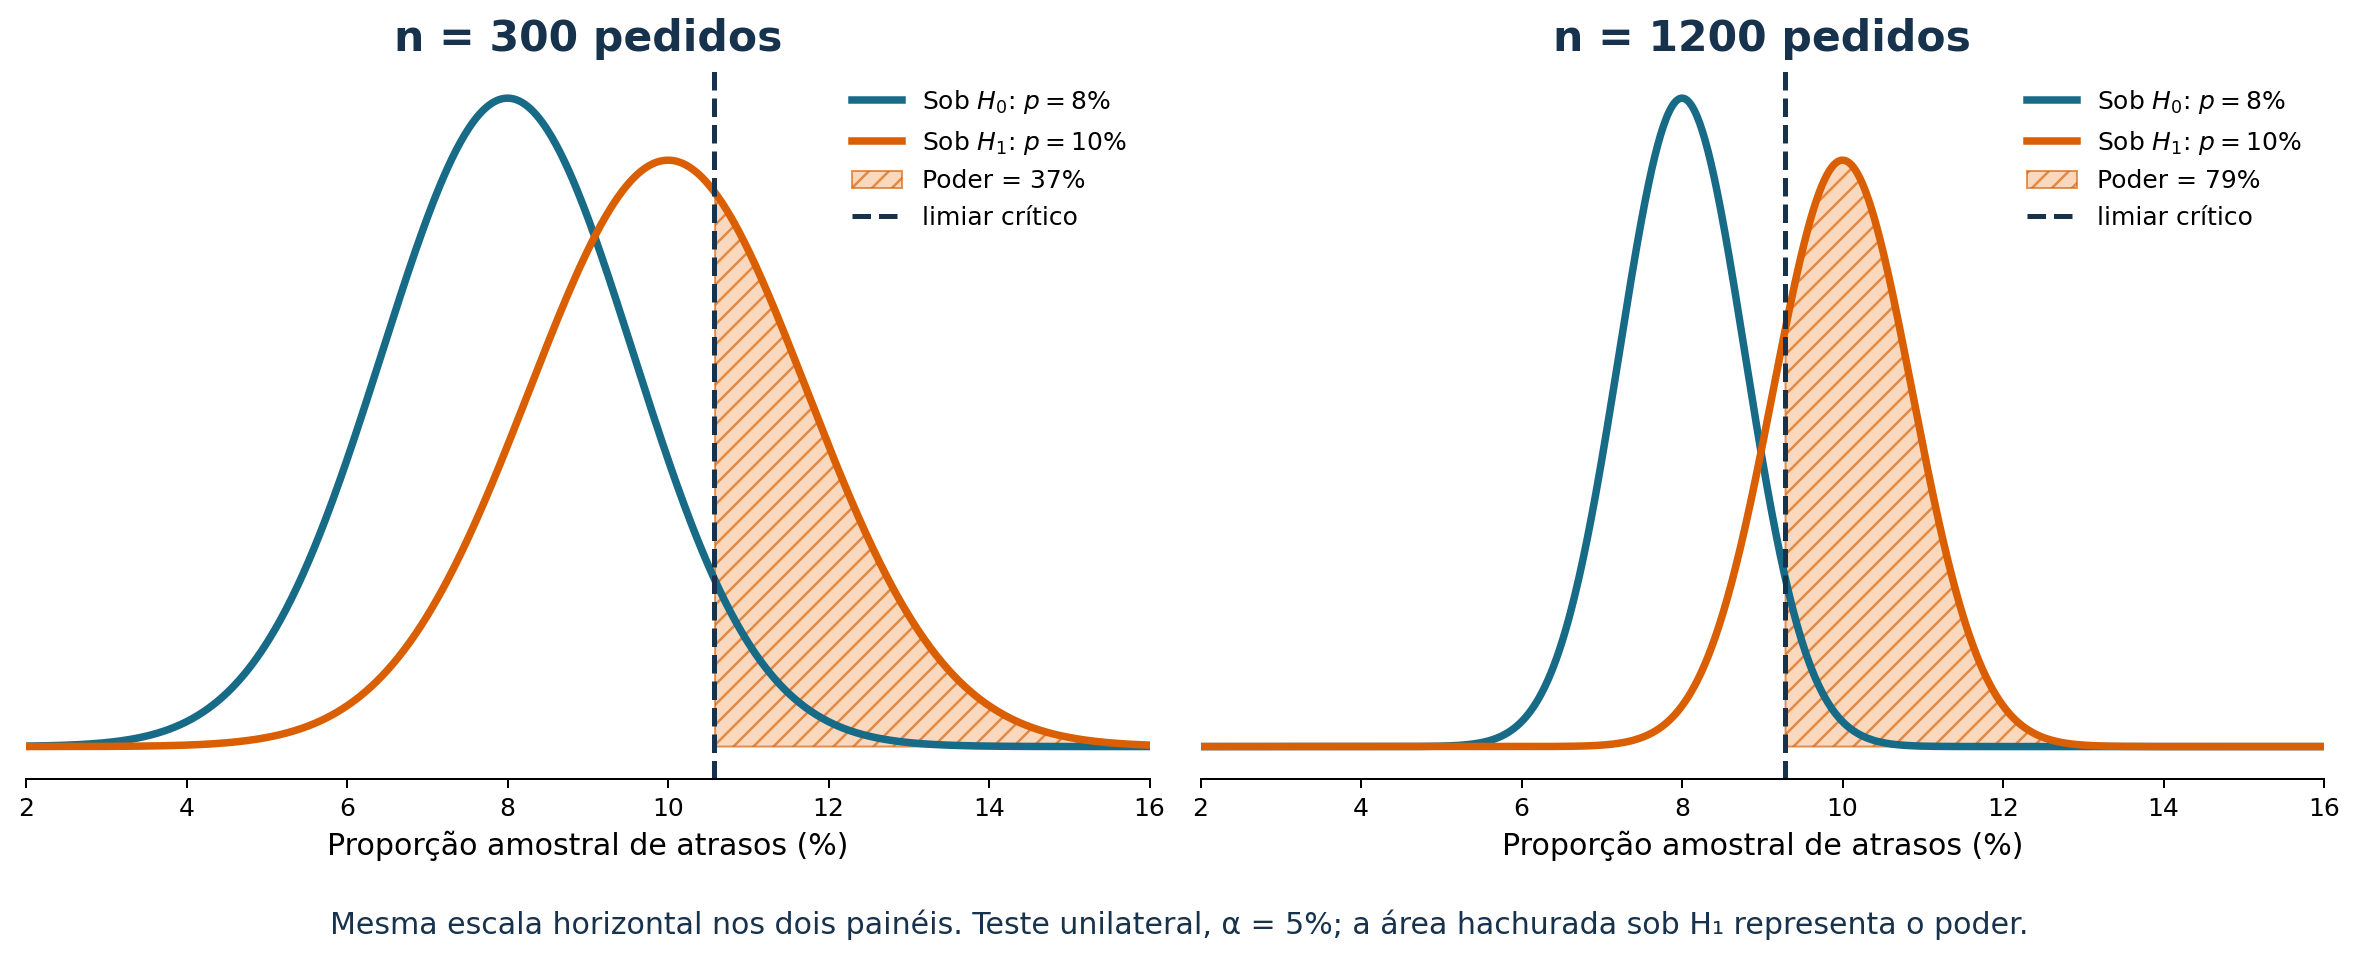
Fixemos um teste unilateral com \(H_0:p=0{,}08\), uma alternativa específica \(p_1=0{,}10\) e \(\alpha=0{,}05\). O limiar crítico aproximado para cada tamanho amostral é
em que \(c_n\) é a menor proporção que leva à rejeição, \(p_0\) é a taxa nula, \(z_{1-\alpha}\) é o quantil da Normal padrão e \(n\) é o tamanho da amostra. Sob a alternativa, o poder aproximado é
\[\pi(p_1;n)=P_{p_1}(\widehat p\geq c_n).\]
\(P_{p_1}\) indica que a probabilidade é calculada quando a taxa verdadeira é \(p_1\); geometricamente, ela corresponde à área da distribuição alternativa à direita do limiar.
Com 300 pedidos, as distribuições sob 8% e 10% se sobrepõem bastante e apenas 37% da distribuição alternativa ultrapassa o limiar. Com 1.200 pedidos, ambas ficam mais estreitas, a sobreposição diminui e o poder sobe para aproximadamente 79%. O efeito verdadeiro não mudou; aumentou apenas a capacidade de distingui-lo da flutuação amostral.
11. Significância e relevância
Calcule também a diferença \(\widehat p-0{,}08\) e traduza-a para atrasos extras por mil pedidos. Uma decisão operacional deve considerar o tamanho do efeito, custos e um intervalo de confiança, não apenas o valor-p.
12. Testes A/B como experimentos aleatorizados
Um teste A/B compara duas versões de uma experiência. A versão A costuma ser o controle; a versão B introduz uma mudança. A atribuição aleatória procura tornar os grupos comparáveis antes da intervenção, de modo que uma diferença posterior possa ser atribuída à mudança, dentro das limitações do desenho.
Um bom teste A/B precisa definir antes da coleta:
a unidade que será randomizada;
as versões de controle e tratamento;
a métrica primária;
o menor efeito relevante;
o tamanho da amostra ou a regra de parada;
a direção e o nível do teste;
exclusões e métricas de proteção.
Exemplo: um alerta preventivo na operação da Olist
Suponha que a operação queira testar um alerta capaz de identificar cedo pedidos com risco de atraso e priorizar seu encaminhamento. Entre pedidos elegíveis, a atribuição seria aleatória:
A — controle: processo logístico atualmente usado;
B — tratamento: processo com o novo alerta preventivo.
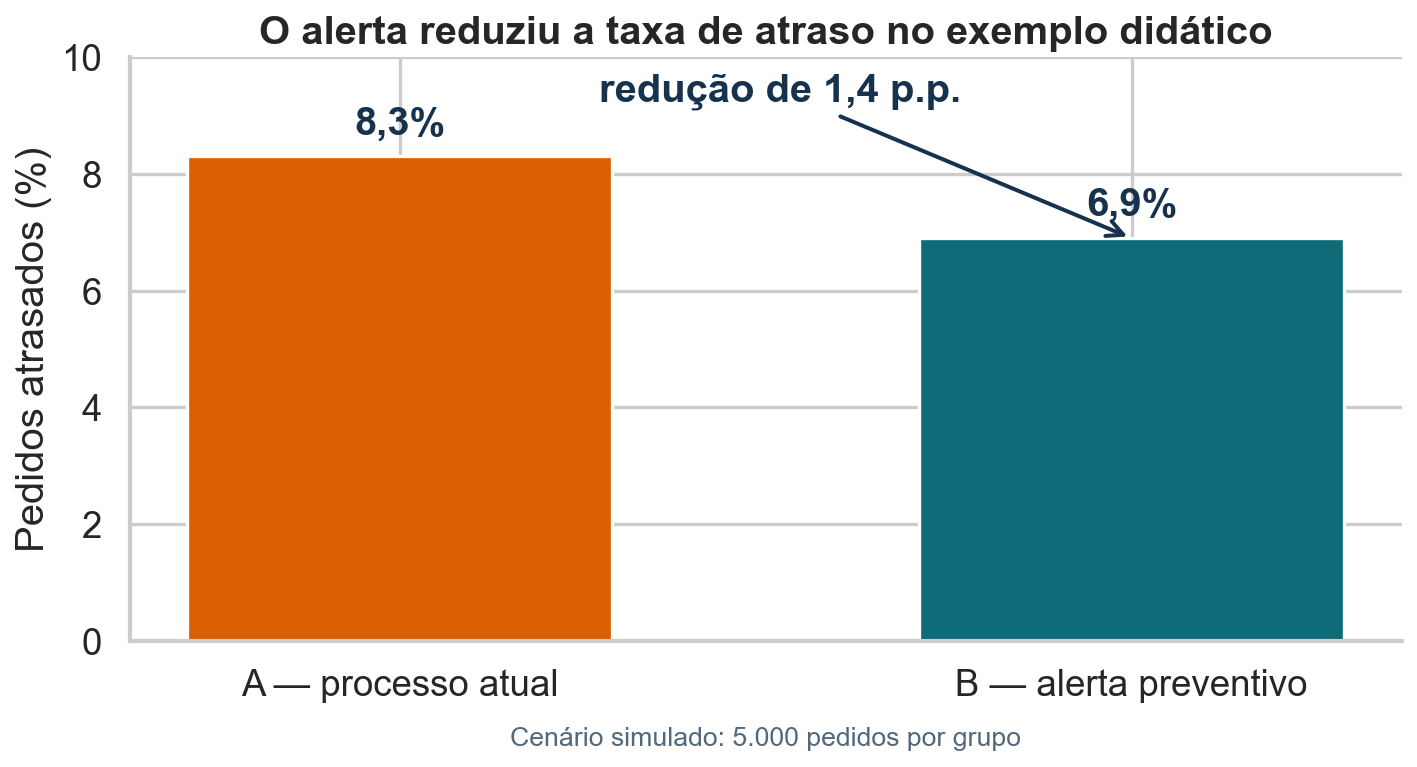
A base Olist original é observacional e não contém essa intervenção. Para aprender o fluxo de um A/B sem trocar o contexto da aula, usaremos um experimento didático simulado, com taxas calibradas pela base real:
A randomização é uma característica do experimento proposto, não da base Olist histórica. Essa distinção impede apresentar como causal uma comparação que não foi realmente observada no conjunto de dados original.
Da pergunta operacional às hipóteses
A métrica primária é a proporção de pedidos entregues depois da data prevista. A pergunta é: o alerta reduz a taxa de atraso? Definimos
\[
\Delta=p_B-p_A,
\]
em que \(p_A\) e \(p_B\) são as probabilidades populacionais de atraso nos dois processos. Como a direção foi definida antes dos dados, o teste unilateral é
em que \(\Phi\) é a função de distribuição acumulada da Normal padrão. Em outras palavras: se o alerta não tivesse efeito, observar uma redução igual ou maior que 1,4 ponto percentual ocorreria em aproximadamente 0,41% de experimentos como este.
NotaInterpretação
A taxa simulada caiu de 8,3% para 6,9%: redução absoluta de 1,4 ponto percentual, com \(z\approx-2{,}64\) e valor-p unilateral próximo de 0,0041. Isso fornece evidência contra \(H_0\) no nível de 5%, mas não decide sozinho se a magnitude compensa o custo do alerta. Em uma escala de 10 mil pedidos, o efeito corresponde a aproximadamente 140 atrasos evitados.
O fluxo completo do A/B
formular a mudança e o mecanismo causal esperado;
escolher unidade de randomização e população-alvo;
definir métrica primária e menor efeito relevante;
planejar tamanho amostral e regra de parada;
randomizar e auditar a alocação;
estimar o efeito com sua incerteza;
testar a hipótese previamente definida;
avaliar significância estatística, relevância prática e efeitos adversos.
A lógica será ampliada nas aulas seguintes: bootstrap para quantificar incerteza, permutação para construir \(H_0\) a partir da randomização e simulação para estudar poder e múltiplas métricas.
13. Exercícios
Repita o teste com amostras de 300, 1.200 e 5.000 pedidos.
Transforme o teste em bilateral e explique a mudança no valor-p.
Compare o erro tipo I para \(\alpha=0{,}01\), 0,05 e 0,10.
Encontre o menor \(n\) que atinge 80% de poder quando \(p=0{,}10\).
Discuta se os pedidos podem ser tratados como independentes quando um mesmo cliente realiza várias compras.
Refaça o A/B do alerta com uma alternativa bilateral e compare o valor-p com o teste unilateral planejado.
Proponha uma métrica de proteção para verificar se a priorização reduz atrasos sem prejudicar pedidos que não receberam o alerta.
Fonte e limitações
Base olistbr/brazilian-ecommerce, Kaggle. Os dados são históricos e anonimizados; o limite de 8% é uma referência didática, não uma meta declarada pela empresa. O notebook não deve ser interpretado como auditoria operacional da Olist.
O exemplo A/B do alerta é uma simulação pedagógica construída no contexto da Olist. Ele não deve ser descrito como um experimento realizado pela empresa nem como uma variável presente na base original.
Guia teórico consolidado
A lógica de um teste
Um teste começa antes dos cálculos: defina o parâmetro de interesse, a hipótese nula \(H_0\), a alternativa \(H_A\), a estatística e a direção. A distribuição nula descreve valores que a estatística poderia assumir se \(H_0\) fosse verdadeira. O valor-p é a probabilidade, calculada sob \(H_0\), de obter resultado tão ou mais extremo que o observado.
O valor-p não é \(P(H_0\mid\text{dados})\), não mede o tamanho do efeito e não é a probabilidade de o resultado ter ocorrido por acaso.
Formalmente, seja \(T=T(X_1,\ldots,X_n)\) uma estatística cuja direção de extremidade foi definida antes da análise. Em um teste unilateral à direita,
\[p(X)=P_{H_0}\{T(X^{rep})\geq T(X^{obs})\},\]
em que \(X^{obs}\) são os dados observados, \(X^{rep}\) representa uma nova amostra gerada pelo modelo nulo e \(P_{H_0}\) indica que a probabilidade é calculada assumindo \(H_0\). No teste bilateral, a região extrema deve incluir desvios relevantes nas duas direções, frequentemente por meio de \(|T|\) quando a distribuição nula é centrada em zero.
Uma região crítica \(\mathcal R_\alpha\) é escolhida para satisfazer \(P_{H_0}(T\in\mathcal R_\alpha)\leq\alpha\). A regra é rejeitar \(H_0\) quando \(T_{obs}\in\mathcal R_\alpha\), de modo que \(\alpha\) limita a probabilidade de rejeição quando a nula é verdadeira.
Decisão e erros
O nível \(\alpha\) controla a probabilidade de erro tipo I sob as condições do teste. Erro tipo II é não rejeitar \(H_0\) quando uma alternativa relevante é verdadeira. Poder é \(1-\beta\): a chance de detectar essa alternativa específica.
Para um valor alternativo \(\theta_1\), \(\beta(\theta_1)=P_{\theta_1}(T\notin\mathcal R_\alpha)\) e \(\pi(\theta_1)=1-\beta(\theta_1)\) é a função poder. Portanto, poder não é um único atributo do teste: ele varia com o efeito verdadeiro \(\theta_1\).
Reduzir \(\alpha\) diminui falsos positivos, mas pode reduzir poder. Poder cresce com tamanho do efeito, tamanho amostral, menor variabilidade e, mantendo o restante, um limiar menos rigoroso.
Significância e importância
“Rejeitar \(H_0\)” não significa provar \(H_A\); “não rejeitar” não prova equivalência. Com amostras grandes, efeitos irrelevantes podem ser significativos. Sempre reporte estimativa, intervalo e consequência substantiva, além do valor-p.
Testes unilaterais só são defensáveis quando a direção foi escolhida antes de observar os dados e efeitos na direção oposta não levariam à mesma ação. Fazer muitos testes aumenta a chance de falsos positivos e exige definir uma família e uma estratégia de correção.
Testes A/B conectam desenho e inferência
Em um teste A/B, a inferência não começa no valor-p. Ela começa na atribuição aleatória das unidades a duas versões. A hipótese nula representa ausência de efeito da mudança sobre a métrica previamente escolhida. O parâmetro de interesse deve ser escrito com direção explícita, como \(\Delta=p_B-p_A\), porque seu sinal determina qual versão é favorecida.
Randomização sustenta a interpretação causal apenas quando a unidade de análise é compatível com a unidade randomizada, não há interferência relevante entre unidades, perdas ou falhas de instrumentação não destroem a comparação e a regra de parada não é alterada depois de observar os resultados. O relatório deve combinar estimativa do efeito, intervalo de confiança, valor-p, relevância prática e métricas de proteção.
Como reduzir falsos positivos quando há muitos testes
Se realizamos vários testes, cresce a probabilidade de encontrar ao menos um resultado significativo apenas por flutuação amostral. Com 20 testes independentes, todos sob hipóteses nulas verdadeiras e cada um com \(\alpha=0{,}05\), essa probabilidade é
\[
P(\text{ao menos um falso positivo})
=1-(1-0{,}05)^{20}\approx 0{,}64.
\]
Três estratégias ajudam em momentos diferentes da pesquisa:
Pré-registro: antes de observar os resultados, registrar as hipóteses, os desfechos, os critérios de exclusão e o plano de análise. Isso distingue análises confirmatórias das explorações feitas depois de olhar os dados e reduz a liberdade para selecionar apenas resultados favoráveis. Pré-registro não altera matematicamente um valor-p.
Correções para múltiplos testes: ajustar os limiares de rejeição ou os valores-p levando em conta a família de testes realizada. Bonferroni e Holm, por exemplo, controlam a probabilidade de ao menos um falso positivo na família. A Aula 15 detalha diferentes critérios e procedimentos.
Validação externa: verificar a conclusão em uma amostra, período, instituição ou população independente daquela usada para descobrir o resultado. Um achado que se repete oferece evidência de generalização; um achado que não se repete pode depender de acaso ou de características particulares da amostra original.
NotaInterpretação
Essas medidas não são sinônimas. A correção atua na regra estatística da família de testes; o pré-registro melhora a transparência do processo; e a validação externa procura evidência independente. Em um estudo bem planejado, as três podem ser usadas em conjunto.
Questões de revisão da Aula 11
O que um valor-p de 0,02 afirma — e o que ele não afirma?
Por que aumentar \(n\) eleva o poder quando \(p_0\), \(p_1\) e \(\alpha\) permanecem fixos?
Quais elementos precisam ser definidos antes de iniciar um teste A/B?
Respostas comentadas
Sob \(H_0\), resultados tão ou mais extremos ocorreriam com probabilidade 2%. Isso não significa que \(P(H_0\mid\text{dados})=0{,}02\) nem mede relevância prática.
O erro padrão diminui, as distribuições sob \(H_0\) e \(H_1\) ficam mais estreitas e sua sobreposição diminui.
No mínimo: unidade de randomização, versões A e B, população-alvo, métrica primária, efeito relevante, tamanho amostral ou regra de parada, hipótese, nível do teste e critérios de exclusão.