O bootstrap aproxima a distribuição amostral usando a própria amostra como uma população empírica. Este capítulo explica por que reamostramos com reposição, como cada réplica é construída e como a distribuição das réplicas pode estimar erro padrão, viés, intervalos de confiança e valores-p. A análise de preços do Airbnb introduz o método; o teste A/B didático da Olist mostra como construir uma distribuição bootstrap sob \(H_0\).
O raciocínio deve ser acompanhado em três níveis. A amostra original produz a estimativa observada. Cada reamostra produz uma réplica bootstrap. O conjunto de muitas réplicas aproxima a variabilidade que teríamos ao repetir a coleta sob condições semelhantes. Não confunda a quantidade de réplicas com o tamanho da amostra: aumentar \(R\) reduz o ruído da simulação, mas não cria novas observações independentes.
Nesta aula, \(R\) denota o número total de réplicas e \(b\) indexa uma réplica particular. Essa escolha preserva \(B(\widehat\theta)\) para o viés do estimador, seguindo a notação adotada nas aulas anteriores.
Começaremos com o intervalo percentil e depois compararemos outros métodos. As fórmulas são acompanhadas de interpretação, vantagens e limitações. Antes de escolher um intervalo, verifique se as observações são representativas, se a unidade de reamostragem respeita a dependência dos dados e se a estatística não está em uma situação muito irregular.
A base
A base Airbnb NYC 2019 descreve anúncios disponíveis na cidade de Nova York. A unidade de observação é um anúncio. Usaremos distrito, tipo de acomodação, preço por noite e identificador do anfitrião.
import kagglehubimport numpy as npimport pandas as pdimport seaborn as snsimport matplotlib.pyplot as pltpath = kagglehub.dataset_download("dgomonov/new-york-city-airbnb-open-data")airbnb = pd.read_csv(f"{path}/AB_NYC_2019.csv")airbnb.shape
Warning: Looks like you're using an outdated `kagglehub` version (installed: 0.3.13), please consider upgrading to the latest version (1.0.2).
(48895, 16)
NotaInterpretação
Antes de interpretar resultados, confirme o que cada linha representa, o período coberto e as colunas realmente disponíveis. Essa definição determina quais agregações e comparações são válidas.
Os resumos devem ser lidos em conjunto: preço e noites mínimas são assimétricos, os bairros têm tamanhos diferentes e valores ausentes podem alterar a população efetivamente analisada. Esses fatos orientam o filtro, a escolha da mediana e a forma de reamostrar.
Limpeza e população-alvo
Removemos preços zero e o 1% superior. A análise compara acomodações inteiras em Manhattan e Brooklyn. Os filtros fazem parte da definição da população-alvo.
O bootstrap descreve incerteza condicionada à amostra observada. Sua validade depende de representatividade, independência adequada e escolha correta da unidade de reamostragem.
Estimativa observada
prices = { borough: group["price"].to_numpy()for borough, group in sample.groupby("neighbourhood_group")}theta_hat = ( np.median(prices["Manhattan"])- np.median(prices["Brooklyn"]))theta_hat
40.0
NotaInterpretação
A diferença observada é o centro da análise, mas não informa sozinha sua precisão. O bootstrap aproxima essa incerteza reamostrando unidades comparáveis da amostra.
Por que o intervalo analítico para medianas é mais difícil?
Para uma média, o TCL fornece uma aproximação Normal e o erro padrão pode ser estimado diretamente pela variância amostral. Para uma mediana, a precisão também depende de quanto a distribuição se concentra perto de seu centro. Se há pouca densidade nessa região, pequenas mudanças na amostra podem deslocar a mediana de maneira considerável.
Sob condições de regularidade, a mediana amostral \(\widetilde X\) satisfaz
em que \(n\) é o tamanho da amostra, \(m\) é a mediana populacional e \(f(m)\) é o valor da função densidade de probabilidade na mediana. A fórmula mostra que uma densidade maior perto de \(m\) produz uma mediana mais estável.
Para duas amostras independentes, a variância da diferença é aproximadamente a soma das variâncias:
Na prática, \(m_g\) e \(f_g(m_g)\) são desconhecidos. Substituímos a mediana populacional por \(\widetilde X_g\) e estimamos a densidade perto dela, obtendo
Aqui, \(g\in\{1,2\}\) identifica o grupo; \(n_g\) é seu tamanho amostral; \(\widetilde X_g\) é sua mediana amostral; e \(\widehat f_g(\widetilde X_g)\) é uma estimativa da densidade na vizinhança da mediana. Um intervalo aproximado de 95% seria
Essa aproximação pressupõe amostras independentes e aproximadamente i.i.d., distribuições contínuas, medianas únicas e densidades positivas e regulares perto das medianas. Estimar \(f_g\) também exige uma escolha, como o kernel e a largura de banda de uma KDE. Em amostras pequenas ou distribuições irregulares, o resultado pode ser instável.
NotaInterpretação
O bootstrap substitui essa derivação analítica por reamostragem e evita estimar explicitamente a densidade nas medianas. Isso simplifica o cálculo, mas não torna o método livre de hipóteses: a amostra ainda precisa representar a população e o esquema de reamostragem deve preservar a estrutura de dependência dos dados.
Exemplo visual: densidade e precisão da mediana
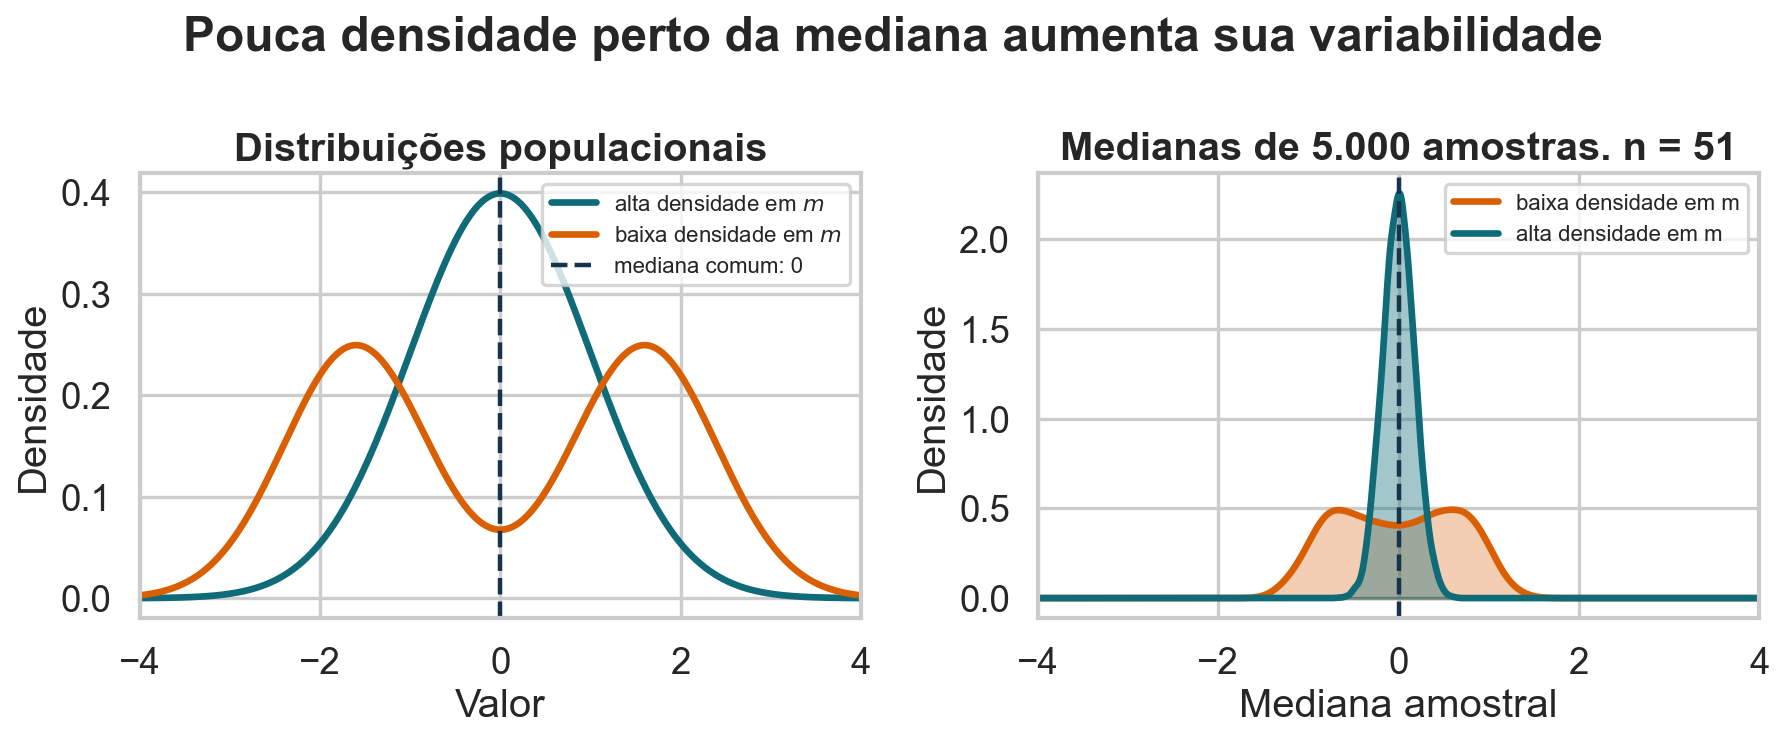
As duas populações simuladas abaixo são simétricas e têm mediana populacional \(m=0\). A primeira concentra muita probabilidade perto de zero. A segunda é uma mistura bimodal e tem pouca densidade perto de zero. Em cada população, retiramos 5.000 amostras independentes de tamanho \(n=51\) e calculamos suas medianas.
def normal_pdf(x, mean, sd):return np.exp(-0.5* ((x - mean) / sd) **2) / (sd * np.sqrt(2* np.pi))x_grid = np.linspace(-4, 4, 800)pdf_concentrada = normal_pdf(x_grid, 0, 1)pdf_bimodal = (0.5* normal_pdf(x_grid, -1.6, 0.8)+0.5* normal_pdf(x_grid, 1.6, 0.8))median_rng = np.random.default_rng(1205)n_rep_median, n_median =5000, 51sample_concentrada = median_rng.normal(0, 1, (n_rep_median, n_median))componentes = median_rng.integers(0, 2, (n_rep_median, n_median))medias_bimodais = np.where(componentes ==0, -1.6, 1.6)sample_bimodal = median_rng.normal(medias_bimodais, 0.8)medianas_concentrada = np.median(sample_concentrada, axis=1)medianas_bimodal = np.median(sample_bimodal, axis=1)fig, axes = plt.subplots(1, 2, figsize=(11.5, 4.8), sharex=True)axes[0].plot(x_grid, pdf_concentrada, label="alta densidade em m")axes[0].plot(x_grid, pdf_bimodal, label="baixa densidade em m")axes[0].axvline(0, color="black", linestyle="--", label="mediana comum: 0")axes[0].set_title("Distribuições populacionais")axes[0].set_xlabel("Valor")axes[0].set_ylabel("Densidade")def kde_on_grid(values, grid): bandwidth =1.06* values.std(ddof=1) *len(values) ** (-1/5) z = (grid[:, None] - values[None, :]) / bandwidthreturn np.exp(-0.5* z**2).mean(axis=1) / (bandwidth * np.sqrt(2*np.pi))kde_concentrada = kde_on_grid(medianas_concentrada, x_grid)kde_bimodal = kde_on_grid(medianas_bimodal, x_grid)axes[1].fill_between(x_grid, kde_bimodal, alpha=0.30)axes[1].plot(x_grid, kde_bimodal, label="baixa densidade em m")axes[1].fill_between(x_grid, kde_concentrada, alpha=0.38)axes[1].plot(x_grid, kde_concentrada, label="alta densidade em m")axes[1].axvline(0, color="black", linestyle="--")axes[1].set_title("Medianas de 5.000 amostras, n = 51")axes[1].set_xlabel("Mediana amostral")axes[1].set_ylabel("Densidade")for ax in axes: ax.set_xlim(-4, 4) ax.legend()fig.suptitle("Pouca densidade perto da mediana aumenta sua variabilidade")plt.show()
NotaInterpretação
Na população concentrada, muitas observações ficam próximas de zero e a mediana muda pouco entre amostras. Na população bimodal, há poucas observações perto de zero; trocar apenas algumas unidades centrais pode deslocar a mediana de um lado para o outro. Isso explica por que \(f(m)\) aparece no denominador da variância: quanto menor a densidade na mediana, maior a incerteza da mediana amostral.
Réplicas bootstrap
Formalmente, \(F\) representa a distribuição populacional desconhecida, cuja função de distribuição acumulada é \(F(x)=P(X\leq x)\). O bootstrap substitui essa CDF pela CDF empírica \(\widehat F_n\), que atribui probabilidade \(1/n\) a cada observação. Cada amostra bootstrap é sorteada da distribuição empírica associada a \(\widehat F_n\), com reposição, e tem o mesmo tamanho da amostra original.
A letra \(T\) representa a regra estatística que aplicamos aos dados. Ela pode ser a média, a mediana ou qualquer outra estatística adequada ao problema. Nesta aula,
Mantemos \(T\) fixa em todas as réplicas. O que muda de uma réplica para outra é a amostra reamostrada. Como existem dois grupos, sorteamos anúncios de Manhattan e Brooklyn separadamente e depois calculamos novamente a diferença de medianas.
Quantas observações distintas aparecem em uma réplica?
Uma réplica tem \(n\) posições, mas algumas observações se repetem. Para entender quantas observações distintas esperamos encontrar, considere primeiro uma observação específica, por exemplo \(X_i\). Em cada sorteio, a probabilidade de não selecionar \(X_i\) é \(1-1/n\). Como fazemos \(n\) sorteios independentes com reposição,
\[
P(X_i\text{ não aparecer})=\left(1-\frac{1}{n}\right)^n.
\]
Portanto, a probabilidade de essa observação aparecer pelo menos uma vez é
Defina \(I_i=1\) quando \(X_i\) aparece na réplica e \(I_i=0\) caso contrário. O número de observações distintas é \(D_n=\sum_{i=1}^n I_i\). Como \(I_i\) é uma variável indicadora, sua esperança é a probabilidade de valer 1:
Essa etapa não exige que os indicadores \(I_i\) sejam independentes. A linearidade da esperança vale mesmo que a presença de uma observação afete a chance de presença das demais.
A notação \(\mathbb{E}(\cdot)\) representa a esperança matemática. Neste contexto, \(\mathbb{E}(D_n)\) é a média do número de observações distintas que encontraríamos se gerássemos muitas réplicas bootstrap de tamanho \(n\). Ela não descreve necessariamente uma réplica específica.
Resta demonstrar o limite. Defina
\[
a_n=\left(1-\frac{1}{n}\right)^n.
\]
Aplicando o logaritmo e fazendo \(u=1/n\), obtemos
Quando \(u\to0^+\), tanto \(\log(1-u)\) quanto \(u\) convergem para zero. Temos, portanto, uma indeterminação do tipo \(0/0\). Pela regra de L’Hôpital, derivamos o numerador e o denominador em relação a \(u\):
Assim, a proporção esperada de observações distintas converge para 63,2%, enquanto o número esperado satisfaz \(\mathbb{E}(D_n)\approx0{,}632n\) quando \(n\) é grande. Não se trata de uma porcentagem exata para qualquer tamanho de amostra.
NotaExemplo numérico com n = 8
Partindo de \((A,B,C,D,E,F,G,H)\), uma réplica possível é \((A,C,C,D,F,F,F,H)\). Ela tem tamanho 8, mas contém apenas 5 observações distintas: \(A\), \(C\), \(D\), \(F\) e \(H\). Considerando todas as réplicas possíveis,
Portanto, para \(n=8\), esperamos em média 5,25 observações distintas, ou 65,6% da amostra original. Uma réplica específica pode conter mais ou menos do que isso.
NotaInterpretação
As repetições não representam um defeito do método. Elas fazem as réplicas diferirem da amostra original e permitem que a estatística varie. Sem reposição, cada réplica seria apenas uma permutação dos mesmos \(n\) valores.
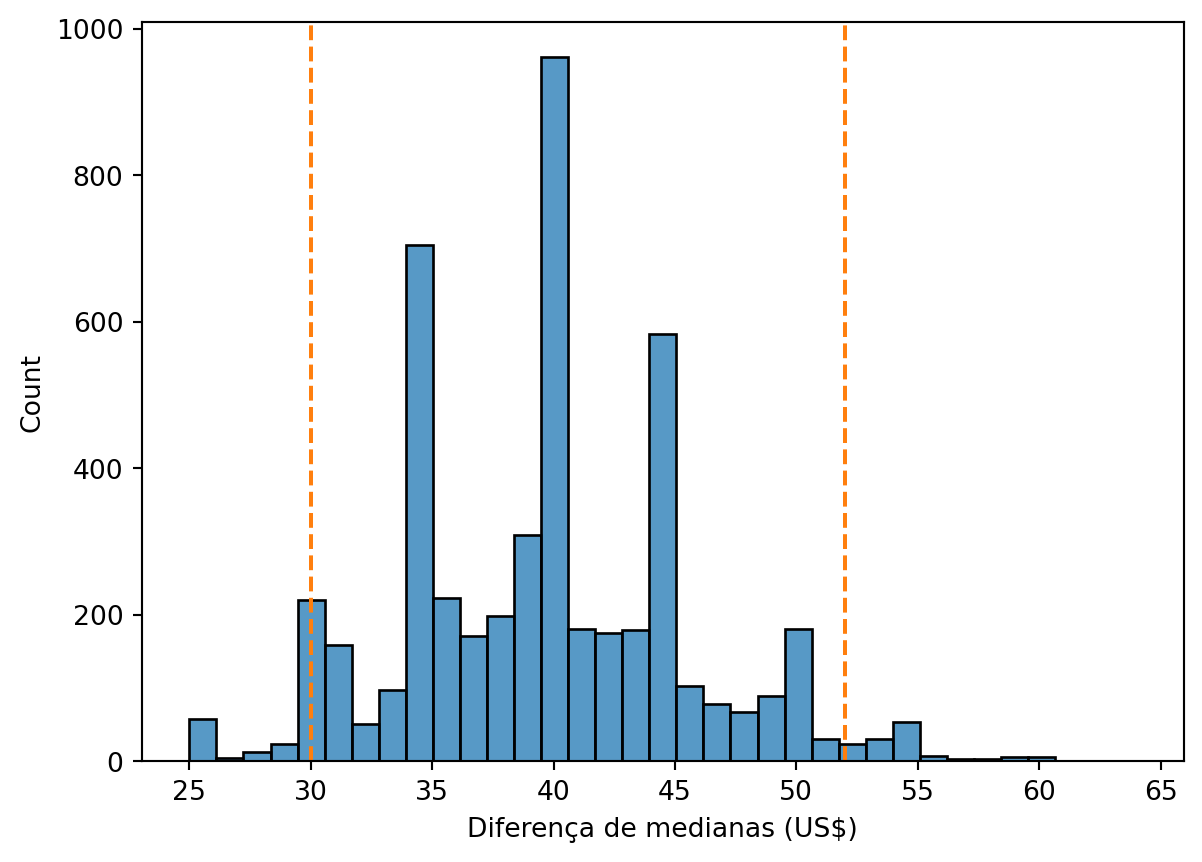
Cada réplica refaz a comparação como se a distribuição empírica fosse a população. A nuvem de diferenças não representa novos dados reais; ela aproxima a variabilidade da estatística provocada pelo processo amostral.
O erro padrão descreve quanto a estatística varia entre réplicas. O intervalo percentil usa diretamente os quantis 2,5% e 97,5%. Sua interpretação é sobre o procedimento repetido: em condições adequadas, aproximadamente 95% dos intervalos construídos cobririam o parâmetro-alvo.
sns.histplot(replicas, bins=35)plt.axvline(ci_percentil[0], color="tab:orange", linestyle="--")plt.axvline(ci_percentil[1], color="tab:orange", linestyle="--")plt.xlabel("Diferença de medianas (US$)")plt.show()
NotaInterpretação
O centro da distribuição bootstrap deve ficar próximo da diferença observada. Sua dispersão fornece o erro padrão, e os quantis delimitam uma faixa de valores compatíveis com a incerteza amostral sob as condições assumidas.
Diferença de médias: bootstrap versus TCL
Para comparar os métodos sobre a mesma estatística, agora usamos a diferença de médias
\[\widehat\Delta=\bar X_M-\bar X_B,\]
em que \(\bar X_M\) e \(\bar X_B\) são os preços médios observados em Manhattan e Brooklyn. Sob independência entre as unidades e amostras suficientemente grandes, o TCL fornece o erro padrão estimado
onde \(s_g^2\) e \(n_g\) são a variância amostral e o tamanho do grupo \(g\). O intervalo aproximado de 95% é \(\widehat\Delta\pm1{,}96\widehat{SE}_{TCL}\).
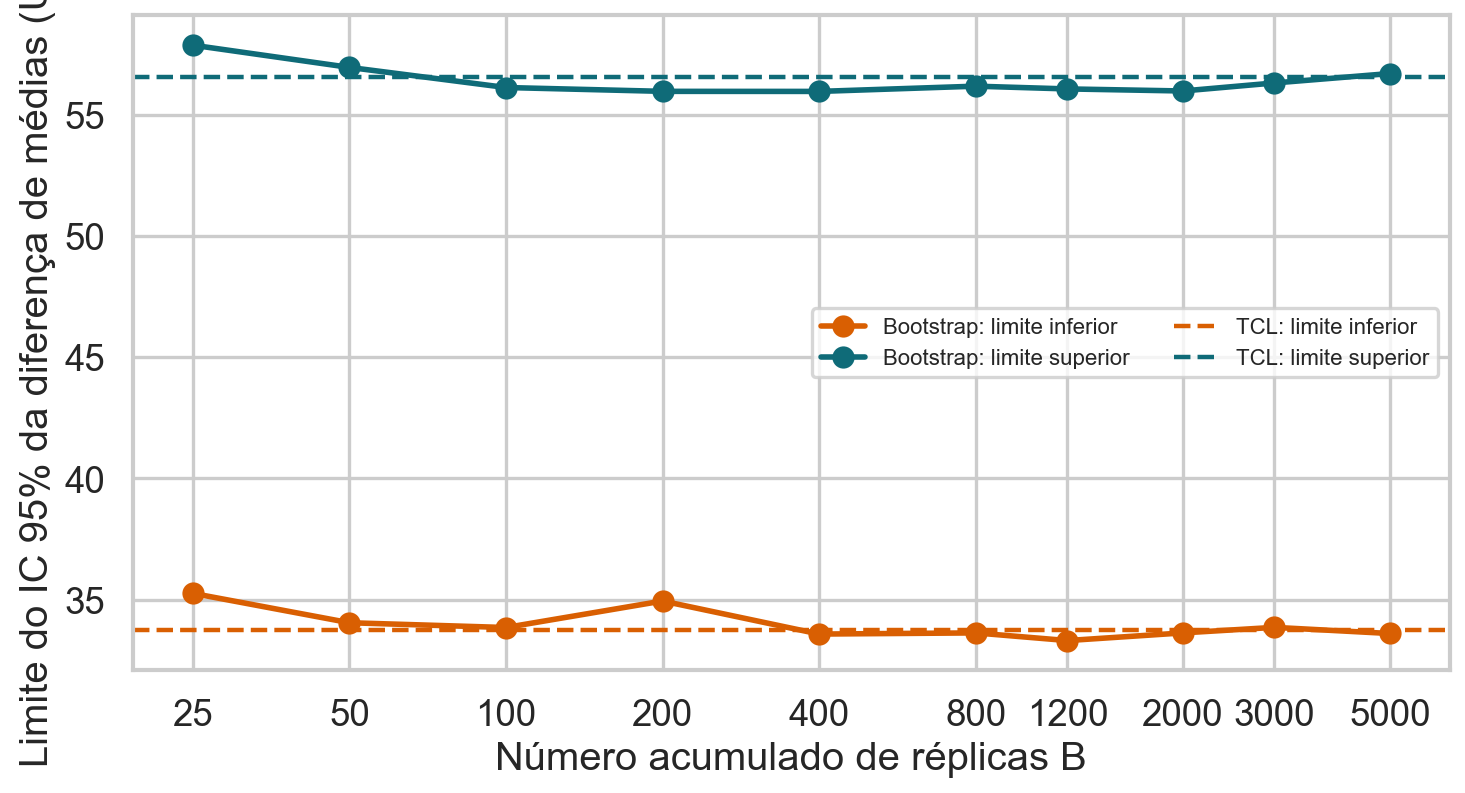
No bootstrap, cada réplica calcula \(\widehat\Delta_b^*=\bar X_{M,b}^*-\bar X_{B,b}^*\) e o intervalo percentil usa os quantis 2,5% e 97,5% das primeiras \(R\) réplicas.
Com poucas réplicas, os quantis bootstrap oscilam por erro de Monte Carlo. À medida que \(R\) cresce, os limites se estabilizam próximos aos limites do TCL. Essa proximidade decorre da aproximação Normal para a diferença de médias nesta amostra; aumentar \(R\) apenas estabiliza o cálculo bootstrap e não garante igualdade entre os métodos.
Correção pontual do viés bootstrap
A diferença entre a média das réplicas e a estimativa original mede o deslocamento que o bootstrap consegue reproduzir:
Se esse valor for relevante diante do erro padrão bootstrap e permanecer estável quando \(R\) aumenta, uma correção pontual usual desloca a estimativa na direção oposta:
O viés estimado é muito pequeno diante do erro padrão bootstrap de aproximadamente US$ 5,5. A correção quase não altera a conclusão. Em geral, a correção não deve ser automática: a estimativa do viés também contém ruído e sua subtração pode aumentar o MSE. Além disso, o bootstrap não corrige viés de seleção ou de mensuração que a amostra não revela.
Exercício resolvido: diagnóstico e correção do viés
Considere \(R=2.000\) réplicas, uma estimativa original \(\widehat\theta=50\), média bootstrap \(\overline{\theta^*}=52\) e erro padrão bootstrap \(\widehat{SE}_{boot}=1\).
O viés bootstrap estimado é
\[
\widehat B_{boot}(\widehat\theta)
=52-50=2.
\]
As réplicas ficam, em média, duas unidades acima da estimativa original. A correção desloca a estimativa na direção oposta:
\[
\widehat\theta_{corr}=50-2=48.
\]
NotaInterpretação
O deslocamento equivale a dois erros padrão bootstrap. Ele não deve ser ignorado, mas a decisão de corrigir exige verificar se \(\widehat B_{boot}\) permanece estável quando \(R\) aumenta e se a correção melhora o desempenho em simulação. O erro padrão mede a dispersão das réplicas; ele não entra diretamente na fórmula da correção.
Bootstrap por anfitrião
Se anúncios do mesmo anfitrião são dependentes, a unidade de reamostragem deve ser o anfitrião. Em cada réplica, sorteamos host_id e carregamos todos os seus anúncios.
def cluster_sample(group, rng): hosts = group["host_id"].unique() chosen = rng.choice(hosts, len(hosts), replace=True)return pd.concat([ group[group["host_id"].eq(host)] for host in chosen ], ignore_index=True)
NotaInterpretação
Sortear anúncios individualmente trataria unidades do mesmo anfitrião como independentes. O bootstrap por conglomerados preserva essa dependência interna e faz a incerteza refletir melhor a unidade que efetivamente foi amostrada.
Quando o bootstrap é válido?
O bootstrap comum funciona melhor quando a amostra representa a população, as observações são aproximadamente i.i.d. e a estatística muda de maneira regular quando a distribuição é perturbada. Ele não corrige viés de seleção, não cria eventos que não apareceram na amostra e pode falhar para máximos, caudas raras, amostras pequenas ou dados dependentes.
Antes de reamostrar, verifique:
qual é a população-alvo;
qual é a unidade independente;
se o esquema de reamostragem imita a coleta;
se os limites são estáveis quando \(R\) aumenta;
se conclusões mudam sob métodos de intervalo alternativos.
Erros comuns
confundir \(R\), número de réplicas, com \(n\), tamanho da amostra;
sortear sem reposição;
interpretar o intervalo como probabilidade posterior do parâmetro;
reamostrar linhas quando a independência ocorre por anfitrião, escola ou dia;
acreditar que milhares de réplicas compensam poucos dados ou coleta enviesada.
Perguntas
Por que o bootstrap comum sorteia com reposição?
O que muda quando aumentamos \(R\)? E quando aumentamos \(n\)?
Por que reamostrar anúncios pode subestimar a incerteza?
Em quais situações o bootstrap percentil seria inadequado?
Guia teórico consolidado
O princípio do bootstrap
\(F(x)=P(X\leq x)\) é a CDF da população desconhecida. Sua versão empírica é
em que \(X_i\) é a observação \(i\), \(x\) é um ponto da escala e \(\mathbb 1(\cdot)\) é a função indicadora. Portanto, \(\widehat F_n(x)\) é a proporção amostral de valores menores ou iguais a \(x\). Essa CDF empírica corresponde a uma distribuição discreta que coloca massa \(1/n\) em cada observação. O bootstrap trata essa distribuição como uma aproximação da população e gera amostras de tamanho \(n\) com reposição. Para cada amostra calculamos
\(T\) é a função estatística escolhida; \(X_{ib}^*\) é a observação \(i\) da réplica \(b\); \(R\) é o número de réplicas; e o asterisco identifica quantidades geradas condicionalmente à amostra original. Se \(\theta=T(F)\) é o parâmetro e \(\widehat\theta=T(\widehat F_n)\) é a estimativa observada, o bootstrap usa a distribuição de \(\widehat\theta^* - \widehat\theta\) para aproximar a distribuição de \(\widehat\theta-\theta\).
Para qualquer variável aleatória genérica \(Z\), \(\mathcal L(Z)\) denota sua distribuição de probabilidade. Na expressão acima, o operador \(\mathcal L\) é aplicado a duas variáveis aleatórias específicas: o erro bootstrap padronizado \(\sqrt n(\widehat\theta^*-\widehat\theta)\) e o erro amostral padronizado \(\sqrt n(\widehat\theta-\theta)\). A barra vertical indica condicionamento nos dados observados e \(\Rightarrow\) significa convergência em distribuição.
A distribuição das réplicas aproxima, condicionalmente à amostra observada, a distribuição amostral do estimador. Seu desvio-padrão estima o erro padrão; quantis podem formar um intervalo percentil.
Para nível \(1-\alpha\), o intervalo percentil é \([q_{\alpha/2},q_{1-\alpha/2}]\), em que \(q_\gamma\) é o quantil de ordem \(\gamma\) das réplicas. Para 95%, \(\alpha=0{,}05\) e usamos os quantis 2,5% e 97,5%.
em que \(\mathbb{E}_F\) é a esperança sob repetidas amostras da população \(F\), \(\theta=T(F)\) é o parâmetro e \(\widehat\theta\) é o estimador. Não podemos calcular essa quantidade diretamente com uma única amostra porque \(F\) e \(\theta\) são desconhecidos.
No mundo bootstrap, substituímos \(F\) por \(\widehat F_n\) e estimamos
onde \(\mathbb{E}_*\) é a esperança sobre reamostragens condicionadas nos dados observados e \(\overline{\theta^*}=R^{-1}\sum_{b=1}^R\widehat\theta_b^*\) é a média das réplicas. Uma correção pontual simples seria
Essa correção não deve ser aplicada automaticamente. A estimativa do viés também tem erro de Monte Carlo e erro amostral; em estimadores irregulares ou amostras pequenas, subtrair o viés estimado pode aumentar o MSE. Além disso, esse cálculo trata apenas do viés que a distribuição empírica consegue reproduzir.
É essencial distinguir:
viés do estimador: deslocamento médio provocado pela regra estatística sob amostras repetidas;
viés bootstrap estimado: aproximação desse deslocamento condicionada à amostra observada;
viés de seleção ou mensuração: diferença causada por uma amostra não representativa ou dados medidos incorretamente, que o bootstrap comum geralmente replica em vez de corrigir.
Exemplo numérico: corrigindo o estimador do máximo
Considere a amostra observada
\[x=(2,4)\]
e suponha que queremos estimar o maior valor da população com
\[\widehat\theta=\max(x_1,x_2)=4.\]
A distribuição empírica coloca probabilidade \(1/2\) em 2 e \(1/2\) em 4. Ao sortear duas observações com reposição, existem quatro amostras bootstrap ordenadas igualmente prováveis:
amostra bootstrap \(x^*\)
\(\widehat\theta^*=\max(x^*)\)
\((2,2)\)
2
\((2,4)\)
4
\((4,2)\)
4
\((4,4)\)
4
Como todas têm probabilidade \(1/4\), a esperança bootstrap do estimador é
A correção desloca a estimativa na direção oposta ao viés estimado. Entretanto, o máximo é um estimador pouco regular e a amostra tem apenas duas observações: obter 4,5 não garante melhora em MSE nem revela valores da população que nunca apareceram na amostra. O exemplo serve para tornar a fórmula transparente, não para recomendar correção automática.
Com a semente usada neste material, o resultado é:
quantidade
valor (US$)
estimativa observada
40,00
viés bootstrap estimado
−0,26
estimativa corrigida
40,26
NotaInterpretação
Um centro bootstrap próximo de \(\widehat\theta\) sugere pouco viés estimável para essa estatística e essa distribuição empírica. Isso não demonstra que a amostra Airbnb represente todos os anúncios, nem corrige dependência entre anúncios do mesmo anfitrião.
A correção pontual não garante a cobertura
Corrigir \(\widehat\theta\) trata o deslocamento da estimativa pontual, mas isso não garante que um intervalo tenha a cobertura nominal. O intervalo também precisa posicionar corretamente suas duas caudas. O método percentil usa diretamente a distribuição das réplicas e funciona melhor quando ela representa adequadamente tanto a posição quanto a forma da distribuição amostral do estimador. Dois problemas ajudam a entender por que outros intervalos foram propostos.
O primeiro é o deslocamento. Se \(\mathbb E_*(\widehat\theta^*)-\widehat\theta\neq0\), o centro das réplicas não coincide com a estimativa observada. Esse deslocamento médio é a estimativa bootstrap do viés. Os quantis percentis também carregam o deslocamento e podem precisar ser reposicionados.
O segundo é a variabilidade não constante. A sensibilidade da estatística às observações pode mudar em diferentes regiões da distribuição. Como consequência, uma cauda da distribuição do estimador pode se alongar mais do que a outra. Um único erro-padrão ou um ajuste simétrico não representa igualmente essas duas direções. O jackknife usado no BCa estima essa mudança por meio do coeficiente de aceleração \(a\).
Quando esses efeitos são pequenos, percentil, básico, Normal e BCa costumam produzir limites semelhantes. Diferenças relevantes entre eles indicam que deslocamento, assimetria, tamanho amostral ou irregularidade do estimador merecem atenção.
Resumo das técnicas de intervalo
Considere \(R\) réplicas \(\widehat\theta_1^*,\ldots,\widehat\theta_R^*\). Denote por \(q_\gamma^*\) o quantil de ordem \(\gamma\) dessas réplicas, por \(\widehat\theta\) a estimativa observada e por \(z_\gamma=\Phi^{-1}(\gamma)\) o quantil de ordem \(\gamma\) da Normal padrão. Os métodos abaixo usam a mesma reamostragem, mas transformam a distribuição bootstrap de formas diferentes.
Método
Informação usada
Cálculo
O que faz
Percentil
quantis de \(\widehat\theta_b^*\)
\([q_{\alpha/2}^*,q_{1-\alpha/2}^*]\)
mantém a assimetria vista nas réplicas, sem correção explícita de deslocamento
Ele usa diretamente os quantis da distribuição de \(\widehat\theta^*\).
Vantagens: é simples, respeita transformações monótonas e pode produzir limites assimétricos quando as réplicas são assimétricas. Sua interpretação computacional é direta.
Desvantagens: não corrige explicitamente o viés de \(\widehat\theta\) e pode ter cobertura ruim quando a distribuição bootstrap está deslocada, a amostra é pequena ou o estimador é pouco regular.
Intervalo básico
O intervalo básico reflete os quantis bootstrap em torno da estimativa observada:
A motivação é aproximar a distribuição do erro \(\widehat\theta-\theta\) pela distribuição de \(\widehat\theta^*-\widehat\theta\) e inverter os limites para isolar \(\theta\).
Mais explicitamente, os quantis do erro bootstrap são \(q_\gamma^*-\widehat\theta\). Portanto,
Por exemplo, se \(\widehat\theta=10\) e os quantis bootstrap são \([8,13]\), o intervalo básico é \([20-13,20-8]=[7,12]\). A distribuição bootstrap se estende 3 unidades acima e 2 abaixo da estimativa. O intervalo básico reflete essas distâncias, ficando 3 unidades abaixo e 2 acima de \(\widehat\theta\).
NotaRelação com o viés bootstrap
O deslocamento médio das réplicas, \(\widehat B_{boot}(\widehat\theta)=\overline{\theta^*}-\widehat\theta\), é a estimativa bootstrap do viés. O intervalo básico, porém, usa os dois quantis da distribuição do erro, e não apenas esse deslocamento médio. Quando a distribuição bootstrap sofre essencialmente uma translação, a reflexão também corrige o deslocamento associado ao viés; com assimetria, cada cauda pode exigir uma distância diferente.
Vantagens: faz uma correção simples de deslocamento e está diretamente ligado à distribuição bootstrap do erro do estimador.
Desvantagens: não é invariante a transformações monótonas. Um intervalo calculado para \(\log(\theta)\) e depois transformado de volta pode diferir daquele calculado diretamente para \(\theta\). Também não corrige adequadamente assimetria complexa.
onde \(\overline{\theta^*}=R^{-1}\sum_b\widehat\theta_b^*\) é a média das réplicas.
Vantagens: é familiar, fácil de comunicar e costuma funcionar bem quando a distribuição do estimador é aproximadamente Normal, simétrica e com viés pequeno. Para médias em amostras grandes, aproxima-se naturalmente do intervalo derivado pelo TCL.
Desvantagens: força simetria ao redor de \(\widehat\theta\), mesmo quando a distribuição bootstrap é assimétrica. Pode gerar limites impossíveis para parâmetros restritos, como probabilidades próximas de zero ou um.
Intervalo BCa
BCa significa bias-corrected and accelerated, ou corrigido por viés e aceleração. Ele continua usando quantis bootstrap, mas substitui \(\alpha/2\) e \(1-\alpha/2\) por probabilidades ajustadas:
Na fórmula, \(\Phi\) é a CDF da Normal padrão; \(z_0\) é a correção de viés, estimada pela posição de \(\widehat\theta\) entre as réplicas; e \(a\) é a aceleração, que mede como o erro padrão muda com o parâmetro. Uma estimativa usual de \(z_0\) é
onde \(\widehat\theta_{(-i)}\) é a estimativa sem a observação \(i\) e \(\overline\theta_{(-\cdot)}=n^{-1}\sum_i\widehat\theta_{(-i)}\) é a média das estimativas jackknife.
O cálculo pode ser lido em três etapas. Primeiro, \(p_0=R^{-1}\#\{\widehat\theta_b^*<\widehat\theta\}\) localiza a estimativa observada na distribuição bootstrap e \(z_0=\Phi^{-1}(p_0)\) traduz essa posição para a escala Normal. Segundo, o jackknife calcula \(a\) para detectar mudanças na variabilidade quando as observações mudam. Por fim, \(z_0\) e \(a\) transformam os níveis nominais \(\alpha/2\) e \(1-\alpha/2\) nos níveis ajustados \(\alpha_1^{BCa}\) e \(\alpha_2^{BCa}\).
No exemplo da diferença de medianas, encontramos \(z_0=-0{,}159\) e \(a=0\). Assim, os níveis nominais 2,5% e 97,5% tornam-se aproximadamente 1,13% e 94,96%. Os quantis correspondentes das réplicas produzem \(IC_{BCa}\approx[28,50]\) dólares, em vez de simplesmente selecionar os quantis percentis \([30,51]\).
Exercício resolvido: um BCa simplificado
Em um bootstrap com \(R=1.000\) réplicas, 600 estimativas ficaram abaixo de \(\widehat\theta\). Considere \(a=0\) e um intervalo de 95%. Calcule \(p_0\), \(z_0\), os níveis ajustados e o intervalo, sabendo que \(q_{0{,}073}^*=18{,}4\) e \(q_{0{,}993}^*=27{,}9\).
O valor \(z_0>0\) indica que \(\widehat\theta\) está acima do centro das réplicas. O BCa desloca os dois níveis para cima, substituindo 2,5% e 97,5% por 7,3% e 99,3%. O exercício usa \(a=0\) apenas para isolar o efeito da correção de viés.
Vantagens: corrige deslocamento e assimetria, é invariante a transformações monótonas e costuma apresentar melhor precisão de cobertura em problemas regulares.
Desvantagens: é mais custoso e menos transparente, pois exige bootstrap e jackknife. Pode ser instável em amostras pequenas, com estatísticas não suaves, parâmetros na fronteira ou observações extremamente influentes. “Mais sofisticado” não compensa uma amostra não representativa ou uma unidade de reamostragem incorreta.
AvisoEmpates podem tornar a aceleração indefinida
Na amostra usada nesta aula, os preços inteiros produzem muitos empates perto das medianas. Todas as estimativas jackknife da diferença de medianas ficam iguais e o denominador da fórmula de \(a\) vale zero. Na comparação visual, adotamos \(a=0\), de modo que o intervalo mantém a correção de viés \(z_0\), mas não aplica correção de aceleração. Esse caso mostra por que o BCa pode ser instável para estatísticas não suaves e dados discretizados.
Método
Melhor cenário
Principal limitação
Percentil
distribuição bootstrap com pouco viés
não corrige deslocamento
Básico
erro bootstrap aproximadamente bem representado
não é invariante a transformações
Normal
estimador aproximadamente Normal e simétrico
ignora assimetria e restrições do parâmetro
BCa
problema regular com viés ou assimetria moderados
maior custo e possível instabilidade
NotaComo escolher
Não existe um intervalo universalmente melhor. Compare métodos, examine a distribuição bootstrap e verifique cobertura por simulação quando possível. Discordâncias relevantes são diagnóstico de viés, assimetria, pouca informação ou falta de regularidade — não um convite para escolher apenas o intervalo que produz a conclusão desejada.
Teste de hipótese e p-valor bootstrap
O intervalo de confiança descreve uma faixa de valores compatíveis com os dados. Para calcular um p-valor, precisamos da distribuição da estatística quando a hipótese nula é verdadeira.
Para a diferença entre as medianas populacionais de Manhattan e Brooklyn, definimos
em que \(m_M\) e \(m_B\) são as medianas populacionais e \(\Delta\) é sua diferença. O bootstrap usual reamostra os dados observados e fica centrado perto de \(\widehat\Delta=40\). Ele aproxima naturalmente a distribuição sob a alternativa observada, não sob \(H_0\).
Recentrar os grupos para impor H0
Subtraímos de cada observação a mediana de seu próprio grupo:
\(X_{gi}\) é a observação \(i\) do grupo \(g\); \(\widetilde X_g\) é a mediana amostral desse grupo; e \(X_{gi}^{(0)}\) é o valor recentralizado. Os dois grupos passam a ter mediana zero, mas preservam suas formas e dispersões observadas. Em seguida, reamostramos separadamente os dois grupos recentralizados.
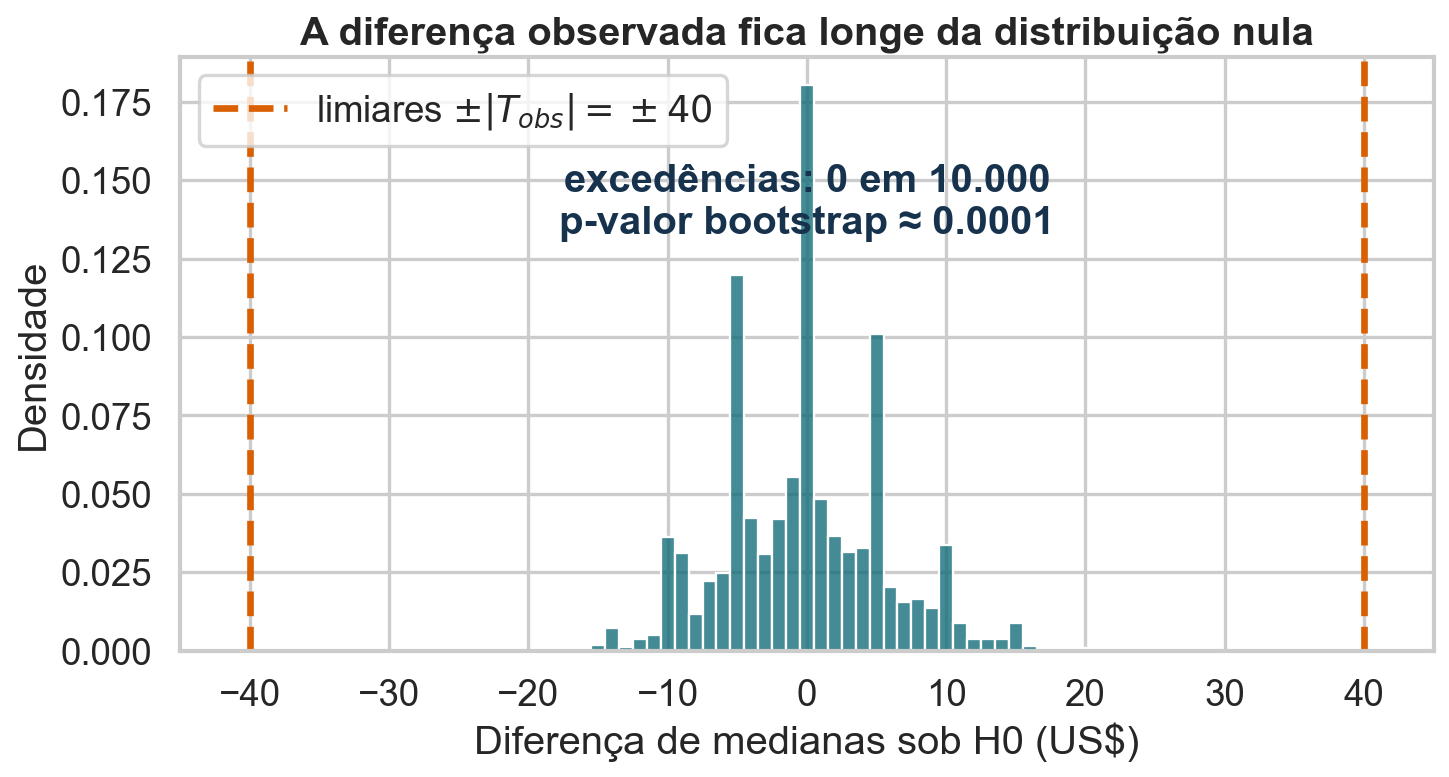
\(T_{obs}\) é a diferença observada; \(T_b^{*(0)}\) é a diferença da réplica \(b\) gerada sob \(H_0\); \(R\) é o número total de réplicas; e \(\mathbb 1(\cdot)\) vale 1 quando a réplica é pelo menos tão extrema quanto o resultado observado. A soma conta as excedências. Somar 1 ao numerador e ao denominador evita reportar p-valor exatamente zero por limitação da simulação.
NotaInterpretação
Nenhuma das 10.000 réplicas nulas atingiu uma diferença absoluta de US$ 40. Com a correção de Monte Carlo, \(\widehat p_{boot}=1/10.001\approx0{,}0001\). Isso representa forte evidência contra \(H_0\) dentro do modelo de reamostragem adotado. Se anúncios do mesmo anfitrião forem dependentes, o teste também deve reamostrar anfitriões, não anúncios isolados.
AvisoIntervalo e teste devem usar hipóteses compatíveis
Um intervalo percentil que não contém zero costuma apontar na mesma direção de um teste bilateral, mas a equivalência não é automática quando intervalo e teste usam construções diferentes. O p-valor acima vem explicitamente de uma distribuição recentralizada sob \(H_0\).
Exemplo A/B da Olist
Retomamos o experimento didático da Aula 11. Um alerta preventivo de risco de atraso seria comparado ao processo atual. A atribuição e os resultados abaixo são simulados; a base histórica da Olist fornece o contexto, mas não contém esse experimento randomizado.
\(p_A\) e \(p_B\) são as probabilidades populacionais de atraso nos dois processos. Valores negativos de \(\Delta\) favorecem o alerta. A diferença observada é
\[
\widehat\Delta=0{,}069-0{,}083=-0{,}014,
\]
ou uma redução de 1,4 ponto percentual.
Bootstrap usual: intervalo para o efeito
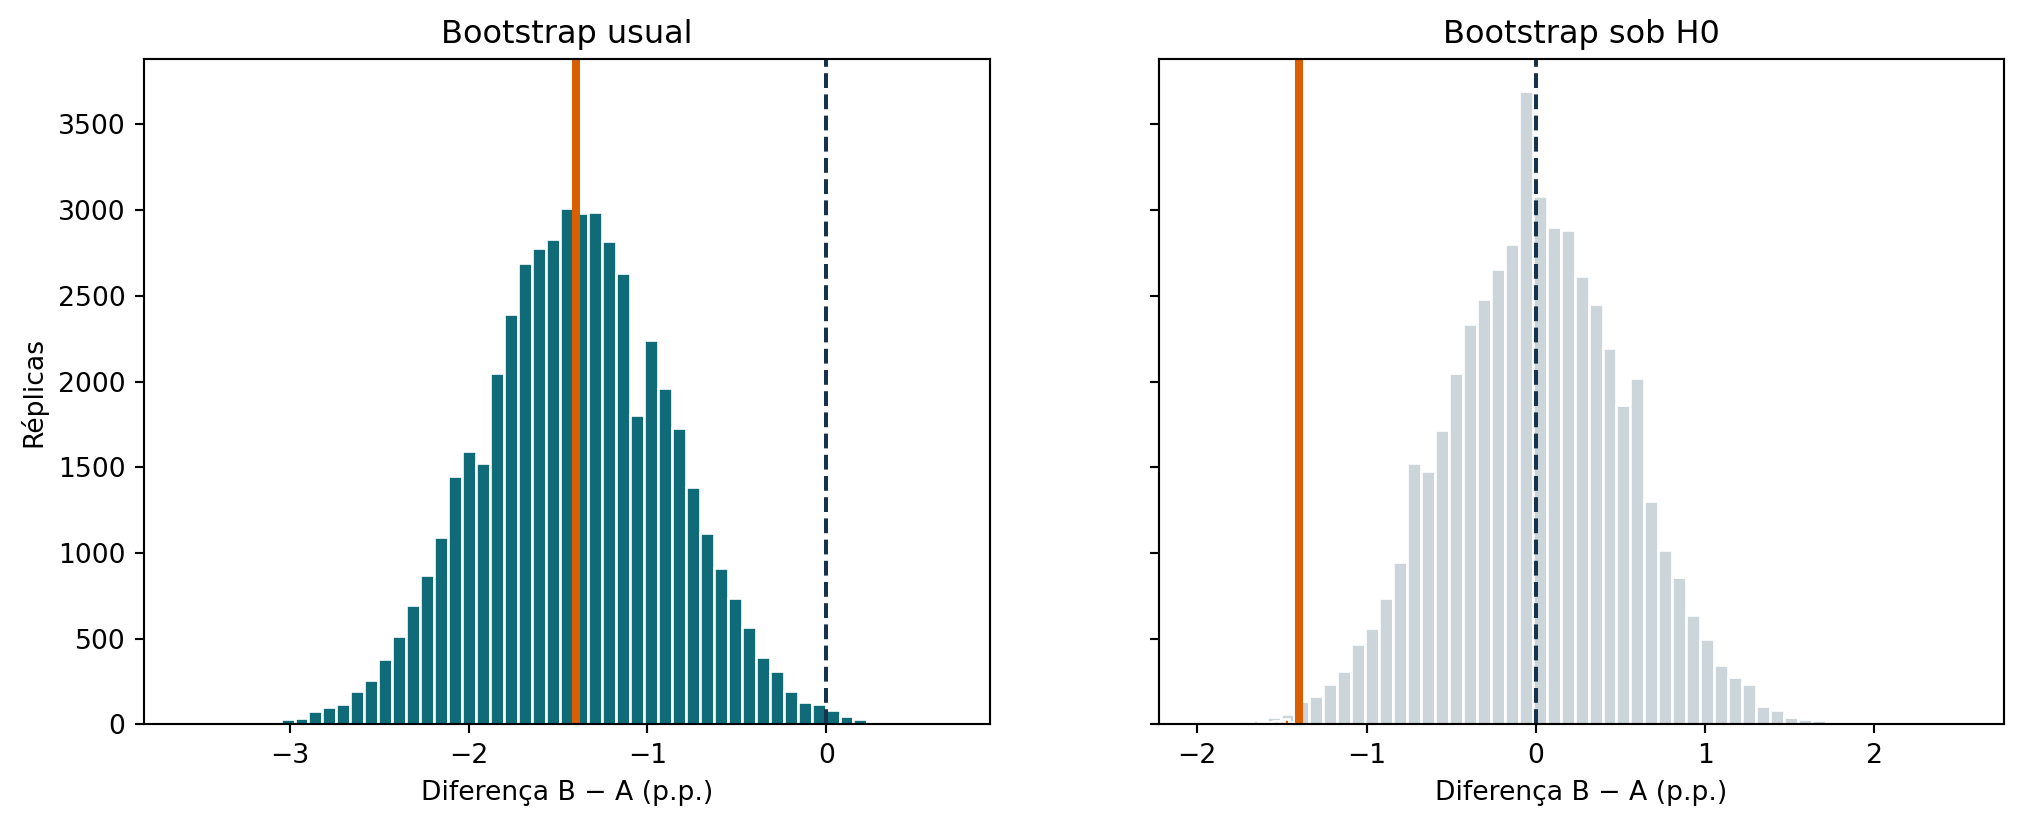
Construímos uma linha por pedido: 1 indica atraso e 0 indica entrega no prazo. Depois reamostramos essas linhas com reposição dentro de cada grupo. Esse código não usa o atalho Binomial: ele executa literalmente o sorteio das observações.
O intervalo percentil de 95% é \([-2{,}42;-0{,}38]\) pontos percentuais. Ele não contém zero e descreve a incerteza ao redor da redução observada. Essa distribuição bootstrap fica centrada perto de \(\widehat\Delta\), portanto ela representa o efeito ajustado aos dados, não o mundo nulo.
Bootstrap sob H0: valor-p
Sob \(H_0\), os dois processos têm a mesma taxa de atraso. Estimamos essa taxa combinando os grupos:
Juntamos os 10.000 resultados observados em uma única amostra empírica: 760 atrasos e 9.240 entregas no prazo. Em cada réplica, sorteamos com reposição dois novos grupos de 5.000 pedidos dessa mesma amostra. Como A e B passam a nascer da mesma distribuição empírica, a igualdade das médias é verdadeira no mundo nulo.
fig, axes = plt.subplots(1, 2, figsize=(12.5, 4.5), sharey=True)axes[0].hist(100* boot_effect_ab, bins=55, color="#0f6b78", edgecolor="white")axes[0].axvline(100* delta_ab, color="#d95f02", linewidth=3)axes[0].axvline(0, color="#17324d", linestyle="--")axes[0].set_title("Bootstrap usual")axes[0].set_xlabel("Diferença B − A (p.p.)")axes[0].set_ylabel("Réplicas")axes[1].hist(100* boot_null_ab, bins=55, color="#cbd5da", edgecolor="white")axes[1].hist(100* boot_null_ab[extreme_ab], bins=20, color="#d95f02", edgecolor="white")axes[1].axvline(100* delta_ab, color="#d95f02", linewidth=3)axes[1].axvline(0, color="#17324d", linestyle="--")axes[1].set_title("Bootstrap sob H0")axes[1].set_xlabel("Diferença B − A (p.p.)")plt.show()
NotaInterpretação
Se o alerta não tivesse efeito, diferenças iguais ou menores que \(-1{,}4\) ponto percentual surgiriam em aproximadamente 0,44% das reamostragens nulas. O teste \(z\) da Aula 11 produziu \(p\approx0{,}0041\). A proximidade mostra que os dois métodos contam a mesma história neste exemplo grande; a pequena diferença vem do erro de Monte Carlo do bootstrap.
O que torna a aproximação válida
Para um intervalo de nível nominal \(1-\alpha\), a cobertura frequentista é
em que \(P_F\) é a probabilidade calculada sobre amostras repetidas da população \(F\); \(CI(X_1,\ldots,X_n)\) é o intervalo produzido pela amostra; \(\theta\) é o parâmetro fixo; e \(1-\alpha\) é a cobertura desejada. A validade pertence ao procedimento repetido, não a um único intervalo já observado.
O bootstrap costuma funcionar quando a amostra representa a população, a unidade reamostrada corresponde à unidade independente e a estatística varia de maneira suficientemente regular. Ele pode falhar em amostras pequenas, extremos, parâmetros na fronteira, caudas não observadas, forte dependência ou seleção enviesada.
Reposição é indispensável: sem ela, toda réplica seria apenas uma reordenação da mesma amostra. Mais réplicas reduzem erro de Monte Carlo, mas não criam informação nem compensam poucos dados.
Unidade de reamostragem
Anúncios do mesmo anfitrião podem ser dependentes. Reamostrar anúncios individualmente pressupõe independência entre anúncios; reamostrar anfitriões preserva a dependência interna. Séries temporais podem exigir blocos; amostras estratificadas podem exigir reamostragem dentro dos estratos.
O método de intervalo não corrige uma unidade de reamostragem inadequada. Percentil, básico, Normal e BCa podem discordar, especialmente quando a distribuição bootstrap é assimétrica ou enviesada.
Questões de revisão da Aula 12
Por que uma réplica bootstrap de tamanho \(n\) é sorteada com reposição?
Se anúncios do mesmo anfitrião são dependentes, qual deve ser a unidade de reamostragem?
Por que o bootstrap usual precisa ser recentralizado para calcular o p-valor de \(H_0:\Delta=0\)?
No A/B binário, por que usamos a taxa combinada ao gerar réplicas sob \(H_0\)?
Respostas comentadas
Com reposição, algumas observações se repetem e outras ficam ausentes, fazendo a estatística variar. Sem reposição, teríamos apenas uma reordenação da amostra.
O anfitrião deve ser reamostrado como conglomerado, carregando seus anúncios. Aumentar \(R\) não corrige dependência ignorada.
O bootstrap usual fica centrado perto da diferença observada e aproxima a distribuição sob a alternativa ajustada aos dados. A recentralização força os grupos a satisfazerem \(H_0\), permitindo medir quão extremo é \(T_{obs}\) nessa distribuição nula.
Sob \(H_0\), os grupos compartilham a mesma probabilidade de atraso. A taxa combinada estima essa probabilidade usando todos os resultados e permite gerar dois grupos binários comparáveis sem preservar a diferença observada.