Este notebook usa uma única campanha A/B para construir o teste de permutação, auditar suas hipóteses e avançar para estatísticas robustas e permutações estratificadas. Ao final, você deverá saber o que pode ser permutado e por quê.
Como estudar este capítulo
O teste de permutação constrói a distribuição nula quebrando, de maneira controlada, a associação entre grupo e resposta. Em um experimento aleatorizado, a atribuição original dos rótulos fornece a justificativa: sob a hipótese de ausência de efeito, redistribuições compatíveis com o desenho são alternativas plausíveis à atribuição observada.
Cada permutação conserva os valores da resposta e reorganiza os rótulos permitidos. Calculamos a mesma estatística em todas as réplicas e comparamos o efeito observado com essa distribuição nula. O valor-p é a fração de estatísticas permutadas tão ou mais extremas que a observada.
As Aulas 13 e 14 compartilham este capítulo. A primeira desenvolve o caso A/B básico. A segunda pergunta o que muda com estatísticas assimétricas, estratos, pares ou dependência. A regra central é preservar o desenho: não se deve permutar livremente observações que só são trocáveis dentro de blocos ou pares.
1. Download da base
import kagglehubfrom pathlib import Pathimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport seaborn as snspath = kagglehub.dataset_download("faviovaz/marketing-ab-testing")csv_path =next(Path(path).rglob("marketing_AB.csv"))df = pd.read_csv(csv_path).drop(columns=["Unnamed: 0"])df.head()
Warning: Looks like you're using an outdated `kagglehub` version (installed: 0.3.13), please consider upgrading to the latest version (1.0.2).
user id
test group
converted
total ads
most ads day
most ads hour
0
1069124
ad
False
130
Monday
20
1
1119715
ad
False
93
Tuesday
22
2
1144181
ad
False
21
Tuesday
18
3
1435133
ad
False
355
Tuesday
10
4
1015700
ad
False
276
Friday
14
NotaInterpretação
Antes de interpretar resultados, confirme o que cada linha representa, o período coberto e as colunas realmente disponíveis. Essa definição determina quais agregações e comparações são válidas.
2. O que é a base?
A unidade observacional é um usuário. test group registra a atribuição ao anúncio comercial (ad, tratamento) ou PSA (psa, controle); converted é a resposta primária. total ads, most ads day e most ads hour descrevem a exposição registrada durante a campanha.
A permutação constrói a referência de H0 ao quebrar a associação entre rótulo e resposta. Isso exige trocaabilidade; blocos, pares ou clusters do desenho original precisam ser preservados.
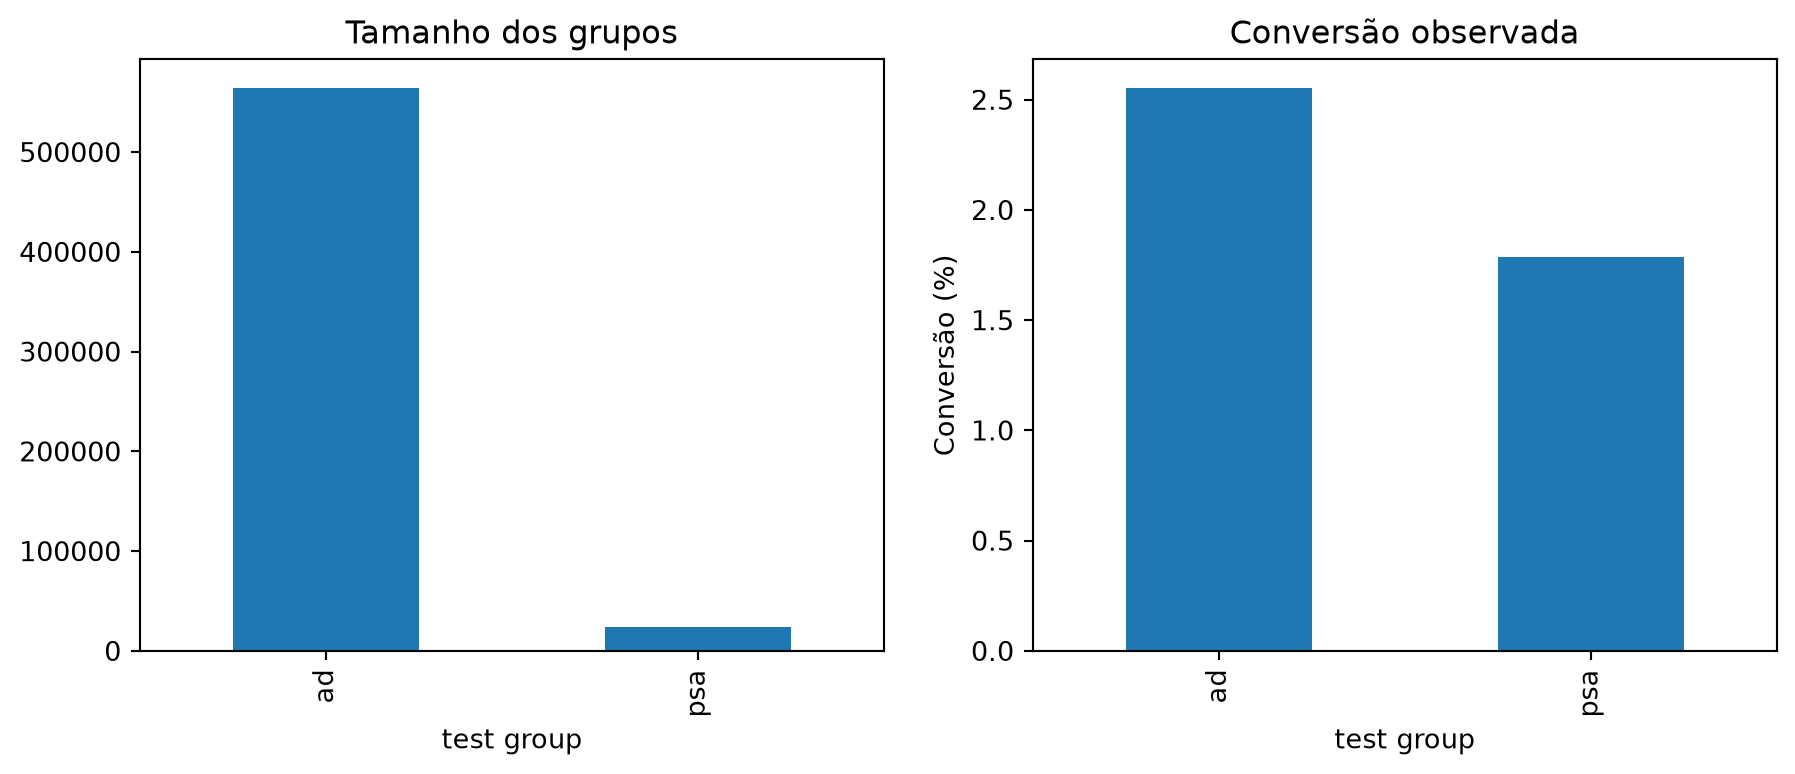
O forte desbalanceamento não prova falha de randomização, mas reduz a precisão do controle. A documentação pública afirma que se trata de um A/B, porém não detalha o algoritmo de atribuição; registre essa limitação.
A diferença absoluta informa quantas conversões adicionais ocorreram por usuário exposto; o uplift relativo compara essa diferença com a taxa do controle. São escalas complementares e ambas devem acompanhar a incerteza.
Para execução rápida em computadores modestos, retire uma amostra estratificada. Depois compare com a versão eficiente da seção seguinte.
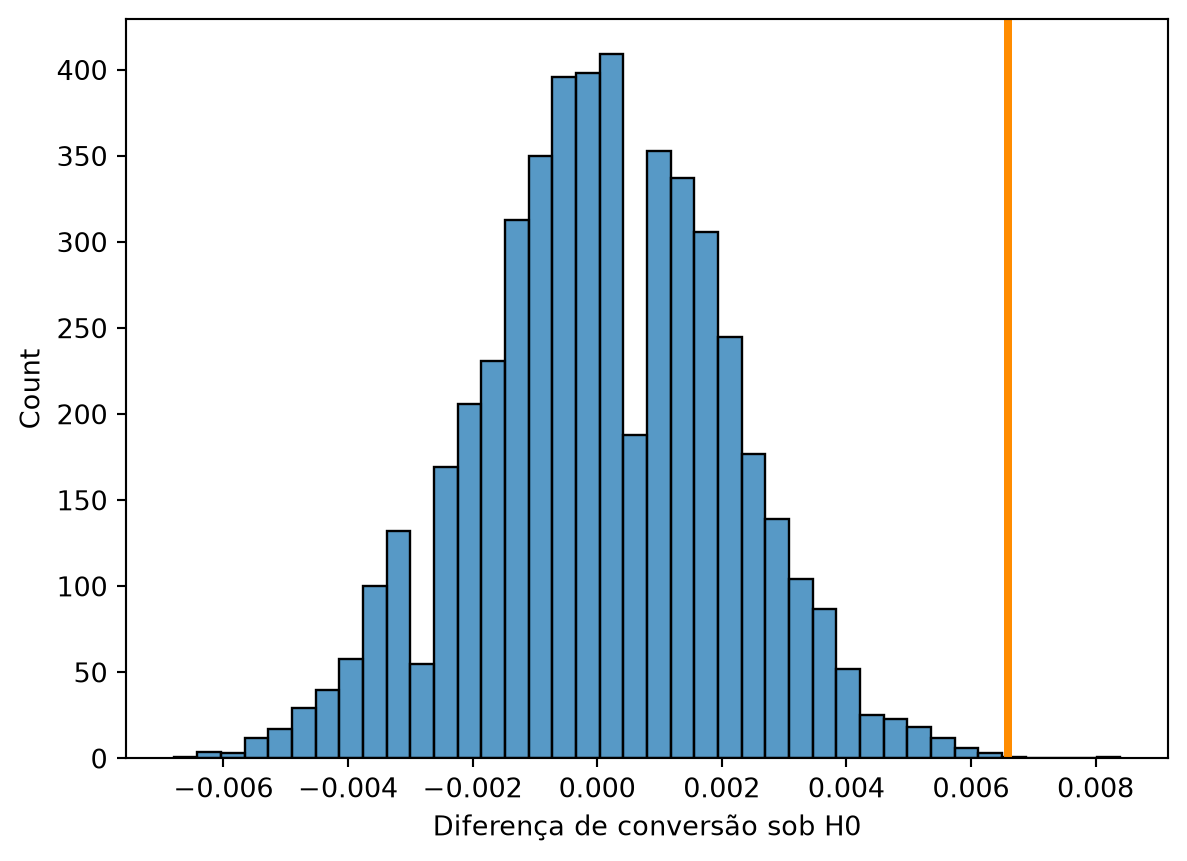
small = df.groupby("test group", group_keys=False).sample(n=10000, random_state=12)y = small["converted"].astype(float).to_numpy()g = small["test group"].to_numpy()t_obs, null, p_value = permutation_test(y, g, B=5000)print(t_obs, p_value)sns.histplot(null, bins=40)plt.axvline(t_obs, color="darkorange", linewidth=3)plt.xlabel("Diferença de conversão sob H0")plt.show()
0.006600000000000002 0.0007998400319936012
NotaInterpretação
A distribuição permutada reúne diferenças produzidas quando o rótulo de grupo não carrega efeito. O valor-p é a fração de permutações pelo menos tão extremas quanto a diferença observada.
7. Atalho exato para uma resposta binária
Condicionado ao número total de conversões e aos tamanhos dos grupos, o número de conversões atribuídas a ad segue uma distribuição hipergeométrica.
Para uma resposta binária, o atalho hipergeométrico reproduz a lógica da permutação condicionando o total de conversões. Ele evita embaralhar milhões de rótulos sem mudar a hipótese nula.
Defina a direção antes de olhar os resultados. Não selecione unilateral apenas porque o efeito observado ficou na direção desejada.
Interlúdio — o mesmo A/B com bootstrap e permutação
A permutação já forneceu uma distribuição nula e um valor-p para a campanha. Agora resolveremos o mesmo problema com bootstrap. A comparação exige separar duas tarefas diferentes:
o bootstrap usual aproxima a incerteza ao redor do efeito observado;
o bootstrap sob \(H_0\) precisa impor uma taxa comum aos dois grupos para produzir um valor-p.
Bootstrap usual: distribuição do efeito e intervalo
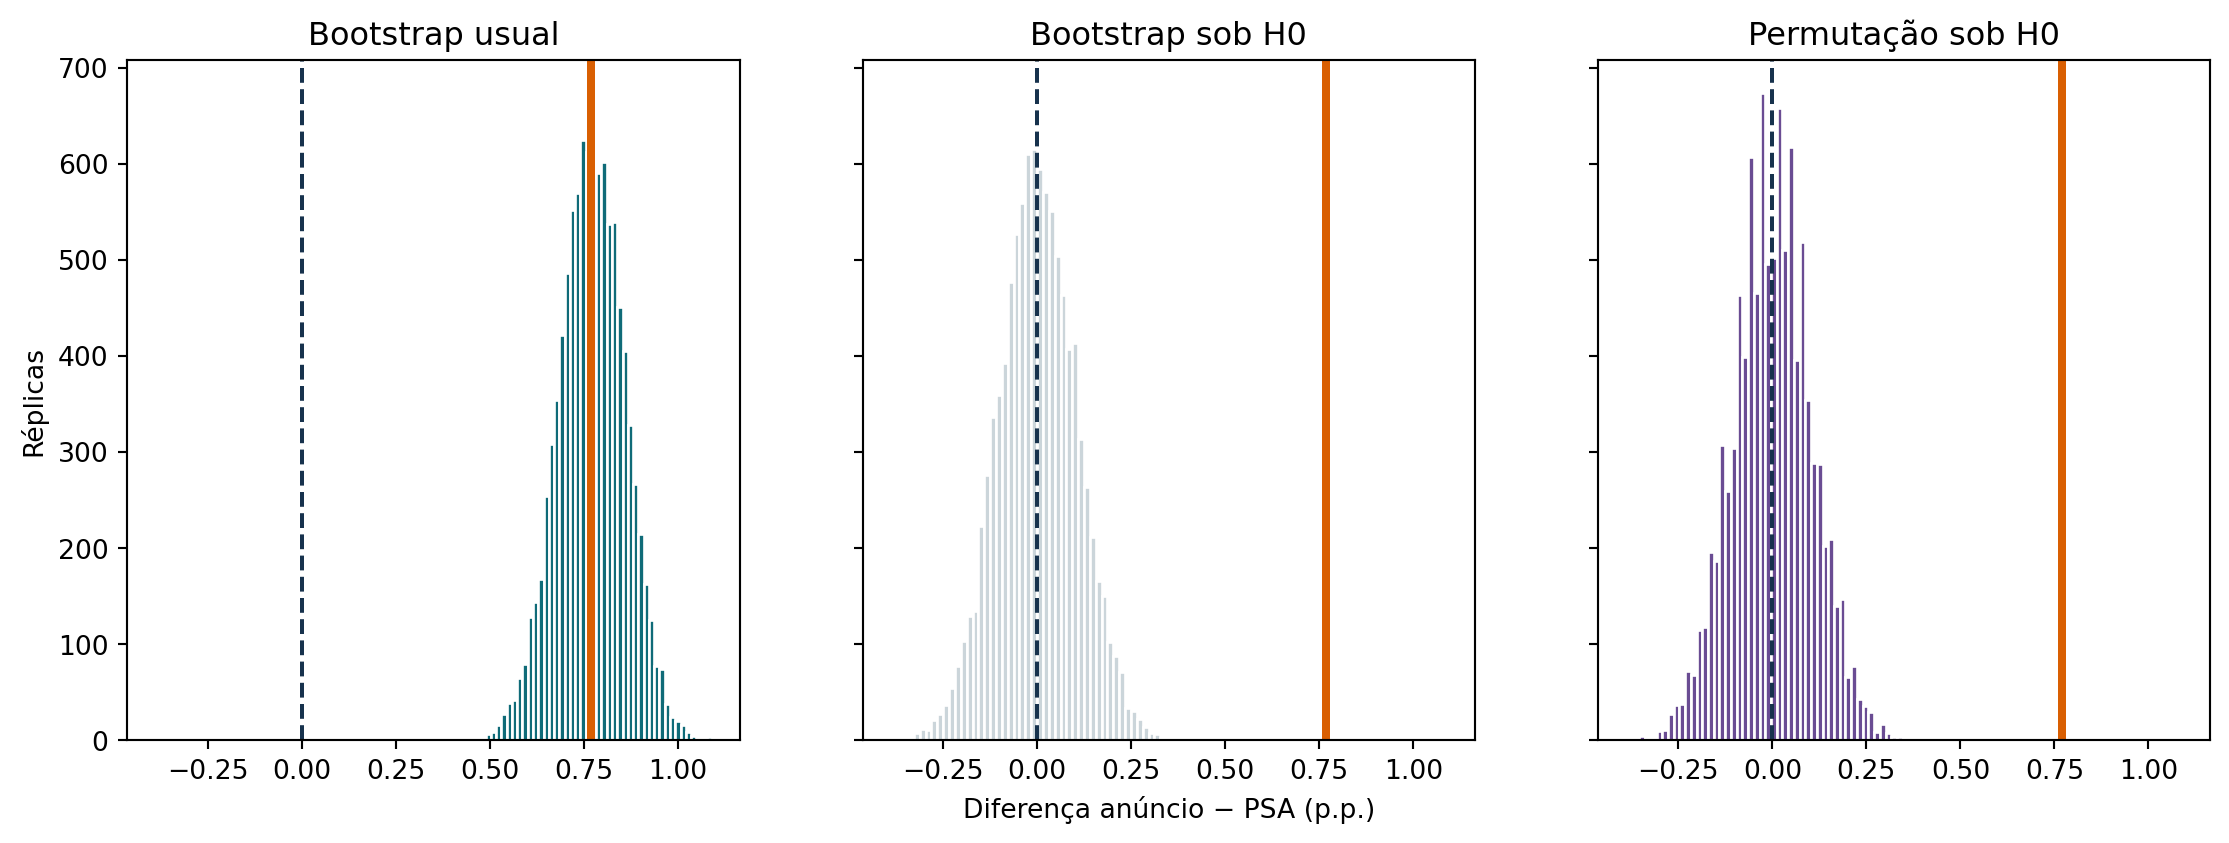
ou aproximadamente 0,77 ponto percentual. No bootstrap usual, reamostramos usuários com reposição separadamente dentro de cada grupo. Como converted é binária, sortear o número de conversões por uma Binomial é um atalho exatamente equivalente a reamostrar zeros e uns com reposição.
Efeito observado: 0.769 p.p.
IC bootstrap 95%: [0.592; 0.940] p.p.
NotaInterpretação
A distribuição bootstrap usual fica centrada perto de \(\widehat\Delta\). O intervalo de 95% não contém zero, indicando que a diferença é incompatível com efeitos muito próximos de zero sob esse procedimento. Isso quantifica a incerteza do efeito, mas ainda não é uma simulação construída sob \(H_0\).
Bootstrap sob \(H_0\): uma taxa comum
Para calcular um valor-p, precisamos gerar réplicas em um mundo no qual anúncio e PSA tenham a mesma taxa de conversão. Estimamos essa taxa comum por
Aqui, \(\Delta_b^{*(0)}\) é a diferença da réplica bootstrap \(b\) gerada sob a taxa comum, e \(R=10.000\). Nenhuma réplica alcançou a diferença observada; a correção de Monte Carlo produz \(1/10.001\approx0{,}0001\). Esse número representa o limite de resolução da simulação, não um valor-p exatamente igual a 0,0001.
Comparação com a permutação
Para tornar a comparação justa, repetimos a permutação com 10.000 réplicas e a mesma regra bilateral. Como a resposta é binária, o sorteio hipergeométrico redistribui entre os grupos o total fixo de conversões e reproduz a permutação dos rótulos com muito menos memória.
Bootstrap sob \(H_0\) e permutação ficaram centrados em zero e não produziram réplicas tão extremas quanto o efeito observado. Os valores-p coincidem na resolução de 10.000 simulações, mas os mecanismos são diferentes: o bootstrap gera novas respostas a partir de uma taxa comum estimada; a permutação mantém as respostas observadas fixas e redistribui seus rótulos conforme o desenho.
Parte II — Aula 14: permutação e desenho experimental
A Aula 13 tratou do cenário mais simples: dois grupos, unidades independentes e rótulos livremente permutáveis. Esse caso é a porta de entrada, não uma receita universal. Na prática, três escolhas precisam ser justificadas antes de executar o teste:
qual estatística representa a pergunta científica?
quais unidades podem realmente trocar de rótulo?
qual hipótese nula a simulação representa?
Nesta segunda parte, cada extensão nasce de uma alteração em uma dessas escolhas. A estatística pode mudar porque média, mediana e média aparada descrevem aspectos diferentes. O conjunto de permutações pode diminuir porque o desenho possui estratos, pares ou clusters. A interpretação também pode mudar conforme testamos ausência de qualquer efeito individual ou efeito médio zero.
NotaRegra de leitura
Um teste de permutação não é definido apenas pela linha de código que embaralha os rótulos. Ele é definido pelo trio hipótese nula + estatística + conjunto de permutações admissíveis.
9. Uma métrica assimétrica
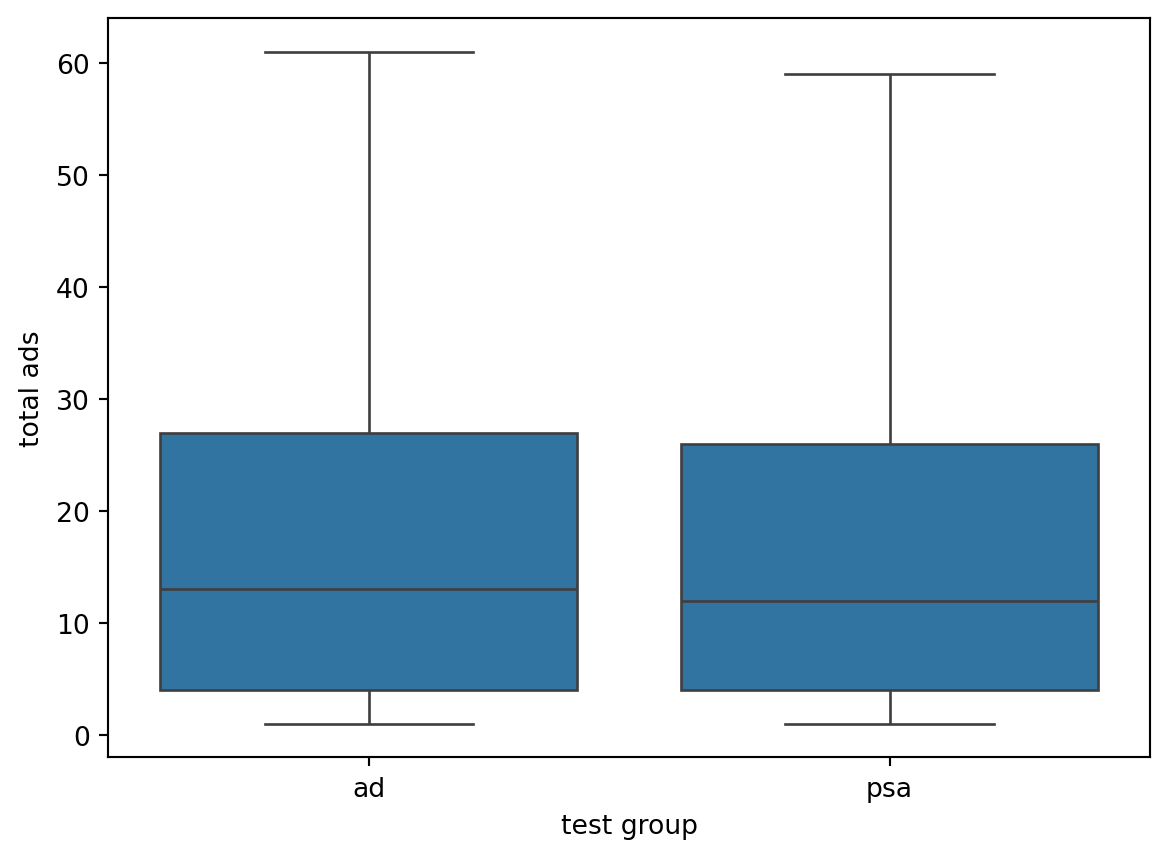
A conversão é binária, mas total ads é uma contagem com forte assimetria à direita: muitos usuários veem poucos anúncios e poucos usuários acumulam muitas exposições. Nessa situação, resumir os grupos por um único número exige decidir qual aspecto da distribuição interessa.
A média responde pela exposição total dividida entre os usuários e é sensível aos casos muito expostos.
A mediana descreve uma posição central: metade dos usuários fica abaixo e metade acima.
A média aparada remove uma proporção previamente definida das duas caudas e calcula a média do restante.
Esses resumos não são versões intercambiáveis da mesma pergunta. Se um anúncio aumentar apenas a cauda superior, a média poderá mudar mesmo quando a mediana permanecer praticamente constante.
A média reage fortemente à cauda de usuários muito expostos, enquanto a mediana descreve um usuário central. Como exposição pode ocorrer depois da atribuição, este contraste é descritivo e não deve ser tratado automaticamente como efeito causal.
Compare diferenças de média, mediana e média aparada. Explique qual aspecto de comportamento cada estatística representa. Lembre que exposição pode ser uma variável pós-tratamento: esta análise é descritiva, não um ajuste causal.
10. Estatísticas robustas
Para dois grupos, podemos usar como estatística qualquer função que seja recalculada exatamente da mesma maneira após cada permutação. Três escolhas são
Aqui, \(\bar X_g\) é a média do grupo \(g\), \(\widetilde X_g\) é sua mediana e \(\bar X_{g,\alpha}\) é a média após remover a fração \(\alpha\) de cada cauda. Nesta aula usamos \(\alpha=0{,}10\).
Um exemplo pequeno antes do código
Considere as exposições de cinco usuários:
\[1, 2, 3, 4, 100.\]
A média é \(22\), a mediana é \(3\) e a média aparada em 20% também é \(3\), pois removemos \(1\) e \(100\) antes de calcular \((2+3+4)/3\). O exemplo não demonstra que a média seja inadequada: o valor \(100\) pode ser real e substantivamente importante. Ele mostra que a escolha do resumo determina quanto a cauda superior participa da comparação.
AvisoRobustez não significa apagar dados incômodos
O nível de aparagem deve ser definido por uma justificativa substantiva ou pelo plano de análise, não escolhido depois de observar qual versão produz o menor valor-p.
Estatísticas diferentes testam aspectos diferentes da distribuição. Resultados divergentes indicam que o efeito sobre o centro aritmético, o centro ordinal e a parte menos extrema dos dados não é o mesmo.
Um valor-p pequeno para a diferença de médias não implica automaticamente uma diferença de medianas. O teste não pergunta se “os grupos são diferentes” em sentido genérico; ele pergunta se a estatística escolhida seria extrema sob as trocas autorizadas por \(H_0\).
11. Variáveis pós-tratamento e permutação estratificada
Por que total ads é pós-tratamento?
Na campanha, test group registra o conteúdo atribuído pelo sorteio e converted registra a resposta. Já total ads é acumulado durante a campanha, depois da atribuição. Portanto, o tratamento pode modificar essa variável. Um anúncio mais atraente pode manter o usuário ativo por mais tempo e aumentar o número de exposições:
\[
T\longrightarrow M\longrightarrow Y,
\]
em que \(T\) é o conteúdo atribuído, \(M\) representa total ads e \(Y\) indica conversão. Nesse mecanismo, \(M\) mede parte do caminho pelo qual o tratamento atua. Condicionar em \(M\) pode bloquear parte do efeito total de \(T\) sobre \(Y\).
A ordem também pode operar no outro sentido durante a observação. Se a conversão encerra ou altera as exposições posteriores, temos
\[
T\longrightarrow Y\longrightarrow M.
\]
Além disso, características não registradas, como interesse prévio, podem aumentar simultaneamente exposição e conversão. Comparar somente usuários com o mesmo total ads pode então selecionar perfis diferentes nos grupos ad e psa, desfazendo a comparabilidade criada pela randomização.
As colunas most ads day e most ads hour também são construídas a partir da exposição ocorrida durante a campanha. Elas não representam necessariamente o dia ou a hora em que o usuário entrou no experimento.
NotaInterpretação
Essas variáveis continuam úteis para descrever a experiência observada. O problema surge quando são tratadas como covariáveis prévias ou blocos do sorteio para sustentar uma interpretação causal.
Permutação estratificada em um desenho válido
Suponha, agora de forma hipotética, que a atribuição tenha sido realizada separadamente pelo dia de entrada, conhecido antes do tratamento. Uma unidade que entrou na segunda-feira poderia ter recebido ad ou psa dentro desse estrato, mas não poderia trocar de lugar com uma unidade de domingo. A permutação livre inventaria atribuições que o experimento nunca poderia gerar.
Chamando os estratos de \(s=1,\ldots,S\), uma estatística combinada pode ser
\(\widehat p_{g,s}\) é a conversão observada no grupo \(g\) dentro do estrato \(s\);
\(w_s\) é o peso atribuído ao estrato \(s\);
\(T\) é a média ponderada das diferenças internas aos estratos.
Pesos proporcionais ao número de usuários fazem estratos maiores contribuírem mais. Outros pesos podem ser válidos, mas devem ser definidos antes da análise e mantidos em todas as permutações.
Algoritmo da permutação estratificada
Para cada réplica:
mantenha respostas, dias e tamanhos dos grupos fixos;
embaralhe ad e psaseparadamente dentro de cada dia;
calcule a diferença de conversão em cada dia;
combine as diferenças usando os mesmos pesos;
compare a estatística observada com a distribuição obtida.
O código abaixo usa most ads day apenas para tornar a mecânica computacional concreta. Como essa coluna é pós-tratamento, o resultado deve ser lido como uma análise exploratória. Em um experimento real, ela deve ser substituída pelo estrato pré-tratamento efetivamente utilizado na atribuição.
Efeito estratificado observado: 0.00600
Centro da distribuição nula: 0.00035
p-valor aproximado: 0.1262
NotaInterpretação
Restringir as trocas ao mesmo estrato preserva diferenças sistemáticas entre blocos. A interpretação causal só é válida quando esses blocos foram definidos antes do tratamento e as trocas reproduzem o sorteio real.
Exemplo didático: por que preservar os estratos?
Imagine que a conversão seja naturalmente maior no fim de semana e que, por acaso, o grupo ad contenha proporção maior de usuários desses dias. Uma permutação livre mistura composição do calendário com efeito do anúncio. Ao permutar dentro de cada dia, comparamos tratamento e controle sob o mesmo contexto temporal e depois agregamos essas comparações.
Isso não significa que estratificar por qualquer variável observada melhora o teste. Estratificar por uma variável pós-tratamento pode condicionar a análise em algo causado pelo próprio tratamento e alterar a pergunta causal.
12. Dados pareados: a troca ocorre dentro de cada par
Em um desenho pareado, cada unidade tratada é associada a uma unidade controle semelhante, ou a mesma unidade é observada sob duas condições. O objeto básico deixa de ser cada observação isolada e passa a ser a diferença do par:
\[D_i=Y_{i,1}-Y_{i,0}.\]
Sob uma nula de ausência de efeito e uma atribuição simétrica dentro do par, o sinal de \(D_i\) pode ser invertido. Uma réplica do teste escolhe \(S_i\in\{-1,+1\}\) e calcula
\[
T_b=\frac{1}{m}\sum_{i=1}^{m}S_{i,b}D_i,
\]
em que \(m\) é o número de pares e \(S_{i,b}\) é o sinal sorteado para o par \(i\) na réplica \(b\). Permutar todas as observações livremente destruiria o pareamento que controla diferenças entre as unidades.
NotaConexão com a permutação
Esse procedimento não introduz um teste separado. Trocar os rótulos A/B dentro do par transforma \(D_i\) em \(-D_i\); manter a ordem conserva \(D_i\). Sortear um sinal é apenas uma maneira compacta de programar as duas trocas permitidas.
NotaExemplo
Se três diferenças forem \(D=(2,-1,4)\), uma réplica possível usa sinais \(S=(-1,+1,-1)\) e produz \((-2-1-4)/3=-7/3\). Não reorganizamos os seis resultados individualmente: apenas trocamos qual condição ocupa cada posição dentro do par.
13. Experimentos em clusters
Se escolas, cidades ou turmas inteiras recebem o tratamento, a randomização ocorre no nível do cluster. Alunos da mesma escola compartilham contexto e não foram atribuídos independentemente. Portanto, os rótulos devem ser permutados entre escolas, mantendo todos os alunos de uma escola juntos.
Permutar alunos produz artificialmente muito mais unidades aleatórias do que o desenho realmente possui. Isso costuma estreitar a distribuição nula e gerar valores-p excessivamente pequenos. Ter milhares de indivíduos não substitui ter um número adequado de clusters independentes.
NotaExemplo
Oito escolas participam do estudo e quatro recebem um novo método de ensino. Há oito unidades sorteadas, não centenas de alunos independentes. Em cada permutação, o rótulo muda para a escola inteira.
Interferência entre unidades
A permutação usual pressupõe que o resultado de uma unidade não muda quando o tratamento de outra unidade muda. Essa condição falha quando há interação entre participantes.
NotaExemplo
Em uma rede social, um usuário tratado recebe um recurso de convite e chama um amigo do grupo controle. O comportamento do amigo dependeu do tratamento de outra pessoa. Trocar rótulos individualmente, ignorando a rede, pode representar um experimento impossível.
Perdas de acompanhamento
Se permanecer no estudo depende do tratamento e do resultado, comparar apenas os casos observados pode desfazer a comparabilidade criada pela randomização.
NotaExemplo
Começamos com 100 alunos por grupo. Se 30 alunos com baixo desempenho abandonam apenas o grupo tratado, a média dos 70 restantes pode aumentar por seleção, mesmo sem melhora individual. Permutar apenas os casos completos não recupera os dados ausentes nem corrige esse mecanismo.
NotaPrática recomendada
Reporte a taxa, o momento e os motivos das perdas separadamente por grupo. Preserve o grupo originalmente sorteado e faça uma análise de sensibilidade: recalcule a conclusão sob cenários plausíveis para os resultados ausentes, incluindo um cenário desfavorável ao tratamento. A estabilidade da conclusão entre os cenários é mais informativa do que uma única análise por casos completos.
14. Qual hipótese nula está sendo testada?
O passo escondido no algoritmo
Uma permutação simples troca os rótulos dos grupos, mas mantém os resultados observados fixos. Considere este exemplo:
pessoa
dados observados
após permutar os rótulos
Ana
tratamento, resultado 10
controle, resultado 10
Bruno
controle, resultado 4
tratamento, resultado 4
O algoritmo atribui Ana ao controle, mas conserva seu resultado 10. Ele também atribui Bruno ao tratamento e conserva seu resultado 4. Para que essa nova tabela corresponda exatamente a um experimento possível, Ana precisaria ter resultado 10 em qualquer grupo e Bruno precisaria ter resultado 4 em qualquer grupo.
Essa condição é a nula estrita de Fisher:
\[
H_0^F:Y_i(1)=Y_i(0)\quad\text{para todo }i.
\]
\(Y_i(1)\) e \(Y_i(0)\) são os resultados potenciais da unidade \(i\) sob tratamento e controle. Sob essa hipótese, mudar a atribuição não muda o resultado de ninguém. Por isso, podemos reconstruir exatamente o resultado sob qualquer randomização permitida usando os valores já observados.
NotaPor que a nula estrita aparece?
Ela não aparece porque seja sempre a pergunta científica mais interessante. Ela aparece porque justifica exatamente a operação “trocar os rótulos e manter os resultados”. Essa é a base do teste de randomização exato de Fisher.
Ela permite efeitos individuais diferentes, positivos e negativos, que se cancelam. Por exemplo, um efeito de \(+4\) para Ana e de \(-4\) para Bruno produz efeito médio zero. Entretanto, quando seus grupos mudam, seus resultados também podem mudar. Apenas trocar os rótulos e conservar os valores observados não reconstrói necessariamente esse novo experimento.
Rejeitar a nula estrita não é logicamente igual a demonstrar que o efeito médio seja diferente de zero.
Permutação sob a nula estrita
Sob \(H_0^F\), cada resultado seria o mesmo em tratamento e controle. Podemos manter os resultados observados fixos e reconstruir exatamente todas as atribuições permitidas pelo sorteio. O valor-p resultante é exato para essa hipótese.
Permutação sob a nula média
Sob \(H_0^m\), os efeitos individuais podem existir e se cancelar. Como não observamos simultaneamente \(Y_i(1)\) e \(Y_i(0)\), não conseguimos reconstruir exatamente todos os resultados potenciais. Ainda podemos usar uma permutação adaptada, geralmente com a estatística studentizada
em que \(s_g^2\) é a variância amostral e \(n_g\) é o tamanho do grupo \(g\). Em cada permutação, o numerador e o denominador devem ser recalculados. Sob condições regulares e com amostras suficientemente grandes, esse procedimento fornece um teste assintoticamente válido para o efeito médio.
NotaInterpretação
A mesma operação aparente esconde garantias diferentes. Para a nula estrita, manter os resultados fixos depois de trocar os rótulos é coerente e o teste é exato pelo desenho. Para a nula média, resultados individuais podem mudar com a atribuição. A permutação simples da diferença de médias não basta em geral; a studentização fornece uma adaptação cuja justificativa costuma ser assintótica.
Quando usar cada hipótese?
A escolha deve partir do parâmetro e da pergunta científica, não apenas da conveniência computacional.
Hipótese
Pergunta respondida
Quando é adequada?
O que uma rejeição permite concluir?
nula estrita de Fisher
o tratamento deixou todas as unidades inalteradas?
quando buscamos um teste de randomização exato para ausência completa de efeito e conhecemos o mecanismo de atribuição
existe evidência de que ao menos uma unidade foi afetada
nula de efeito médio
o tratamento altera o resultado em média?
quando a decisão depende do efeito médio, como ocorre frequentemente em experimentos A/B, políticas e produtos
existe evidência de que o efeito médio difere de zero
A nula estrita pode ser útil como uma verificação global de ausência de efeito, mas é mais forte que a hipótese sobre a média. Se efeitos positivos e negativos se cancelarem, a nula estrita poderá ser falsa enquanto o efeito médio continua igual a zero. Por isso, rejeitar a nula estrita não responde automaticamente à pergunta sobre o efeito médio.
NotaRegra prática
Em um experimento A/B cujo objetivo é escolher a versão com melhor desempenho médio, a nula de efeito médio costuma ser o alvo principal. Use a nula estrita quando a ausência de qualquer efeito individual for realmente a pergunta ou quando quiser apresentar o teste exato de Fisher deixando explícito o alvo que ele testa.
Exemplo numérico: efeitos que se cancelam
Considere duas unidades com os seguintes resultados potenciais:
unidade
controle \(Y_i(0)\)
tratamento \(Y_i(1)\)
efeito \(\tau_i=Y_i(1)-Y_i(0)\)
Ana
6
10
\(+4\)
Bruno
10
6
\(-4\)
Para a nula estrita de Fisher, precisaríamos de \(\tau_i=0\) para cada unidade. Entretanto, Ana possui efeito \(+4\) e Bruno possui efeito \(-4\). Portanto,
\[
H_0^F:Y_i(1)=Y_i(0)\ \text{para todo }i
\]
é falsa: o tratamento afeta as duas pessoas, embora em direções opostas.
Logo, a nula de efeito médio é verdadeira. O tratamento beneficia Ana em quatro unidades e prejudica Bruno na mesma quantidade, produzindo ganho médio zero.
NotaInterpretação
O exemplo satisfaz a nula média e viola a nula estrita. Isso mostra que as duas hipóteses não são formulações intercambiáveis. Se a decisão depende do ganho médio, concluímos que não há melhoria média. Se a pergunta é se alguém foi afetado, a resposta é sim.
15. Checklist de validade
Antes de interpretar causalmente:
confirme a unidade e a probabilidade de randomização;
verifique duplicatas, perdas e desvio da alocação planejada;
preserve blocos, pares ou clusters na permutação;
não ajuste ingenuamente por variáveis pós-tratamento;
defina previamente a métrica primária e a cauda do teste.
16. Exercícios
Refaça o teste usando risco relativo em vez de diferença absoluta.
Compare o resultado com um teste-z de duas proporções.
Escreva as trocas permitidas em um estudo pareado com quatro participantes.
Simule um experimento em clusters e mostre por que permutar pessoas é errado.
Crie um cenário em que média e mediana levem a conclusões diferentes.
Explique a diferença entre a nula estrita de Fisher e efeito médio zero.
Fonte e limites
Marketing A/B Testing, Kaggle, faviovaz/marketing-ab-testing, licença CC0. A base é adequada para ensino, mas a documentação disponível não informa todos os detalhes operacionais da randomização. Essa ausência deve acompanhar qualquer afirmação causal.
Guia teórico consolidado das Aulas 13 e 14
O princípio da permutação
Sob uma hipótese nula de ausência de associação entre tratamento e resultado, os rótulos podem ser trocáveis. Mantemos os resultados fixos, permutamos os rótulos e recalculamos a estatística. Isso constrói a distribuição nula induzida pelo desenho.
Em Monte Carlo, uma estimativa segura do valor-p é
\[\widehat p=\frac{1+\#\{T_b\text{ tão extremo quanto }T_{obs}\}}{B+1},\]
em que:
\(\widehat p\) é o valor-p estimado por simulação;
\(T_{obs}\) é o valor da estatística calculada nos grupos originalmente observados;
\(T_b\) é a estatística recalculada na \(b\)-ésima permutação dos rótulos, com \(b=1,\ldots,B\);
\(B\) é o número total de permutações aleatórias realizadas;
\(\#\{\cdot\}\) significa “número de ocorrências”: contamos quantas estatísticas permutadas são pelo menos tão extremas quanto \(T_{obs}\) sob a alternativa escolhida.
“Tão extremo” depende da hipótese alternativa. Em um teste unilateral à direita, contamos \(T_b\geq T_{obs}\); à esquerda, \(T_b\leq T_{obs}\); em um teste bilateral com uma estatística centrada em zero, é comum contar \(|T_b|\geq|T_{obs}|\).
Os termos \(+1\) no numerador e no denominador incluem conceitualmente a configuração observada entre as possibilidades consideradas. Essa correção evita reportar valor-p igual a zero quando nenhuma das \(B\) permutações aleatórias supera \(T_{obs}\). A direção unilateral ou bilateral deve ser definida antes de observar os resultados.
Permutação não é bootstrap
Permutação quebra a associação para representar \(H_0\). Bootstrap reamostra unidades para aproximar a incerteza sob uma distribuição empírica. Eles podem usar código parecido, mas respondem perguntas diferentes.
No A/B desta aula, o bootstrap usual reamostra separadamente dentro de anúncio e PSA e, por isso, preserva a diferença observada em seu centro. Para produzir um valor-p bootstrap, impusemos \(H_0\) fazendo ambos os grupos nascerem da taxa combinada \(\widehat p_{pool}\). A permutação impõe a mesma ausência de associação mantendo todas as respostas fixas e trocando apenas os rótulos. A proximidade dos resultados é uma consequência esperada neste exemplo grande e simples, não uma afirmação de que os dois procedimentos sejam sempre intercambiáveis.
Mapa de decisão para a Aula 14
Situação do estudo
O que deve ser preservado?
Seção para revisar
resposta assimétrica ou com extremos
estatística definida antes da análise
9–10
atribuição feita dentro de estratos
totais de tratamento dentro de cada estrato
11
observações pareadas
vínculo e troca interna de cada par
12
tratamento sorteado para clusters
unidades do mesmo cluster juntas
13
interferência ou perdas após o sorteio
mecanismo de influência e observação
13
interesse em efeito médio, não nula estrita
hipótese correta
14
Esse mapa não substitui o desenho do estudo. Ele serve para localizar a extensão adequada e verificar se o código imita as atribuições que realmente poderiam ter ocorrido.
Questões de revisão das Aulas 13 e 14
O que permanece fixo e o que varia em uma permutação simples de dois grupos?
Quando a alternativa deve ser bilateral?
Como permutar quando a atribuição ocorreu separadamente dentro de cada estrato?
Qual é a diferença entre a nula estrita de Fisher e uma nula de efeito médio zero?
Por que média e mediana podem produzir valores-p diferentes na mesma base?
Qual é o erro de permutar indivíduos quando o tratamento foi sorteado por escola?
Em um estudo pareado, qual objeto recebe a troca aleatória?
Por que escolher a porcentagem de aparagem depois de ver os valores-p é problemático?
Respostas comentadas
Resultados e tamanhos dos grupos permanecem fixos; os rótulos variam e a estatística é recalculada.
Quando diferenças nas duas direções contradizem \(H_0\) e são relevantes para a pergunta definida antes dos dados.
Os rótulos devem ser permutados somente dentro de cada estrato, reproduzindo o mecanismo de atribuição.
A nula estrita exige \(Y_i(1)=Y_i(0)\) para toda unidade; efeito médio zero permite efeitos individuais que se cancelam.
Porque as estatísticas descrevem aspectos diferentes da distribuição e possuem distribuições nulas próprias.
O procedimento finge que indivíduos foram randomizados independentemente, aumenta artificialmente o número de unidades aleatórias e tende a subestimar a incerteza.
A orientação tratamento–controle dentro de cada par; equivalentemente, sorteamos o sinal da diferença de cada par.
Porque transforma uma escolha metodológica em busca pelo resultado mais favorável, em vez de preservar uma estatística definida pela pergunta científica.