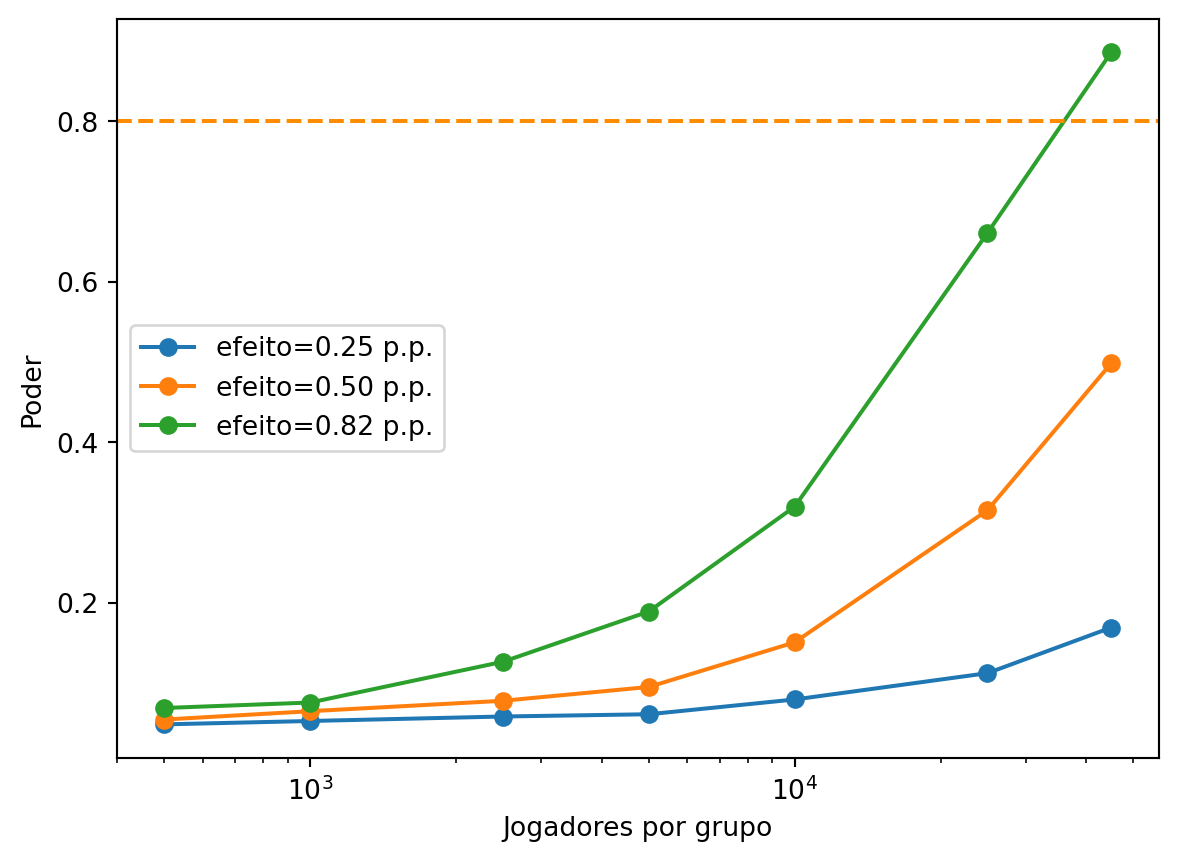
Permutação estratificada, múltiplos testes e poder

Guia de estudo da Aula 15

Objetivos

Este material desenvolve três ideias em uma única sequência:

  1. um teste de permutação deve reproduzir o desenho da atribuição, inclusive os estratos;
  2. testar várias hipóteses aumenta as oportunidades de falsos positivos;
  3. poder é a probabilidade de uma regra construída sob \(H_0\) rejeitar essa hipótese quando uma alternativa específica é verdadeira.

Usaremos a base Cookie Cats como estudo de caso. Para tornar a permutação estratificada transparente, começaremos com uma pequena extensão didática na qual a plataforma do jogador foi registrada antes do tratamento.

Como estudar este capítulo

Em cada seção, identifique quatro elementos: a unidade observacional, a estatística calculada, o mecanismo de simulação e a pergunta respondida. A mesma distribuição simulada não serve automaticamente para qualquer hipótese.

As caixas de interpretação traduzem as saídas para linguagem substantiva. O código permanece aberto para que o material funcione como uma apostila reproduzível.

1. Preparação e download da base

from itertools import combinations
from pathlib import Path

import kagglehub
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
from scipy.stats import gaussian_kde
from statsmodels.stats.multitest import multipletests

sns.set_theme(style="whitegrid", context="notebook")
rng = np.random.default_rng(1414)

path = kagglehub.dataset_download("matinmahmoudi/rounds-and-retention")
csv_path = next(Path(path).rglob("*.csv"))
df = pd.read_csv(csv_path)
df.head()
Downloading to /home/runner/.cache/kagglehub/datasets/matinmahmoudi/rounds-and-retention/1.archive...
Extracting files...
userid version sum_gamerounds retention_1 retention_7
0 116 gate_30 9.0 False False
1 337 gate_30 48.0 True True
2 377 gate_40 2.0 False False
3 483 gate_40 6.0 True False
4 488 gate_40 NaN True True
NotaInterpretação

Cada linha representa um jogador. A coluna version identifica a posição da primeira barreira, enquanto as demais colunas registram engajamento e retenção depois da atribuição.

3. Análise descritiva

summary = df.groupby("version").agg(
    jogadores=("userid", "size"),
    rodadas_média=("sum_gamerounds", "mean"),
    rodadas_mediana=("sum_gamerounds", "median"),
    retenção_1=("retention_1", "mean"),
    retenção_7=("retention_7", "mean"),
)
summary
jogadores rodadas_média rodadas_mediana retenção_1 retenção_7
version
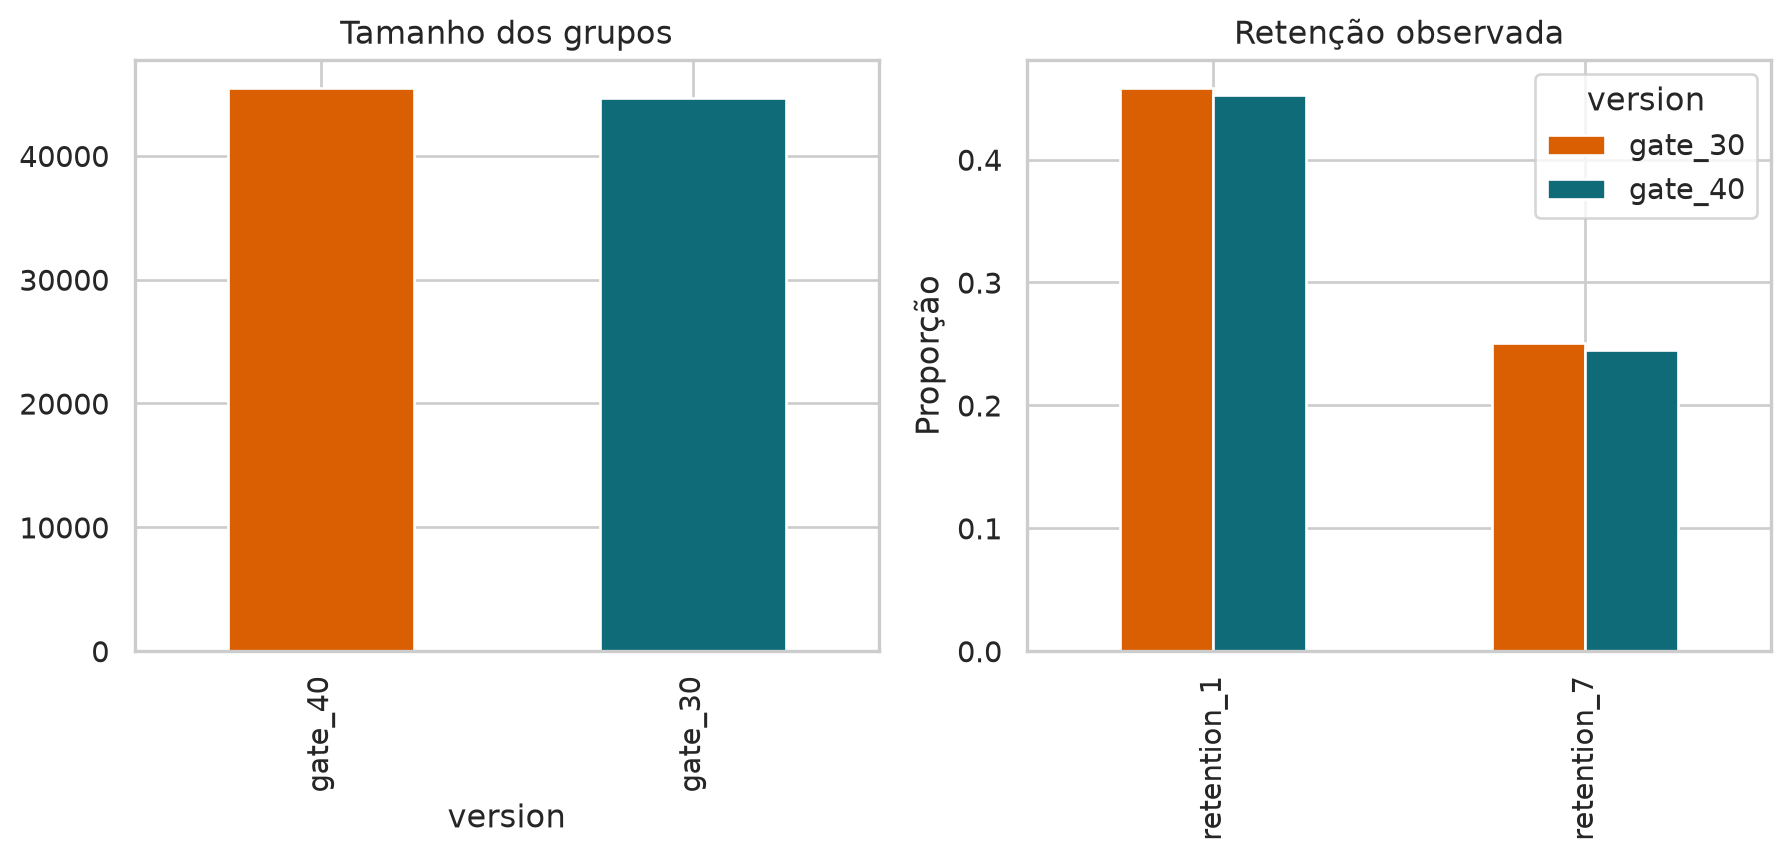
gate_30 44700 54.337280 17.0 0.458367 0.250626
gate_40 45489 54.299748 18.0 0.452417 0.244675
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
df["version"].value_counts().plot.bar(ax=axes[0], color=["#d95f02", "#0f6b78"])
df.groupby("version")[["retention_1", "retention_7"]].mean().T.plot.bar(
    ax=axes[1], color=["#d95f02", "#0f6b78"]
)
axes[0].set_title("Tamanho dos grupos")
axes[1].set_title("Retenção observada")
axes[1].set_ylabel("Proporção")
plt.show()

NotaInterpretação

Os grupos têm tamanhos próximos, como esperamos de uma atribuição aleatória. A porta no nível 30 apresentou retenção ligeiramente maior em 1 e 7 dias. A análise descritiva mostra a direção e o tamanho bruto da diferença, mas ainda não informa quanta variação seria esperada pelo acaso.

4. Métrica primária e efeito

Usaremos retenção em 7 dias como métrica primária. Definimos

\[ \Delta=p_{30}-p_{40}, \]

em que \(p_{30}\) e \(p_{40}\) são as probabilidades de retenção nas duas versões.

y30 = df.loc[df.version.eq("gate_30"), "retention_7"].astype(float).to_numpy()
y40 = df.loc[df.version.eq("gate_40"), "retention_7"].astype(float).to_numpy()

observed = y30.mean() - y40.mean()
print(f"Retenção gate 30: {y30.mean():.2%}")
print(f"Retenção gate 40: {y40.mean():.2%}")
print(f"Diferença observada: {observed:.2%}")
Retenção gate 30: 25.06%
Retenção gate 40: 24.47%
Diferença observada: 0.60%
NotaInterpretação

A estimativa \(\widehat\Delta\) é aproximadamente 0,82 ponto percentual. O sinal positivo favorece a porta no nível 30. Para decidir se essa diferença é compatível com o acaso, precisamos construir uma distribuição sob \(H_0\).

5. Exemplo completo de permutação estratificada

5.1 O desenho estratificado

Imagine que a equipe tenha randomizado separadamente jogadores de Android e iOS. A plataforma é conhecida antes da intervenção e pode estar associada à retenção. Nesse desenho, as versões são trocáveis dentro da plataforma, não entre plataformas.

O pequeno conjunto abaixo foi criado apenas para ensinar o algoritmo. O valor 1 indica retenção em 7 dias.

example = pd.DataFrame({
    "platform": ["Android"] * 10 + ["iOS"] * 10,
    "version": (["gate_30"] * 5 + ["gate_40"] * 5) * 2,
    "retention": [
        1, 1, 1, 1, 0,  1, 0, 0, 0, 0,
        1, 1, 1, 0, 0,  1, 0, 0, 0, 0,
    ],
})
example
platform version retention
0 Android gate_30 1
1 Android gate_30 1
2 Android gate_30 1
3 Android gate_30 1
4 Android gate_30 0
5 Android gate_40 1
6 Android gate_40 0
7 Android gate_40 0
8 Android gate_40 0
9 Android gate_40 0
10 iOS gate_30 1
11 iOS gate_30 1
12 iOS gate_30 1
13 iOS gate_30 0
14 iOS gate_30 0
15 iOS gate_40 1
16 iOS gate_40 0
17 iOS gate_40 0
18 iOS gate_40 0
19 iOS gate_40 0
AvisoEstratos devem ser pré-tratamento

Plataforma, região e medidas históricas podem formar estratos quando existem antes da intervenção. sum_gamerounds, retention_1 e retention_7 são resultados posteriores à atribuição e não devem ser usados como estratos deste experimento.

5.2 A estatística estratificada

Dentro de cada estrato \(s\), calculamos

\[ \widehat\Delta_s=\bar Y_{30,s}-\bar Y_{40,s}. \]

Depois combinamos os efeitos com pesos proporcionais ao tamanho dos estratos:

\[ T=\sum_s w_s\widehat\Delta_s, \qquad w_s=\frac{n_s}{\sum_r n_r}. \]

O índice \(r\) apenas percorre todos os estratos no denominador. Assim, os pesos somam 1.

def stratified_statistic(data, label="version"):
    rates = data.groupby(["platform", label])["retention"].mean().unstack()
    differences = rates["gate_30"] - rates["gate_40"]
    sizes = data.groupby("platform").size()
    weights = sizes / sizes.sum()
    return float((weights * differences).sum()), rates, differences, weights

t_observed, rates, differences, weights = stratified_statistic(example)
display(rates)
display(pd.DataFrame({"diferença": differences, "peso": weights}))
print(f"Estatística observada: {t_observed:.2f}")
version gate_30 gate_40
platform
Android 0.8 0.2
iOS 0.6 0.2
diferença peso
platform
Android 0.6 0.5
iOS 0.4 0.5
Estatística observada: 0.50
NotaInterpretação

Android produz uma diferença de 0,60 e iOS uma diferença de 0,40. Como os estratos têm o mesmo tamanho, cada um recebe peso 0,5. A estatística observada é \(T_{obs}=0{,}50\).

5.3 Uma permutação dentro dos estratos

Mantemos os resultados fixos e trocamos os rótulos gate_30 e gate_40 separadamente em Android e iOS.

one_permutation = example.copy()
one_permutation["version_perm"] = (
    one_permutation.groupby("platform")["version"]
    .transform(lambda labels: rng.permutation(labels.to_numpy()))
)

t_permuted, rates_permuted, _, _ = stratified_statistic(
    one_permutation, label="version_perm"
)
display(rates_permuted)
print(f"Estatística nesta permutação: {t_permuted:.2f}")
version_perm gate_30 gate_40
platform
Android 0.4 0.6
iOS 0.4 0.4
Estatística nesta permutação: -0.10
NotaInterpretação

Uma permutação é um experimento possível sob a hipótese nula. Ela preserva cinco jogadores em cada versão dentro de cada plataforma. Repetir esse processo mostra quais valores de \(T\) surgem apenas pela atribuição aleatória.

5.4 Todas as permutações possíveis

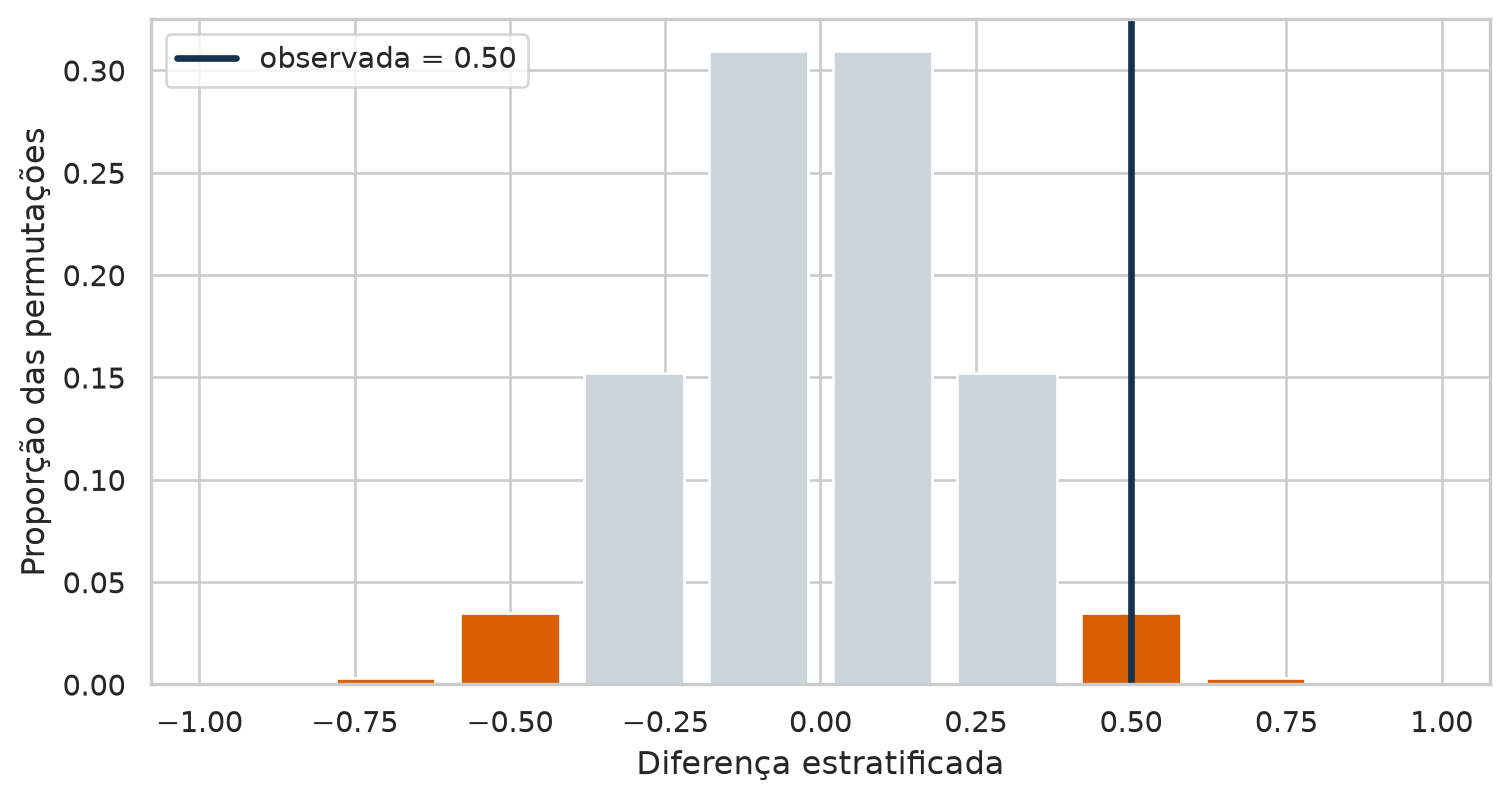
Em cada plataforma existem \(\binom{10}{5}=252\) maneiras de escolher os cinco jogadores do gate_30. Para as duas plataformas, existem \(252^2=63.504\) atribuições compatíveis com o desenho.

strata = {
    platform: group["retention"].to_numpy()
    for platform, group in example.groupby("platform", sort=False)
}
assignments = list(combinations(range(10), 5))
null_stratified = []

for android_gate30 in assignments:
    mask_a = np.zeros(10, dtype=bool)
    mask_a[list(android_gate30)] = True
    delta_a = strata["Android"][mask_a].mean() - strata["Android"][~mask_a].mean()

    for ios_gate30 in assignments:
        mask_i = np.zeros(10, dtype=bool)
        mask_i[list(ios_gate30)] = True
        delta_i = strata["iOS"][mask_i].mean() - strata["iOS"][~mask_i].mean()
        null_stratified.append(0.5 * delta_a + 0.5 * delta_i)

null_stratified = np.asarray(null_stratified)
p_stratified = np.mean(
    np.abs(null_stratified) >= abs(t_observed) - 1e-12
)
print("Número de atribuições:", len(null_stratified))
print(f"Valor-p bilateral exato: {p_stratified:.4f}")
Número de atribuições: 63504
Valor-p bilateral exato: 0.0767
values, counts = np.unique(np.round(null_stratified, 10), return_counts=True)
tail = np.abs(values) >= abs(t_observed) - 1e-12

plt.figure(figsize=(9, 4.5))
plt.bar(values, counts / counts.sum(), width=.16,
        color=np.where(tail, "#d95f02", "#cbd5da"))
plt.axvline(t_observed, color="#17324d", linewidth=2.5,
            label=f"observada = {t_observed:.2f}")
plt.xlabel("Diferença estratificada")
plt.ylabel("Proporção das permutações")
plt.legend()
plt.show()

NotaInterpretação

O valor-p é aproximadamente 0,077. Mesmo uma diferença observada de 0,50 pode ocorrer com frequência não desprezível porque o exemplo contém apenas 20 jogadores. No nível de 5%, não rejeitamos \(H_0\). Isso não prova ausência de efeito; a amostra oferece evidência insuficiente.

5.5 Algoritmo geral

Com muitas observações, enumerar todas as atribuições pode ser inviável. Usamos então \(B\) permutações aleatórias:

\[ \widehat p= \frac{1+\sum_{b=1}^{B}I(|T^{(b)}|\geq|T_{obs}|)}{B+1}. \]

Aqui, \(B\) é o número de permutações, \(T^{(b)}\) é a estatística na réplica \(b\) e \(I(\cdot)\) vale 1 quando a condição é verdadeira.

def stratified_permutation_test(data, reps=10_000, seed=1414):
    local_rng = np.random.default_rng(seed)
    observed_stat, _, _, _ = stratified_statistic(data)
    null = np.empty(reps)

    for b in range(reps):
        permuted = data.copy()
        permuted["version_perm"] = (
            permuted.groupby("platform")["version"]
            .transform(lambda labels: local_rng.permutation(labels.to_numpy()))
        )
        null[b], _, _, _ = stratified_statistic(
            permuted, label="version_perm"
        )

    p_value = (1 + np.sum(np.abs(null) >= abs(observed_stat))) / (reps + 1)
    return observed_stat, null, p_value

t_mc, null_mc, p_mc = stratified_permutation_test(example, reps=5_000)
print(f"Estatística: {t_mc:.2f}")
print(f"Valor-p Monte Carlo: {p_mc:.4f}")
Estatística: 0.50
Valor-p Monte Carlo: 0.0780
NotaInterpretação

O valor-p Monte Carlo fica próximo do valor exato. A pequena diferença muda com a semente e diminui quando aumentamos \(B\). O ponto essencial é manter as trocas dentro dos estratos definidos pelo desenho.

6. Múltiplos testes

6.1 Por que o problema aparece?

Cookie Cats permite testar retenção em 1 dia, retenção em 7 dias e rodadas. Também poderíamos criar subgrupos e janelas adicionais. Se cada teste usa 5% isoladamente, a chance de algum falso positivo cresce com o número de oportunidades.

Sob independência e com todas as hipóteses nulas verdadeiras:

\[ P(\text{ao menos um falso positivo})=1-(1-\alpha)^m. \]

for m in [1, 3, 10, 100]:
    probability = 1 - (1 - .05) ** m
    print(f"{m:3d} testes: {probability:.1%}")
  1 testes: 5.0%
  3 testes: 14.3%
 10 testes: 40.1%
100 testes: 99.4%
m = np.arange(1, 101)
fwer = 1 - (1 - .05) ** m
plt.figure(figsize=(8, 4))
plt.plot(m, fwer, color="#0f6b78", linewidth=3)
plt.xlabel("Número de testes independentes")
plt.ylabel("P(ao menos um falso positivo)")
plt.show()

NotaInterpretação

Com três testes, a chance de ao menos um falso positivo já é aproximadamente 14,3%. Com dez, chega a 40,1%. A expressão supõe independência, mas a necessidade de pensar na família continua quando os testes são dependentes.

6.2 FWER e FDR

Considere \(R\) rejeições e \(V\) falsos positivos entre elas.

FWER vem de family-wise error rate (taxa de erro familiar) e controla a chance de qualquer falso positivo:

\[ \operatorname{FWER}=P(V\geq1). \]

FDR vem de false discovery rate (taxa de falsas descobertas) e controla a fração falsa esperada entre as descobertas:

\[ \operatorname{FDR}=E\left[\frac{V}{\max(R,1)}\right]. \]

Não observamos \(V\) diretamente. Os procedimentos controlam o comportamento dos erros quando o processo completo é repetido.

NotaInterpretação

FWER é uma meta rigorosa para poucas decisões confirmatórias. FDR é natural quando buscamos muitas descobertas e aceitamos algumas falsas em troca de maior capacidade de descoberta. Controlar FDR em 5% não significa que cada resultado tenha 5% de chance de ser falso.

6.3 Bonferroni

Bonferroni divide o orçamento de erro familiar entre os \(m\) testes:

\[ \alpha^*=\frac{\alpha}{m}. \]

Rejeitamos \(H_i\) quando \(p_i\leq\alpha/m\). O valor-p ajustado é \(p_i^{adj}=\min(mp_i,1)\).

A regra controla FWER mesmo quando os testes são dependentes. O custo é um limiar rígido, que pode reduzir poder.

Para os valores-p ordenados \(0{,}003\), \(0{,}011\), \(0{,}018\), \(0{,}041\) e \(0{,}200\), com \(m=5\) e \(\alpha=0{,}05\):

\[ \alpha^*=\frac{0{,}05}{5}=0{,}01. \]

Somente \(0{,}003\leq0{,}01\). Bonferroni rejeita apenas \(H_{(1)}\).

6.4 Holm

Holm também controla FWER, mas aplica Bonferroni sequencialmente. Depois de ordenar \(p_{(1)}\leq\cdots\leq p_{(m)}\), compara

\[ p_{(i)}\leq\frac{\alpha}{m-i+1}. \]

Começamos com \(\alpha/m\). A cada rejeição, restam menos hipóteses e o limiar aumenta. O procedimento para no primeiro fracasso. Para a mesma família, Holm nunca rejeita menos hipóteses que Bonferroni.

No mesmo exemplo, as comparações são:

\(i\) \(p_{(i)}\) \(\alpha/(m-i+1)\) decisão
1 0,003 \(0{,}05/5=0{,}0100\) rejeita e continua
2 0,011 \(0{,}05/4=0{,}0125\) rejeita e continua
3 0,018 \(0{,}05/3\approx0{,}0167\) não rejeita e para

Holm rejeita \(H_{(1)}\) e \(H_{(2)}\). Como o procedimento para no primeiro fracasso, as hipóteses das posições 3 a 5 não são rejeitadas.

6.5 Benjamini–Hochberg

Benjamini–Hochberg (BH) controla FDR. Ele ordena os valores-p, calcula \((i/m)q\) e encontra o maior índice \(k\) que satisfaz

\[ p_{(k)}\leq\frac{k}{m}q. \]

Nessa expressão:

  • \(p_{(i)}\) é o \(i\)-ésimo menor valor-p;
  • \(i\) é a posição do valor-p na lista ordenada, com \(i=1,\ldots,m\);
  • \(m\) é o número total de hipóteses testadas;
  • \(q\) é o nível escolhido para controlar a FDR, por exemplo \(q=0{,}05\);
  • \(k\) é o maior índice para o qual \(p_{(k)}\leq(k/m)q\).

As hipóteses das posições 1 a \(k\) são rejeitadas. BH procura o maior índice válido; ele não para no primeiro fracasso. Controlar FDR em \(q=0{,}05\) não significa que cada descoberta tenha 5% de probabilidade de ser falsa. A meta se refere à proporção esperada de falsos positivos entre as descobertas quando o procedimento é repetido.

No mesmo exemplo, com \(m=5\) e \(q=0{,}05\):

\(i\) \(p_{(i)}\) \((i/m)q\) satisfaz \(p_{(i)}\leq(i/m)q\)?
1 0,003 0,010 sim
2 0,011 0,020 sim
3 0,018 0,030 sim
4 0,041 0,040 não
5 0,200 0,050 não

O maior índice aprovado é \(k=3\). BH rejeita as hipóteses \(H_{(1)}\), \(H_{(2)}\) e \(H_{(3)}\).

6.6 Um exemplo comparativo

p_values = np.array([.003, .011, .018, .041, .200])
comparison = pd.DataFrame({"p": p_values})

for label, method in [
    ("Bonferroni", "bonferroni"),
    ("Holm", "holm"),
    ("BH", "fdr_bh"),
]:
    reject, adjusted, _, _ = multipletests(
        p_values, alpha=.05, method=method
    )
    comparison[f"p ajustado — {label}"] = adjusted
    comparison[f"rejeita — {label}"] = reject

comparison.round(4)
p p ajustado — Bonferroni rejeita — Bonferroni p ajustado — Holm rejeita — Holm p ajustado — BH rejeita — BH
0 0.003 0.015 True 0.015 True 0.0150 True
1 0.011 0.055 False 0.044 True 0.0275 True
2 0.018 0.090 False 0.054 False 0.0300 True
3 0.041 0.205 False 0.082 False 0.0512 False
4 0.200 1.000 False 0.200 False 0.2000 False
NotaInterpretação

Bonferroni rejeita apenas a primeira hipótese. Holm rejeita as duas primeiras com a mesma meta de FWER. BH rejeita as três primeiras porque controla uma quantidade diferente, a FDR. Mais rejeições não tornam automaticamente um procedimento melhor; a escolha depende do custo científico dos erros.

6.7 Escolha prática

Situação Procedimento sugerido
poucas decisões confirmatórias, uma falsa conclusão tem custo alto Holm; Bonferroni como regra simples
muitas hipóteses exploratórias ou triagem Benjamini–Hochberg
uma decisão principal previamente definida teste da métrica primária; demais análises identificadas como secundárias

Defina a família pela pergunta científica, não pelo arquivo ou pela conveniência da análise.

7. Poder com permutação sob \(H_0\) e bootstrap sob \(H_A\)

7.1 Definição

Para uma alternativa específica \(\Delta^*\):

\[ \operatorname{Poder}(\Delta^*) =P(\text{rejeitar }H_0\mid\Delta=\Delta^*). \]

Não existe “o poder do teste” sem definir efeito, amostra, variabilidade, nível de significância e regra de decisão.

Usaremos como cenário didático o efeito observado de 0,82 ponto percentual. Isso não prova que esse seja o efeito verdadeiro; apenas define o mundo alternativo da simulação.

7.2 Distribuição sob \(H_0\) por permutação

Para uma resposta binária, podemos executar a permutação eficientemente. Mantemos fixos o total de jogadores retidos e os tamanhos dos grupos. O número de sucessos alocado ao primeiro grupo segue uma distribuição hipergeométrica.

n30, n40 = len(y30), len(y40)
successes = int(y30.sum() + y40.sum())
B_null = 100_000

successes_30 = rng.hypergeometric(
    successes,
    n30 + n40 - successes,
    n30,
    size=B_null,
)

null_perm = (
    successes_30 / n30
    - (successes - successes_30) / n40
)

critical = np.quantile(np.abs(null_perm), .95)
p_perm = (1 + np.sum(np.abs(null_perm) >= abs(observed))) / (B_null + 1)

print(f"Limite crítico bilateral: ±{critical:.3%}")
print(f"Valor-p por permutação: {p_perm:.5f}")
Limite crítico bilateral: ±0.564%
Valor-p por permutação: 0.03845
NotaInterpretação

O limite crítico é aproximadamente 0,51 ponto percentual. Uma nova diferença será considerada incompatível com \(H_0\) quando seu valor absoluto ultrapassar esse limite. O valor-p do experimento observado é próximo de 0,002.

7.3 Distribuição sob \(H_A\) por bootstrap

O bootstrap reamostra jogadores separadamente em cada versão. Assim, preserva as duas taxas observadas e produz experimentos centrados perto de \(\widehat\Delta=0{,}82\) ponto percentual.

def bootstrap_difference(a, b, reps=3_000, seed=2026):
    local_rng = np.random.default_rng(seed)
    result = np.empty(reps)
    for index in range(reps):
        mean_a = local_rng.choice(a, size=len(a), replace=True).mean()
        mean_b = local_rng.choice(b, size=len(b), replace=True).mean()
        result[index] = mean_a - mean_b
    return result

boot_alt = bootstrap_difference(y30, y40)
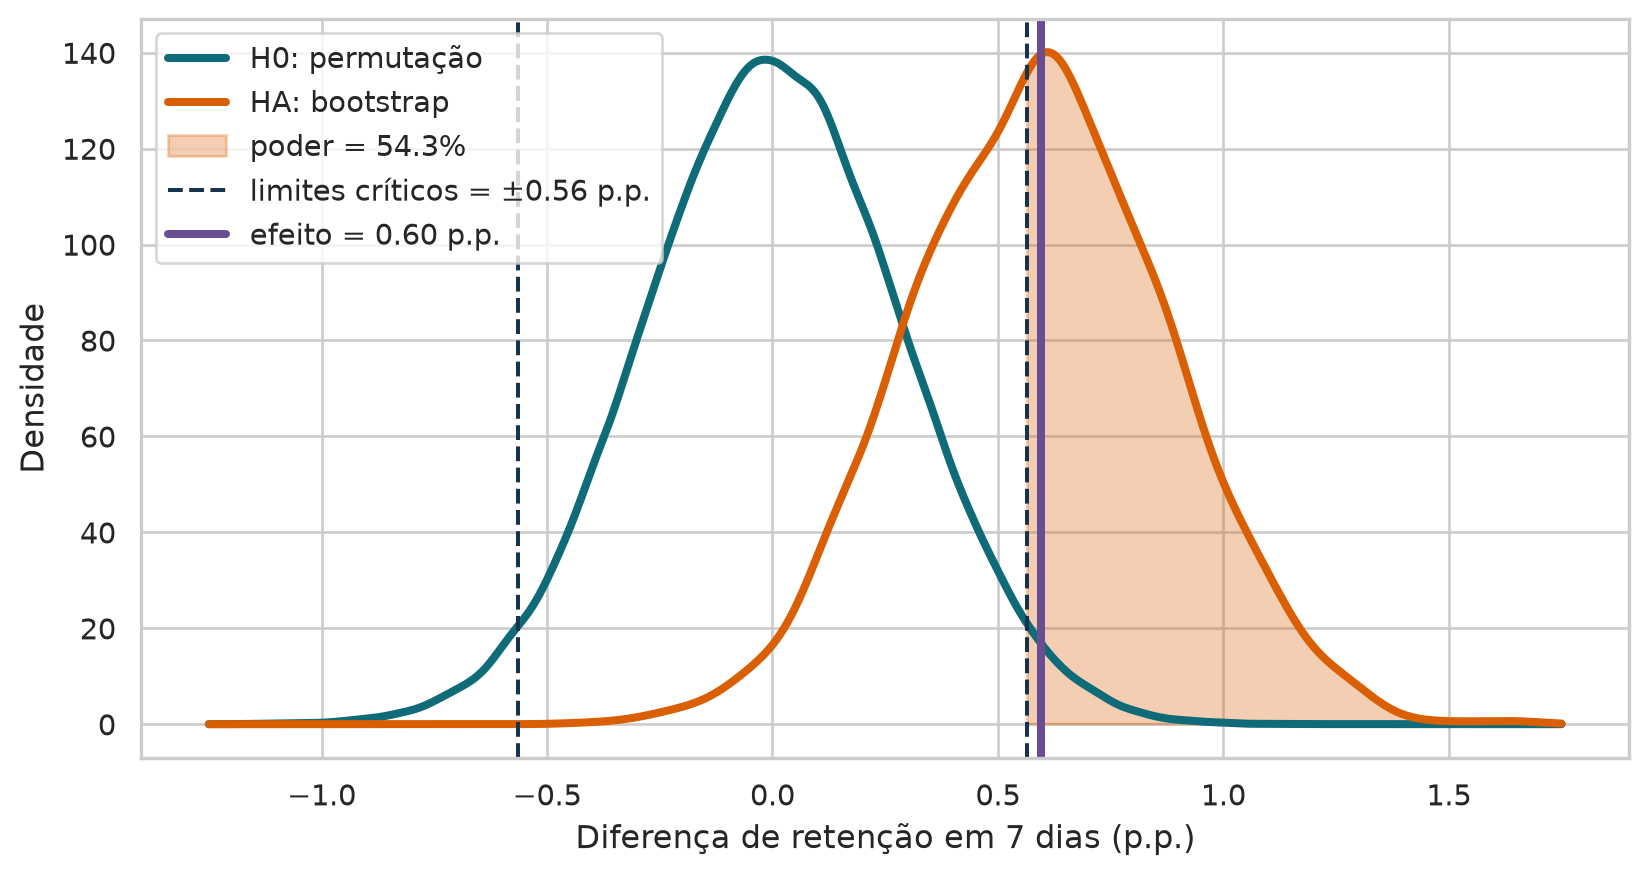
power = np.mean(np.abs(boot_alt) >= critical)

print(f"Centro da alternativa: {boot_alt.mean():.3%}")
print(f"Poder estimado: {power:.1%}")
Centro da alternativa: 0.590%
Poder estimado: 54.3%
NotaInterpretação

Cada réplica bootstrap é um novo experimento possível sob a alternativa empírica. Aplicamos a mesma regra crítica construída sob \(H_0\). A fração de réplicas que cruza o limite estima o poder para esse cenário.

7.4 As duas distribuições no mesmo gráfico

grid = np.linspace(-.0125, .0175, 700)
null_density = gaussian_kde(null_perm)(grid)
alt_density = gaussian_kde(boot_alt)(grid)
rejection = np.abs(grid) >= critical

plt.figure(figsize=(10, 5))
plt.plot(100 * grid, null_density, color="#0f6b78", linewidth=3,
         label="H0: permutação")
plt.plot(100 * grid, alt_density, color="#d95f02", linewidth=3,
         label="HA: bootstrap")
plt.fill_between(
    100 * grid, 0, alt_density,
    where=rejection,
    color="#d95f02", alpha=.30,
    label=f"poder = {power:.1%}",
)
plt.axvline(-100 * critical, color="#17324d", linestyle="--")
plt.axvline(100 * critical, color="#17324d", linestyle="--",
            label=f"limites críticos = ±{100 * critical:.2f} p.p.")
plt.axvline(100 * observed, color="#6a4c93", linewidth=3,
            label=f"efeito = {100 * observed:.2f} p.p.")
plt.xlabel("Diferença de retenção em 7 dias (p.p.)")
plt.ylabel("Densidade")
plt.legend()
plt.show()

NotaInterpretação

A curva azul representa diferenças possíveis sem efeito. A curva laranja representa diferenças quando o efeito escolhido é verdadeiro. As linhas tracejadas definem a região de rejeição e a linha roxa marca o efeito usado em \(H_A\). A área laranja sombreada é o poder: experimentos sob a alternativa que rejeitariam \(H_0\).

7.5 O que muda o poder?

  • Amostra maior: concentra as distribuições e reduz o erro padrão.
  • Efeito maior: afasta \(H_A\) de \(H_0\).
  • Menor variabilidade: torna o efeito mais fácil de distinguir do ruído.
  • Nível de significância menor: protege mais contra falsos positivos, mas amplia a região de não rejeição e pode reduzir poder.

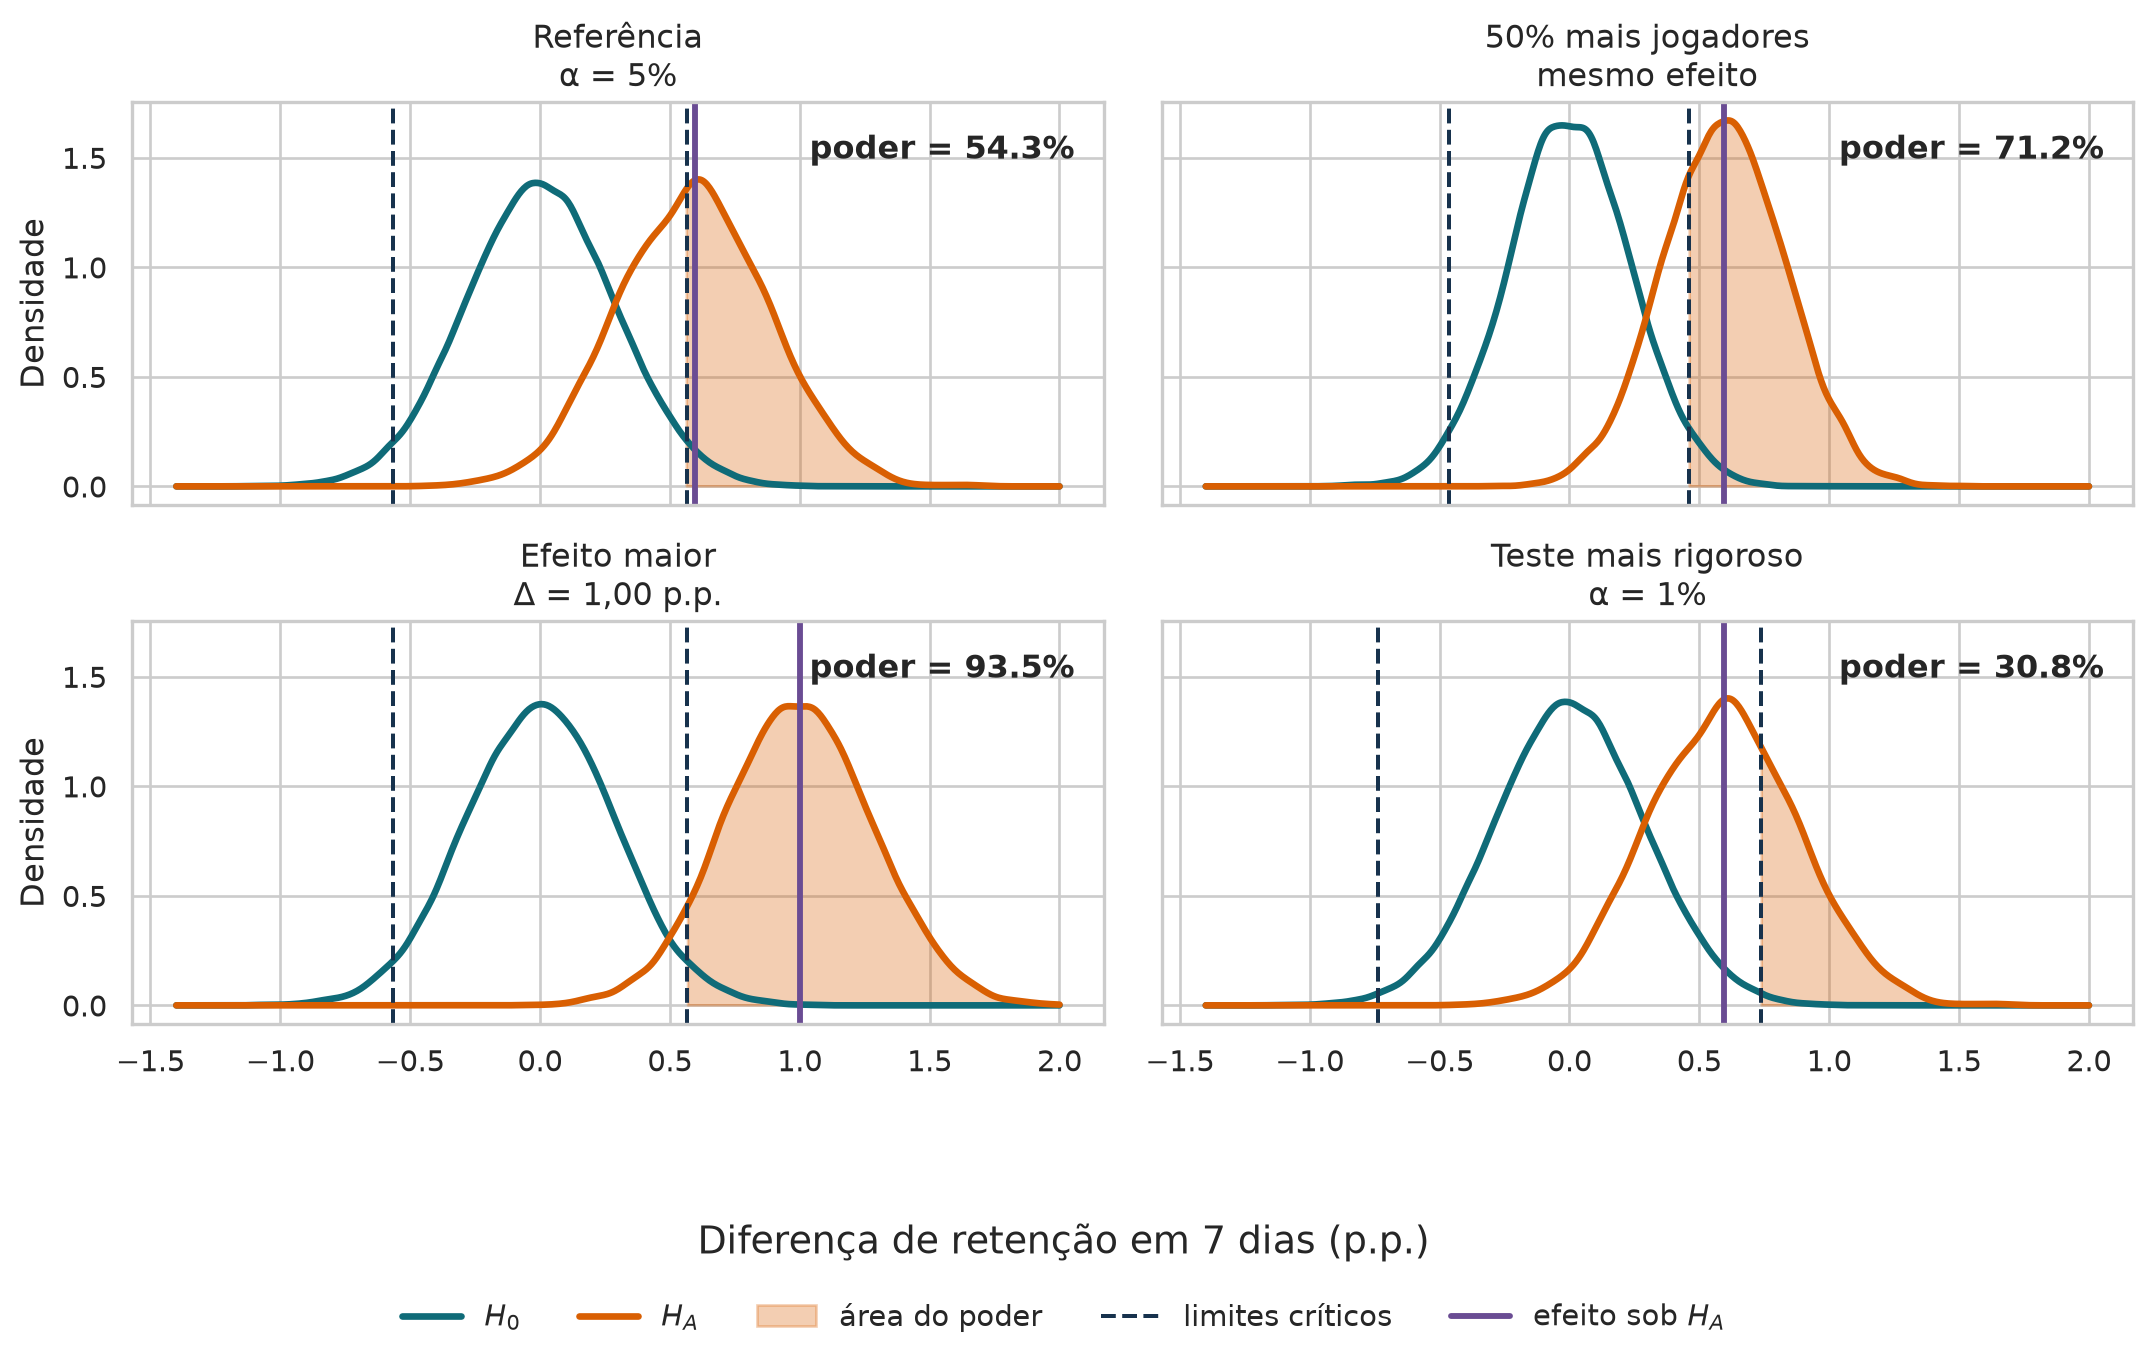
O gráfico seguinte mantém a mesma escala nos quatro painéis e altera apenas um componente de cada vez. O cenário de referência usa as distribuições construídas anteriormente. Depois, aumentamos a amostra em 50%, aumentamos o efeito para 1,00 ponto percentual e reduzimos \(\alpha\) para 1%.

power_rng = np.random.default_rng(1515)
power_reps = 20_000
pooled_rate = (y30.sum() + y40.sum()) / (n30 + n40)

def simulate_binomial_difference(n_a, n_b, p_a, p_b):
    return (
        power_rng.binomial(n_a, p_a, power_reps) / n_a
        - power_rng.binomial(n_b, p_b, power_reps) / n_b
    )

# 50% mais jogadores em cada grupo, mantendo as taxas observadas.
large_n30 = round(1.5 * n30)
large_n40 = round(1.5 * n40)
large_null = simulate_binomial_difference(
    large_n30, large_n40, pooled_rate, pooled_rate
)
large_alt = simulate_binomial_difference(
    large_n30, large_n40, y30.mean(), y40.mean()
)
large_critical = np.quantile(np.abs(large_null), .95)

# Efeito de 1,00 p.p., mantendo o tamanho da amostra.
larger_effect = .010
effect_null = simulate_binomial_difference(
    n30, n40, pooled_rate, pooled_rate
)
effect_alt = simulate_binomial_difference(
    n30, n40, y40.mean() + larger_effect, y40.mean()
)
effect_critical = np.quantile(np.abs(effect_null), .95)

# Teste bilateral com alfa de 1%.
strict_critical = np.quantile(np.abs(null_perm), .99)

scenarios = [
    (null_perm, boot_alt, critical, observed,
     "Referência\nα = 5%"),
    (large_null, large_alt, large_critical, observed,
     "50% mais jogadores\nmesmo efeito"),
    (effect_null, effect_alt, effect_critical, larger_effect,
     "Efeito maior\nΔ = 1,00 p.p."),
    (null_perm, boot_alt, strict_critical, observed,
     "Teste mais rigoroso\nα = 1%"),
]

comparison_grid = np.linspace(-1.4, 2.0, 700)
fig, axes = plt.subplots(
    2, 2, figsize=(11.5, 7.2), sharex=True, sharey=True
)

for index, (ax, scenario) in enumerate(zip(axes.flat, scenarios)):
    null_values, alt_values, cutoff, effect, title = scenario
    null_curve = gaussian_kde(100 * null_values)(comparison_grid)
    alt_curve = gaussian_kde(100 * alt_values)(comparison_grid)
    rejection = np.abs(comparison_grid) >= 100 * cutoff
    scenario_power = np.mean(np.abs(alt_values) >= cutoff)

    ax.plot(comparison_grid, null_curve, color="#0f6b78",
            linewidth=2.5, label="$H_0$")
    ax.plot(comparison_grid, alt_curve, color="#d95f02",
            linewidth=2.5, label="$H_A$")
    ax.fill_between(
        comparison_grid, 0, alt_curve,
        where=rejection, color="#d95f02", alpha=.30,
        label="área do poder",
    )
    ax.axvline(-100 * cutoff, color="#17324d", linestyle="--",
               label="limites críticos")
    ax.axvline(100 * cutoff, color="#17324d", linestyle="--")
    ax.axvline(100 * effect, color="#6a4c93", linewidth=2.2,
               label="efeito sob $H_A$")
    ax.set_title(title)
    ax.text(.97, .92, f"poder = {scenario_power:.1%}",
            transform=ax.transAxes, ha="right", va="top",
            fontweight="bold")
    if index % 2 == 0:
        ax.set_ylabel("Densidade")

handles, labels = axes.flat[0].get_legend_handles_labels()
fig.supxlabel("Diferença de retenção em 7 dias (p.p.)", y=.075)
fig.legend(handles, labels, loc="lower center", ncol=5,
           frameon=False, bbox_to_anchor=(.5, .005))
fig.tight_layout(rect=(0, .13, 1, 1))
plt.show()
NotaInterpretação

Com 50% mais jogadores, as duas distribuições ficam mais estreitas e o poder sobe de aproximadamente 88% para 97%. Um efeito de 1,00 ponto percentual desloca \(H_A\) para mais longe de \(H_0\) e produz aumento semelhante. Quando \(\alpha\) cai de 5% para 1%, os limites críticos se afastam de zero. O teste passa a exigir evidência mais extrema e o poder cai para aproximadamente 70%.

No planejamento, use o menor efeito que mudaria a decisão. Usar apenas o efeito observado pode produzir uma avaliação otimista, principalmente quando o estudo original é pequeno.

8. Aprofundamento: bootstrap também pode representar \(H_0\)

O fluxo principal usou permutação sob \(H_0\) porque ela reproduz diretamente a atribuição aleatória. Bootstrap também pode representar a nula, desde que imponhamos \(H_0\) antes da reamostragem.

Para dados contínuos, uma recentralização comum é

\[ Y^0_{ij}=Y_{ij}-\bar Y_j+\bar Y_{pool}. \]

O termo \(Y_{ij}\) é a observação \(i\) do grupo \(j\), \(\bar Y_j\) é a média do grupo e \(\bar Y_{pool}\) é a média combinada. Subtraímos a média própria e adicionamos a média comum, fazendo com que os grupos tenham o mesmo centro.

Para Bernoulli, podemos impor uma proporção combinada comum. Sem esse passo, o bootstrap separado por grupo preserva o efeito observado e representa naturalmente \(H_A\).

NotaInterpretação

Permutação sob \(H_0\) e bootstrap sob \(H_A\) formam uma narrativa simples para estudar poder. O bootstrap recentralizado é uma alternativa útil, mas não precisa ser introduzido antes de dominar esse fluxo principal.

9. Exercícios

  1. Recalcule o teste estratificado usando apenas 2.000 permutações aleatórias e compare com o valor-p exato.
  2. Troque os pesos proporcionais por pesos iguais em um exemplo com estratos de tamanhos diferentes. Explique a mudança de interpretação.
  3. Aplique Bonferroni, Holm e BH aos valores-p [0.001, 0.008, 0.014, 0.032, 0.18].
  4. Recalcule o poder usando como alternativa 0,50 ponto percentual.
  5. Aumente ou reduza os tamanhos dos grupos e observe como as distribuições mudam.
  6. Explique por que retention_1 não deve ser usada como estrato para testar retention_7 neste experimento.

10. Síntese

  • A permutação estratificada troca rótulos apenas dentro dos grupos em que a atribuição ocorreu.
  • Bonferroni e Holm controlam FWER; BH controla FDR.
  • Definir uma métrica primária reduz a multiplicidade confirmatória.
  • Poder compara uma regra de rejeição construída sob \(H_0\) com experimentos simulados sob uma alternativa específica.
  • No exemplo Cookie Cats, a permutação fornece o limite crítico e o bootstrap fornece a distribuição sob \(H_A\).

Fonte e limitações

Base Cookie Cats, versão matinmahmoudi/rounds-and-retention no Kaggle, licença Apache 2.0. O conjunto é uma republicação educacional e não apresenta todos os detalhes operacionais do experimento original.

A variável de plataforma usada no exemplo estratificado é didática e não pertence à base pública. Ela representa uma covariável pré-tratamento que poderia ter sido usada no desenho da randomização. As conclusões sobre o produto devem ser tratadas como estudo de caso, não como recomendação atual.

Questões de revisão

  1. Por que uma permutação estratificada deve manter as trocas dentro de cada estrato?
  2. Qual a diferença entre as metas de FWER e FDR?
  3. Como a permutação e o bootstrap participam da estimativa de poder apresentada nesta aula?
Respostas comentadas
  1. Porque a distribuição nula deve reproduzir as atribuições permitidas pelo desenho. Misturar estratos cria experimentos que não poderiam ter ocorrido.
  2. FWER controla a chance de pelo menos um falso positivo na família. FDR controla a fração falsa esperada entre as descobertas.
  3. A permutação constrói \(H_0\) e determina o limite crítico. O bootstrap separado por grupo representa \(H_A\). O poder é a proporção das réplicas sob \(H_A\) que ultrapassa o limite.