Este material usa a base Medical Insurance Cost para estudar associação entre variáveis quantitativas. Ao final, você deve conseguir:
calcular e interpretar covariância e correlação de Pearson;
explicar por que Pearson está entre \(-1\) e \(1\);
comparar Pearson e Spearman;
reconhecer não linearidade, pontos influentes e restrição de amplitude;
distinguir correlação marginal e condicional;
quantificar a incerteza de uma correlação amostral.
Como estudar este capítulo
O fio condutor é uma pergunta simples: quando duas variáveis mudam juntas, como podemos descrever esse padrão sem confundir associação com causalidade? Começaremos pelo gráfico de dispersão, porque um único coeficiente nunca conta toda a história. Em seguida, construiremos covariância, Pearson e Spearman a partir daquilo que se observa no gráfico.
Leia cada bloco nesta ordem: primeiro identifique a pergunta, depois examine a figura ou a tabela, tente antecipar o resultado e somente então abra o código. O código registra como a análise foi produzida; a interpretação explica o que ela permite concluir. Ao final, você deve conseguir escolher uma medida de associação, reconhecer situações em que ela engana e redigir uma conclusão compatível com os dados.
1. Obtenção e preparação da base
A base está disponível no Kaggle sob licença CC0. Cada linha representa uma pessoa segurada. Para tornar o material reproduzível também sem rede, o repositório contém uma cópia local do arquivo usado na aula.
from pathlib import Pathimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport seaborn as snsfrom scipy.stats import pearsonr, spearmanrlocal_file = Path("data/insurance.csv")if local_file.exists(): csv_path = local_fileelse:import kagglehub path = kagglehub.dataset_download("mosapabdelghany/medical-insurance-cost-dataset" ) csv_path =next(Path(path).rglob("*.csv"))df = pd.read_csv(csv_path)df.head()
age
sex
bmi
children
smoker
region
charges
0
19
female
27.900
0
yes
southwest
16884.92400
1
18
male
33.770
1
no
southeast
1725.55230
2
28
male
33.000
3
no
southeast
4449.46200
3
33
male
22.705
0
no
northwest
21984.47061
4
32
male
28.880
0
no
northwest
3866.85520
NotaInterpretação
As primeiras linhas confirmam a granularidade: uma pessoa por registro. charges é uma despesa observada, não um preço causalmente determinado apenas pelas demais colunas.
2. O que é a base?
As principais colunas são:
coluna
tipo
significado
age
numérica discreta
idade em anos
sex
categórica nominal
sexo registrado
bmi
numérica contínua
índice de massa corporal em kg/m²
children
numérica discreta
dependentes cobertos
smoker
categórica nominal
tabagismo
region
categórica nominal
região dos Estados Unidos
charges
numérica contínua
despesas médicas cobradas em US$
print("Dimensão:", df.shape)print("Ausências por coluna:")print(df.isna().sum())print("Linhas duplicadas:", df.duplicated().sum())
Dimensão: (1338, 7)
Ausências por coluna:
age         0
sex         0
bmi         0
children    0
smoker      0
region      0
charges     0
dtype: int64
Linhas duplicadas: 1
NotaInterpretação
Não há ausências, mas existe uma linha duplicada exata. Como não há identificador individual, não é possível concluir se ela é erro ou duas pessoas com os mesmos atributos. Mantê-la tem impacto desprezível; removê-la exigiria documentar essa decisão.
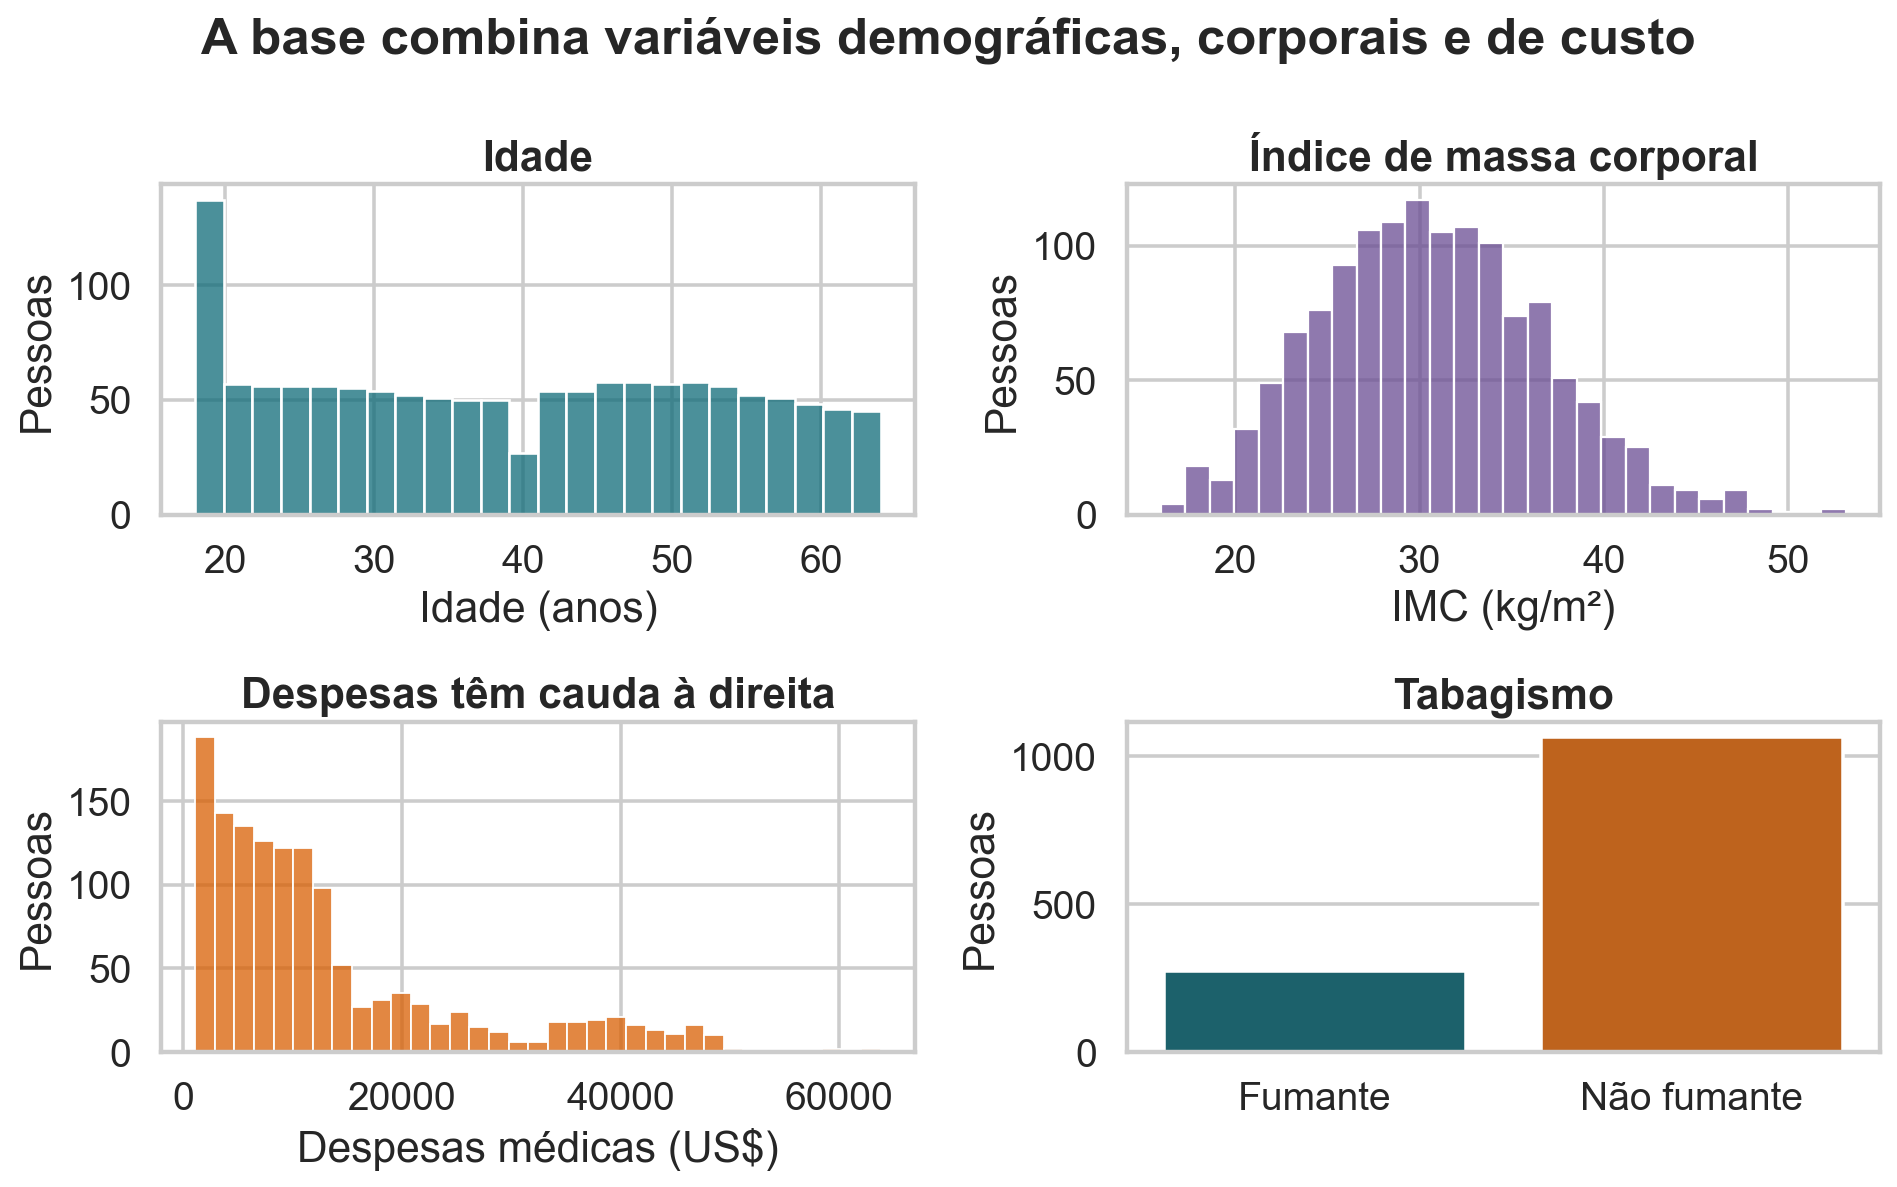
As despesas apresentam forte assimetria à direita e diferem substancialmente entre fumantes e não fumantes. Isso antecipa duas precauções: Pearson pode ser sensível aos maiores valores e uma correlação global pode misturar grupos com níveis e relações distintos.
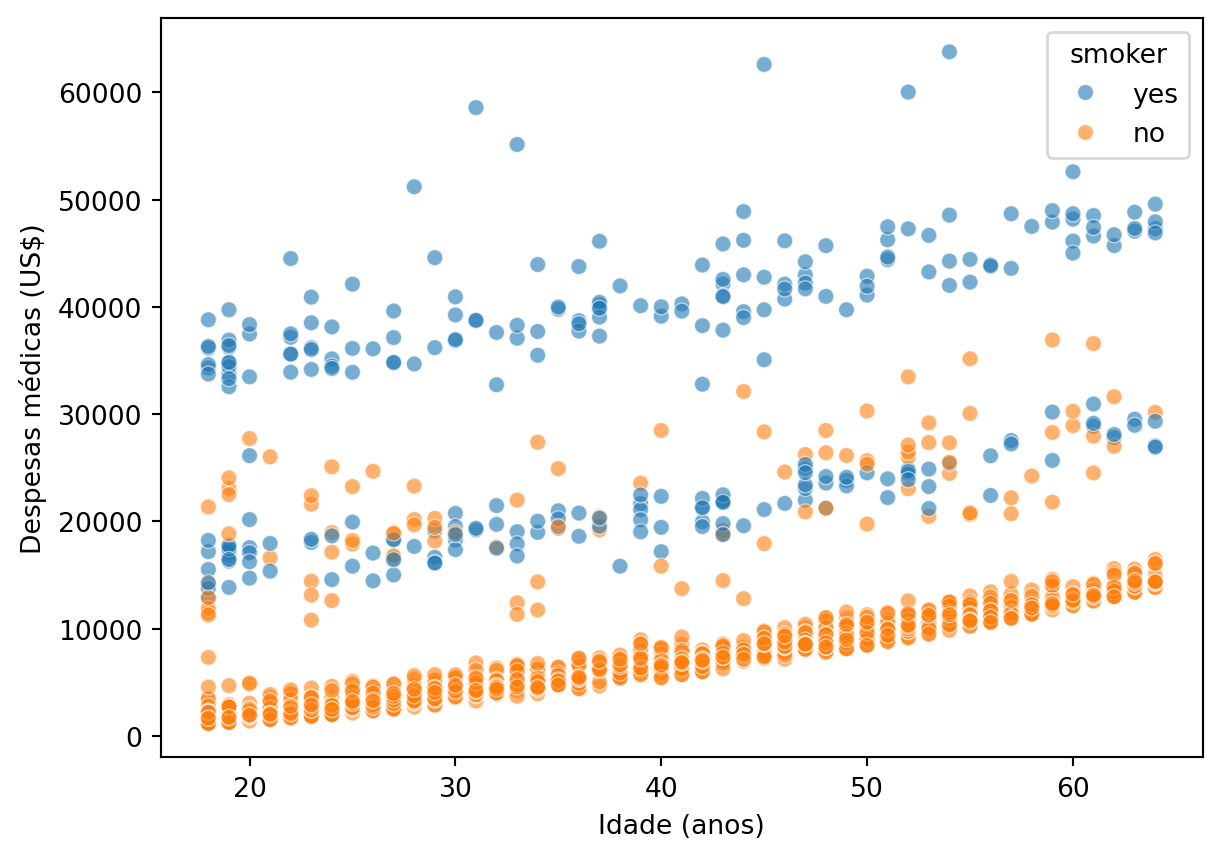
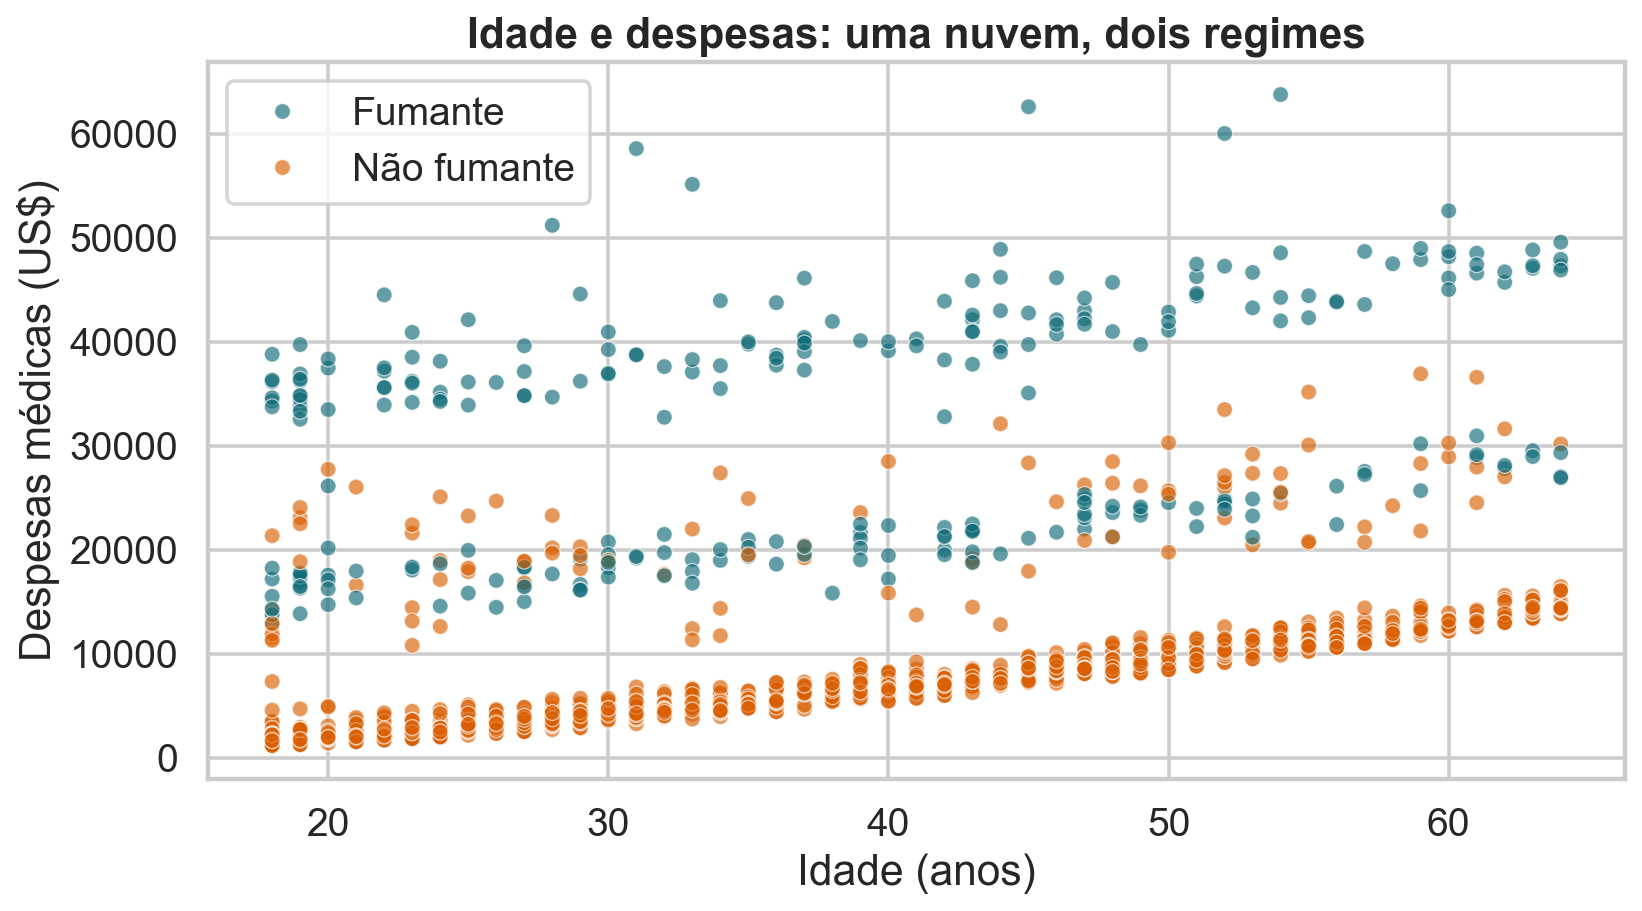
A despesa tende a aumentar com a idade, porém o grupo de fumantes ocupa um patamar muito mais alto. Uma única reta para todos os pontos descreve apenas uma média entre mecanismos heterogêneos.
5. Da variância à covariância
Para uma amostra \(x_1,\ldots,x_n\), a variância amostral é
Aqui, \(n\) é o número de observações, \(x_i\) é a observação \(i\), \(\bar x\) é a média amostral e \(x_i-\bar x\) é seu desvio. O denominador \(n-1\) aparece porque os desvios somam zero: depois de fixar \(n-1\) deles, o último está determinado.
Para duas variáveis, multiplicamos os desvios correspondentes:
\(s_{XY}\): covariância amostral entre \(X\) e \(Y\);
\(x_i-\bar x\): desvio horizontal do ponto em relação à média de \(X\);
\(y_i-\bar y\): desvio da segunda variável;
produto positivo: os desvios têm o mesmo sinal;
produto negativo: os desvios têm sinais opostos.
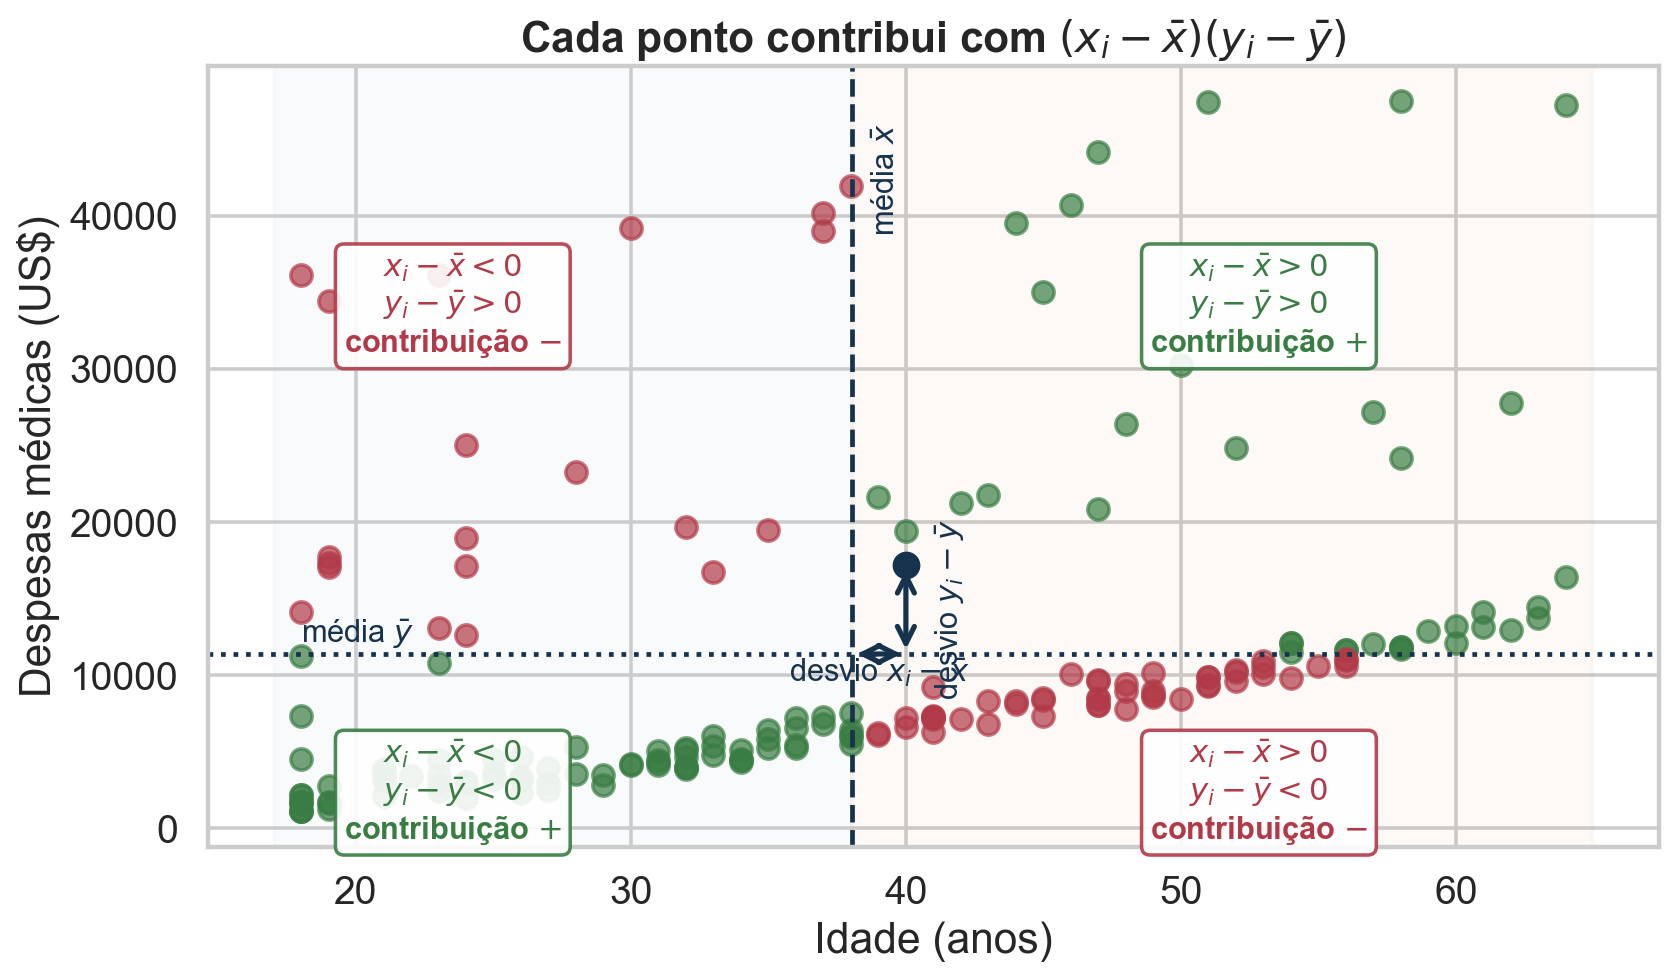
Geometricamente, as retas \(x=\bar x\) e \(y=\bar y\) dividem a dispersão em quatro quadrantes:
posição do ponto
\(x_i-\bar x\)
\(y_i-\bar y\)
contribuição
superior direito
\(+\)
\(+\)
\(+\)
superior esquerdo
\(-\)
\(+\)
\(-\)
inferior esquerdo
\(-\)
\(-\)
\(+\)
inferior direito
\(+\)
\(-\)
\(-\)
Os quadrantes diagonais contribuem positivamente porque multiplicam desvios de mesmo sinal; os outros dois contribuem negativamente. A covariância é o saldo dessas contribuições, dividido por \(n-1\).
x = np.array([1., 2., 3.])y = np.array([2., 1., 5.])products = (x-x.mean())*(y-y.mean())print("Produtos dos desvios:", products)print("Soma:", products.sum())print("Covariância amostral:", products.sum()/(len(x)-1))
O numerador mede variação conjunta. Os dois fatores no denominador medem o comprimento dos vetores centrados e retiram as unidades. Por isso \(r\) é adimensional.
Dividindo ambos os lados pelo produto positivo das normas, obtemos \(|r|\leq1\). Geometricamente, \(r\) é o cosseno do ângulo entre os vetores centrados.
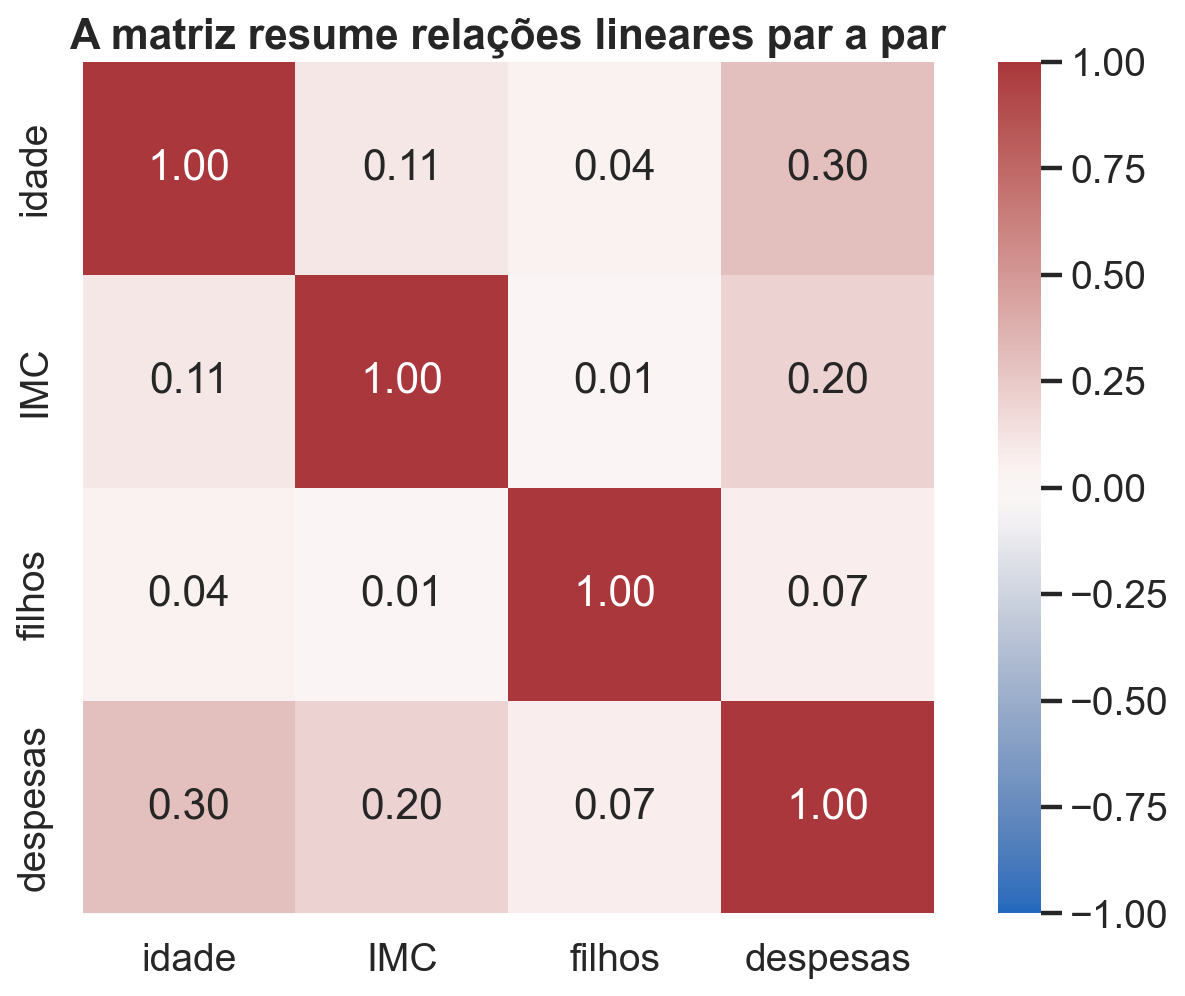
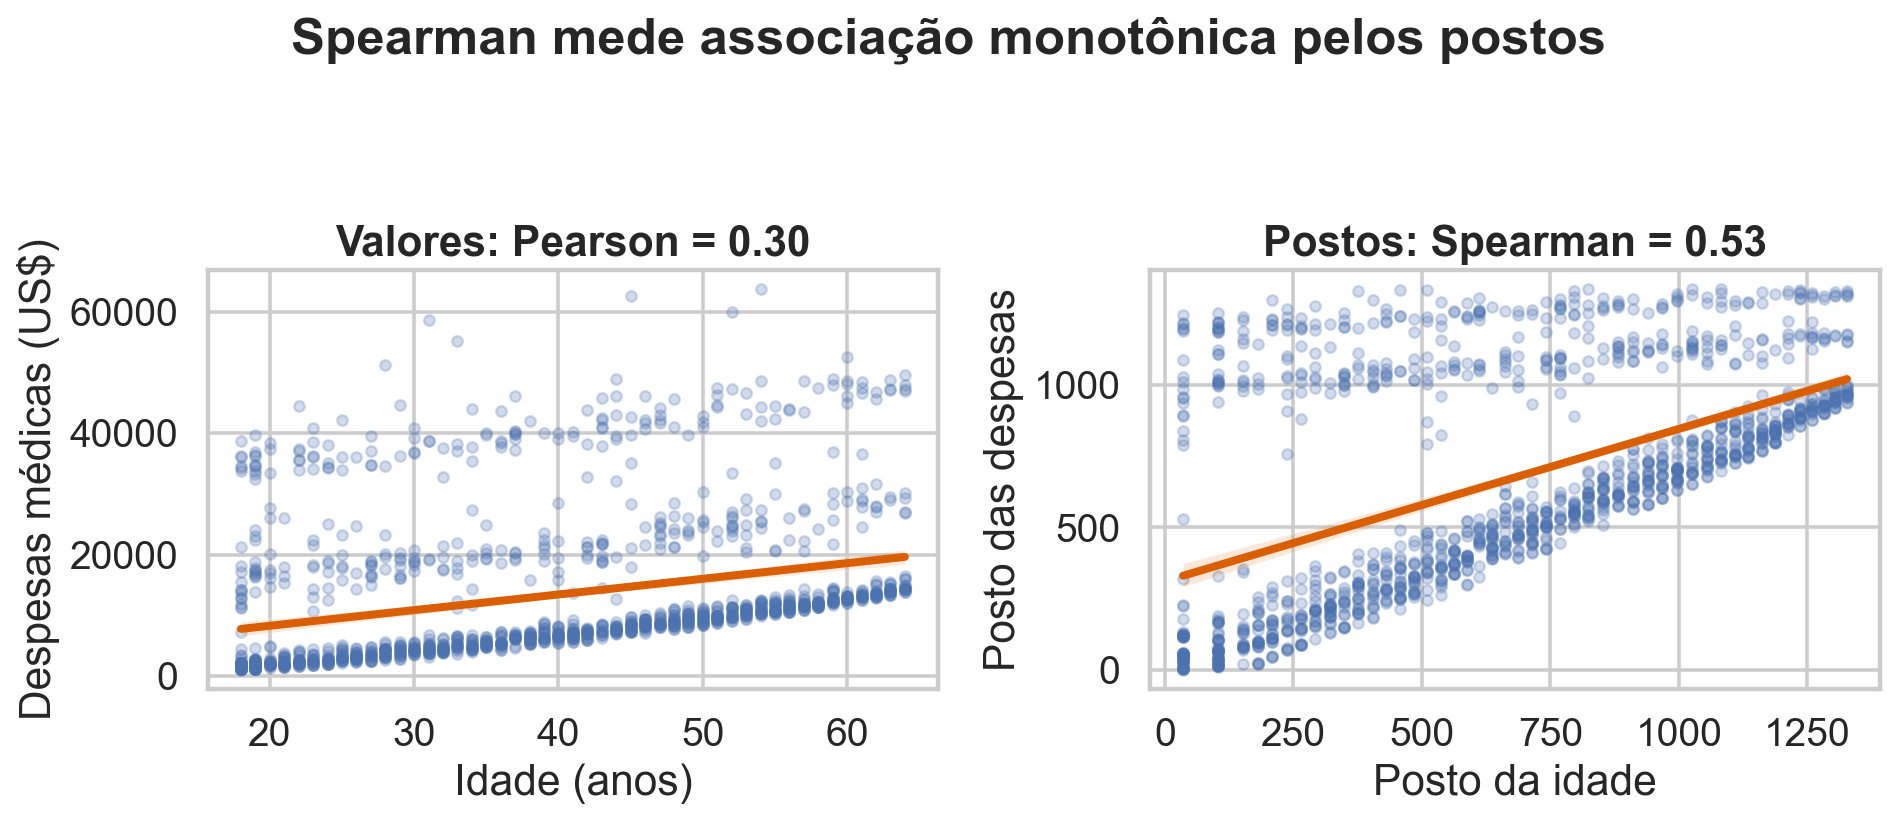
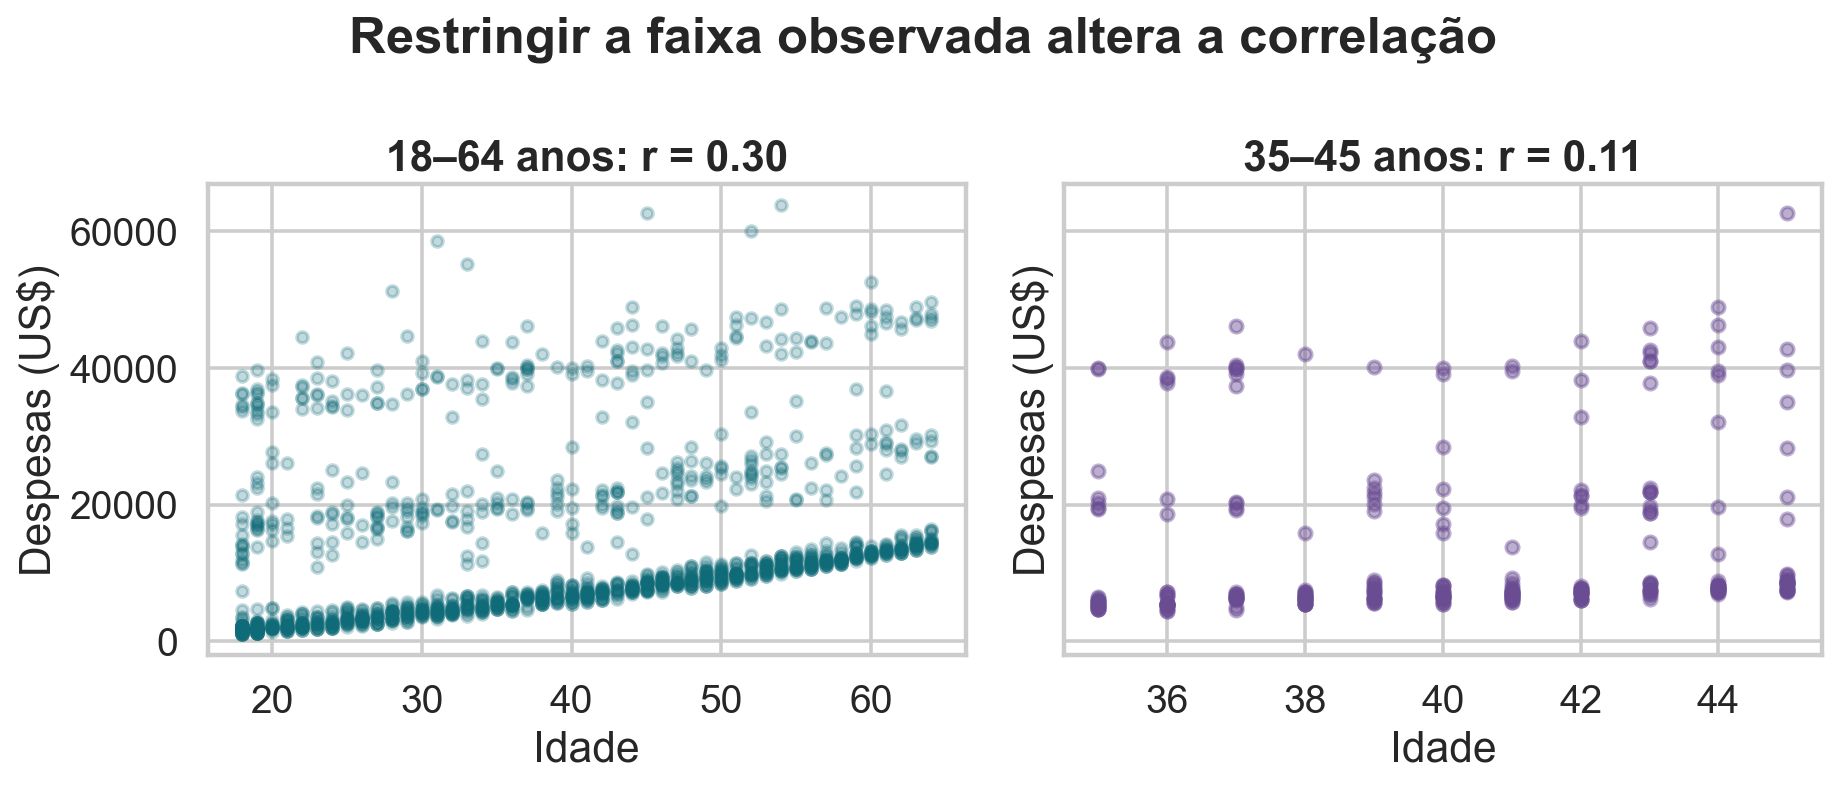
Idade e despesas têm associação linear positiva, mas modesta (\(r\approx0,30\)). O coeficiente não diz que envelhecer causa sozinho o aumento observado, nem controla tabagismo, IMC ou acesso aos serviços de saúde.
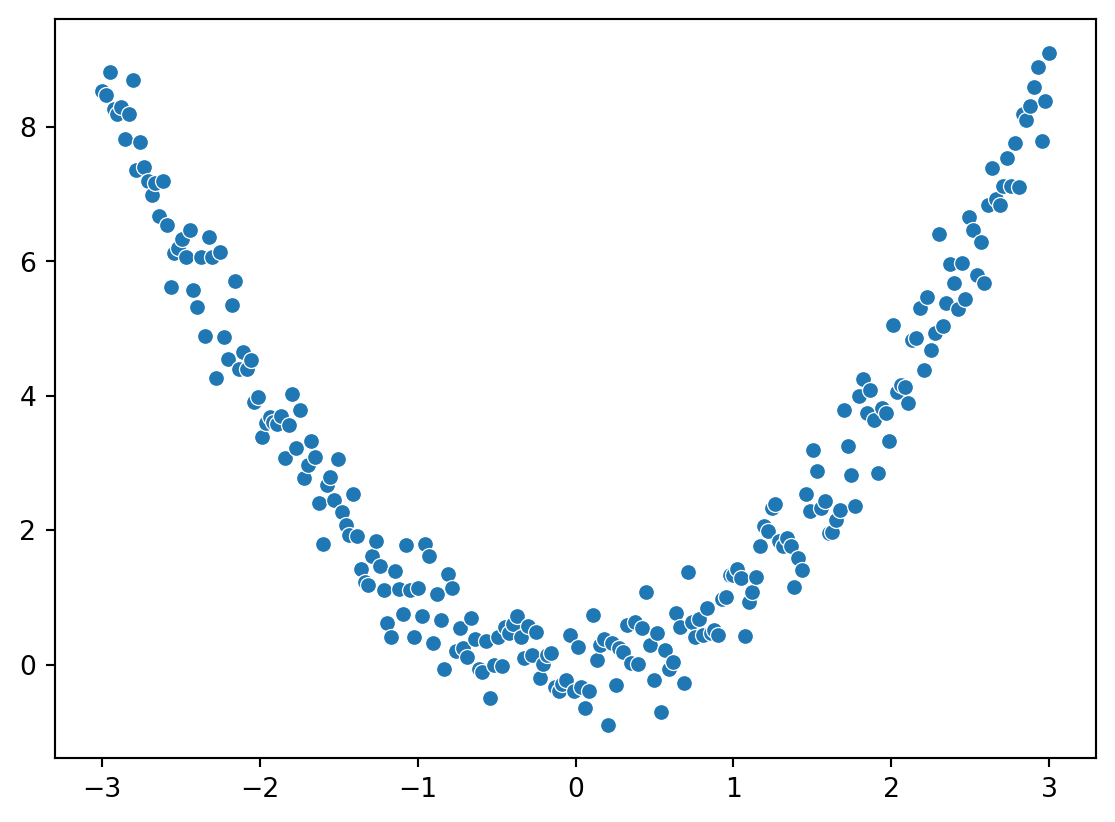
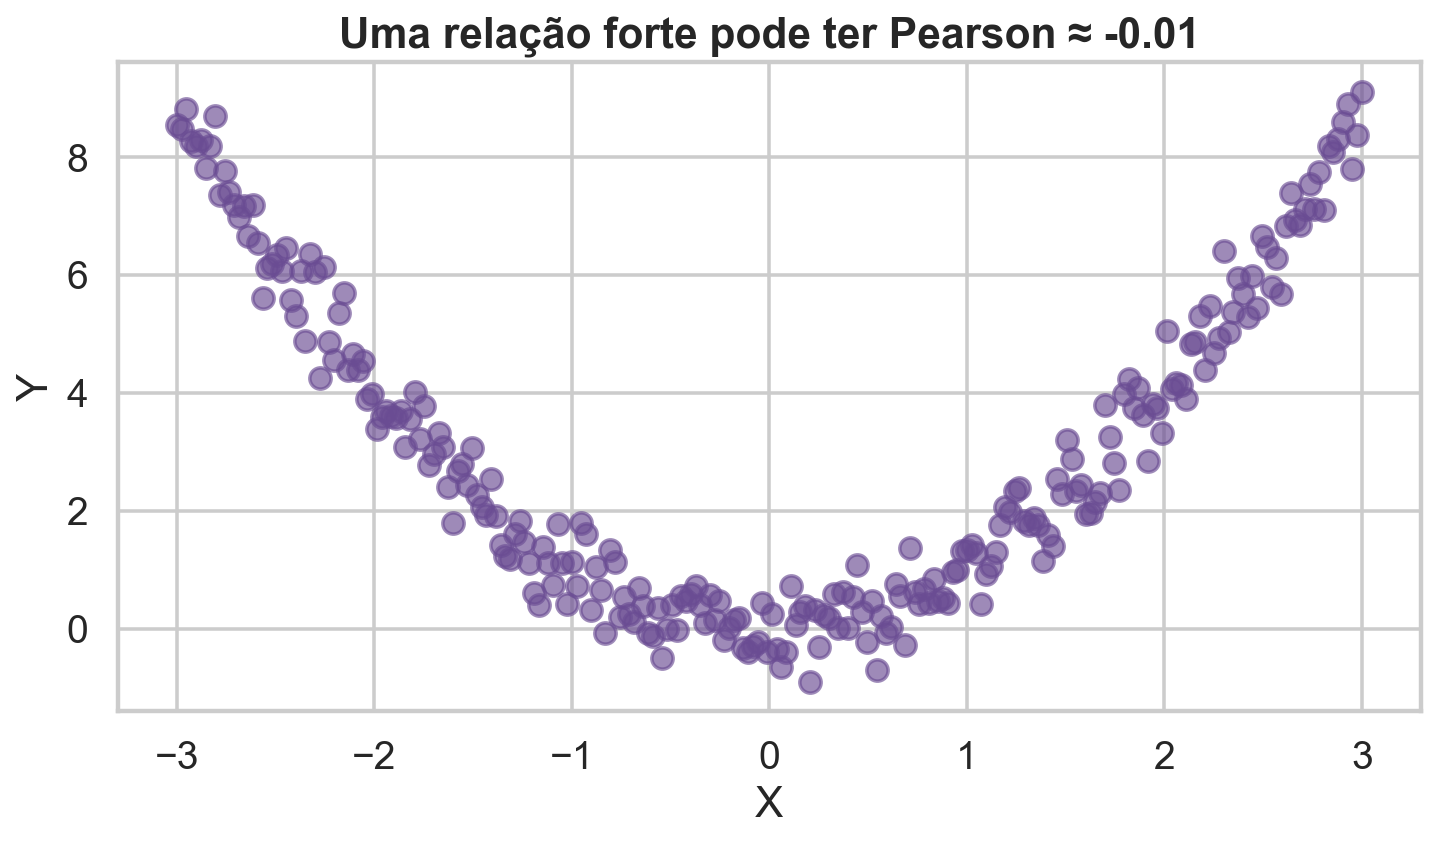
A relação é forte e previsível, mas não linear: o crescimento no braço direito é compensado pela queda no braço esquerdo. Pearson próximo de zero significa ausência de componente linear média, não ausência de dependência.
9. Correlação de Spearman
Spearman aplica Pearson aos postos:
\[
r_S=\operatorname{cor}(R_X,R_Y),
\]
em que \(R_X\) e \(R_Y\) são os vetores de postos das observações. Um posto é a posição ocupada por um valor depois que a variável é ordenada do menor para o maior. Portanto, se \(R_i=\operatorname{rank}(x_i)\) e \(S_i=\operatorname{rank}(y_i)\), Spearman é a correlação de Pearson entre \((R_1,\ldots,R_n)\) e \((S_1,\ldots,S_n)\).
Ele mede associação monotônica e não exige que a variação siga uma reta.
9.1 Exemplo didático sem empates
Considere quatro pares:
pessoa \(i\)
\(x_i\)
\(R_i\)
\(y_i\)
\(S_i\)
\(d_i=R_i-S_i\)
\(d_i^2\)
1
10
1
12
2
−1
1
2
20
2
8
1
1
1
3
30
3
15
3
0
0
4
40
4
20
4
0
0
Os postos de \(X\) são \((1,2,3,4)\). Para \(Y\), o menor valor é 8, seguido por 12, 15 e 20; seus postos na ordem original são \((2,1,3,4)\). Definindo \(d_i=R_i-S_i\), obtemos \(\sum_i d_i^2=2\).
Sem empates, a correlação de Spearman também pode ser escrita como
Nessa expressão, \(n\) é o número de pares, \(d_i\) é a diferença entre os dois postos da observação \(i\) e \(\sum_i d_i^2\) mede o desacordo total entre as duas ordenações. Para o exemplo:
    x    R   y    S    d   d²
0  10  1.0  12  2.0 -1.0  1.0
1  20  2.0   8  1.0  1.0  1.0
2  30  3.0  15  3.0  0.0  0.0
3  40  4.0  20  4.0  0.0  0.0
Spearman pela fórmula: 0.8
Spearman pelo SciPy: 0.7999999999999999
NotaInterpretação
O valor 0,80 é alto porque as ordenações quase coincidem. A única discordância é a inversão entre as duas primeiras pessoas; se todos os postos fossem iguais, \(\sum_i d_i^2=0\) e \(r_S=1\).
9.2 Empates recebem postos médios
Quando há empates, cada observação recebe o posto médio das posições que ocuparia. Por exemplo, \((18,18,19,21)\) recebe postos \((1{,}5,1{,}5,3,4)\).
Nesse caso, a forma segura é calcular \(r_S=\operatorname{cor}(R_X,R_Y)\) diretamente. A fórmula abreviada baseada em \(\sum_i d_i^2\) pressupõe ausência de empates; sem a correção apropriada, ela não deve ser usada.
Spearman é maior porque a ordenação das despesas acompanha a idade melhor do que uma reta acompanha os valores em dólares. Isso não torna Spearman automaticamente superior: a escolha depende da pergunta sobre linearidade ou monotonicidade.
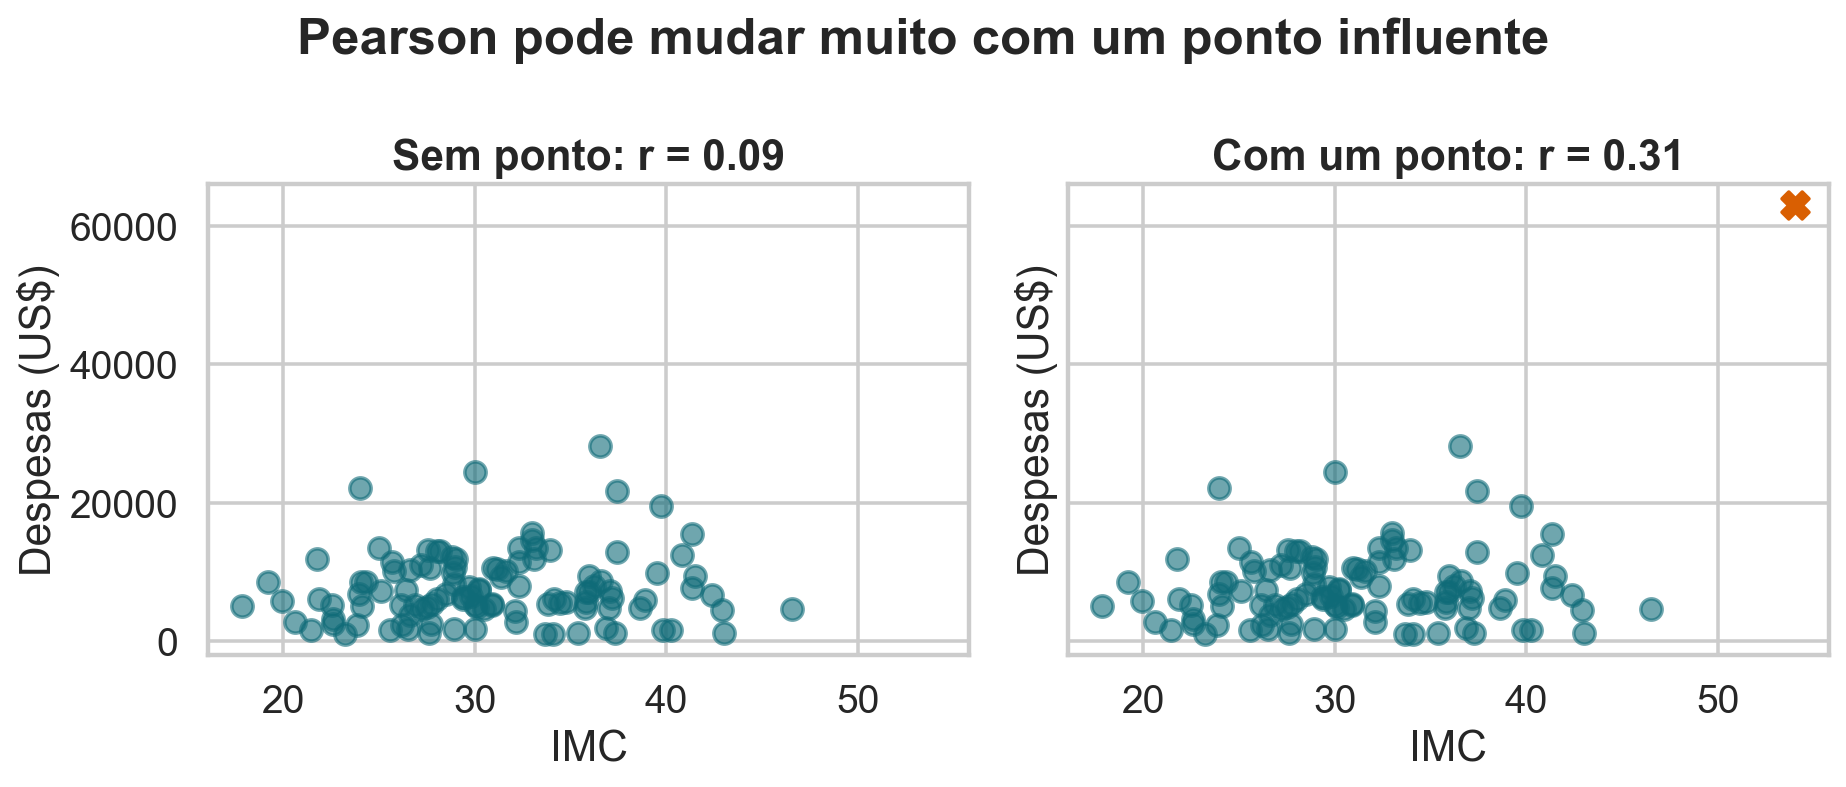
Sem ponto: 0.09407093755963403
Com ponto: 0.3082797195453476
NotaInterpretação
O ponto acrescentado está distante nas duas coordenadas e cria um produto de desvios muito grande. Pontos assim merecem investigação, mas não devem ser removidos apenas porque mudam a conclusão.
Dentro da faixa estreita há menos variação em idade. O valor de \(r\) descreve a população e o intervalo observados; ele não é uma constante universal que pode ser transportada sem considerar o desenho amostral.
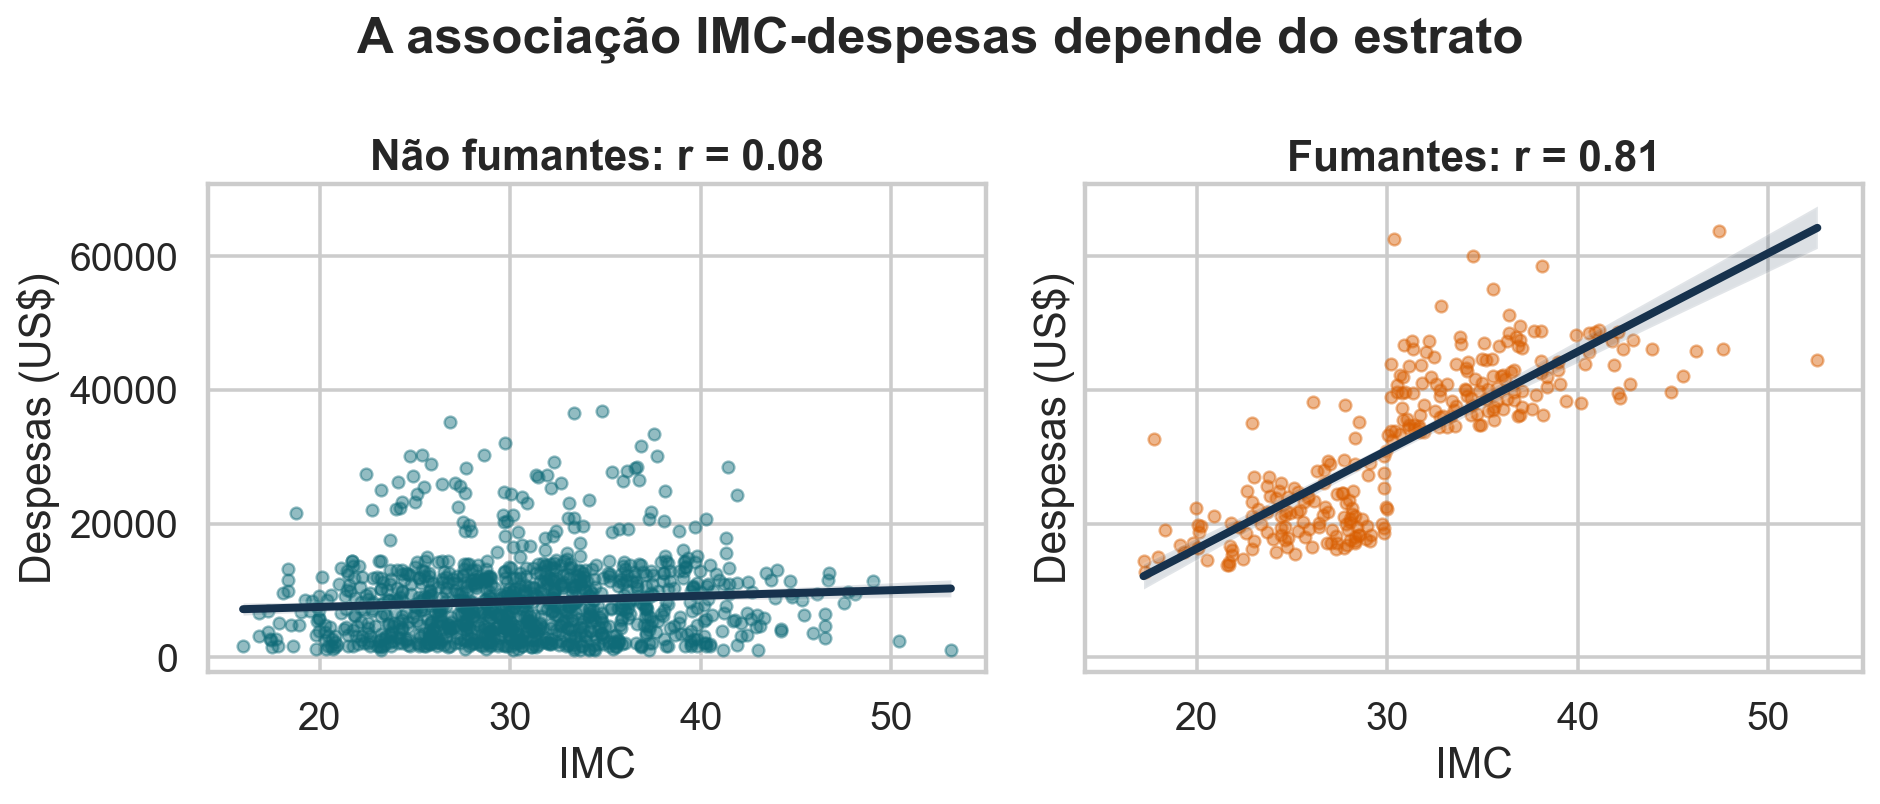
A correlação global é 0,20, mas vale aproximadamente 0,08 entre não fumantes e 0,81 entre fumantes. A associação do IMC com despesas depende fortemente do estrato; a média marginal esconde essa heterogeneidade.
12.1 Simpson, confundimento e condicionamento
O paradoxo de Simpson ocorre quando associações dentro dos estratos têm uma direção, mas a associação agregada tem direção oposta. Ele é uma forma extrema de mistura por composição dos grupos.
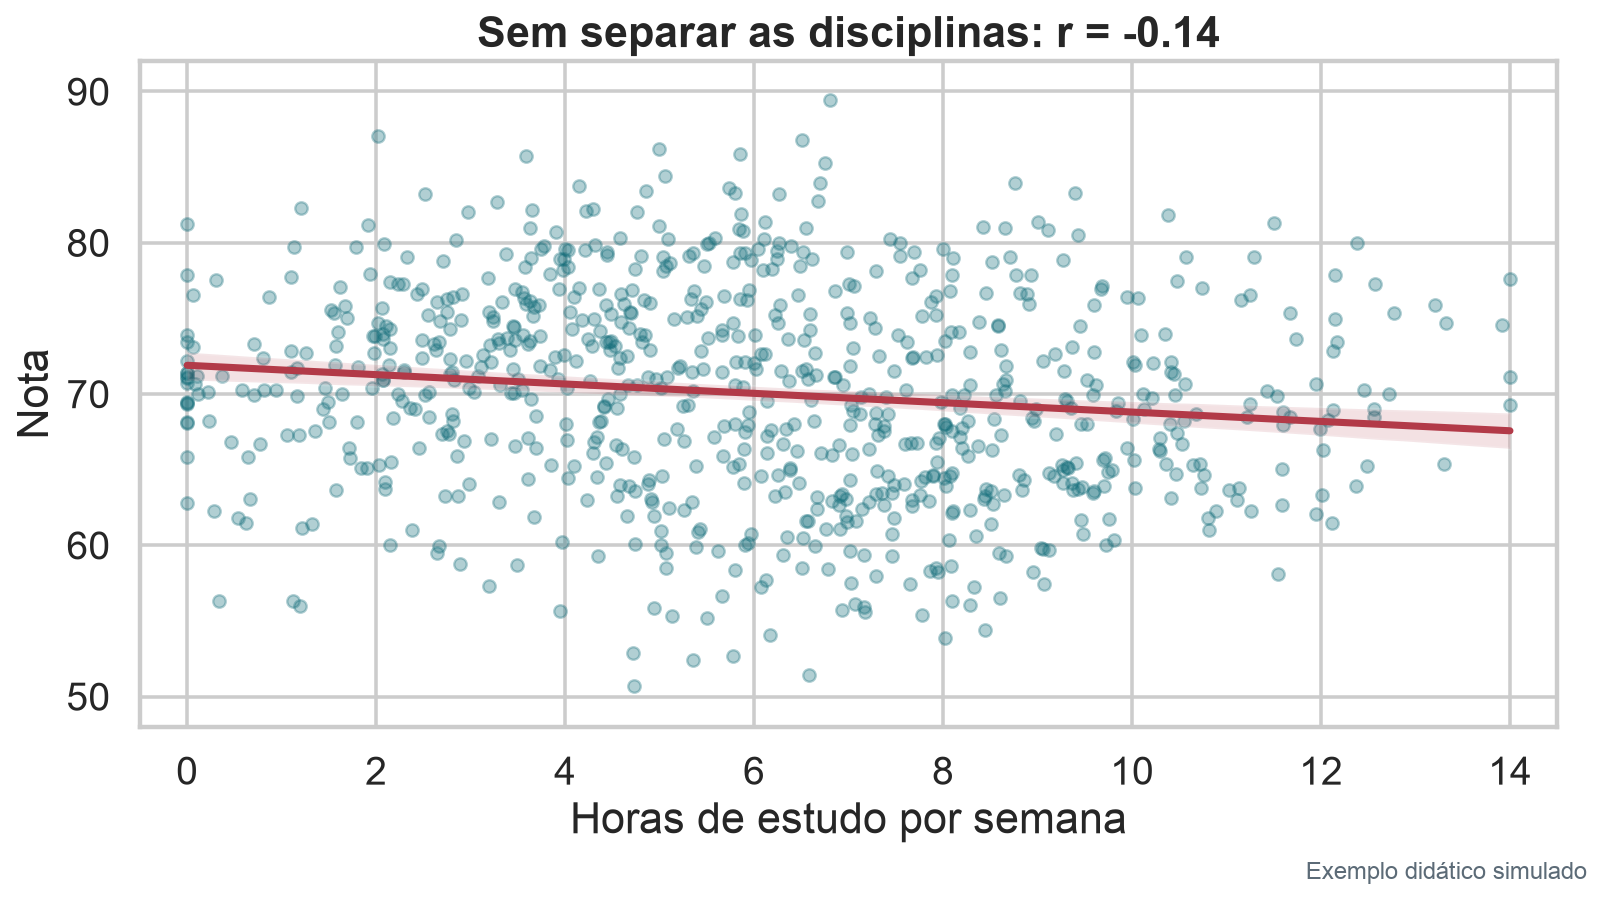
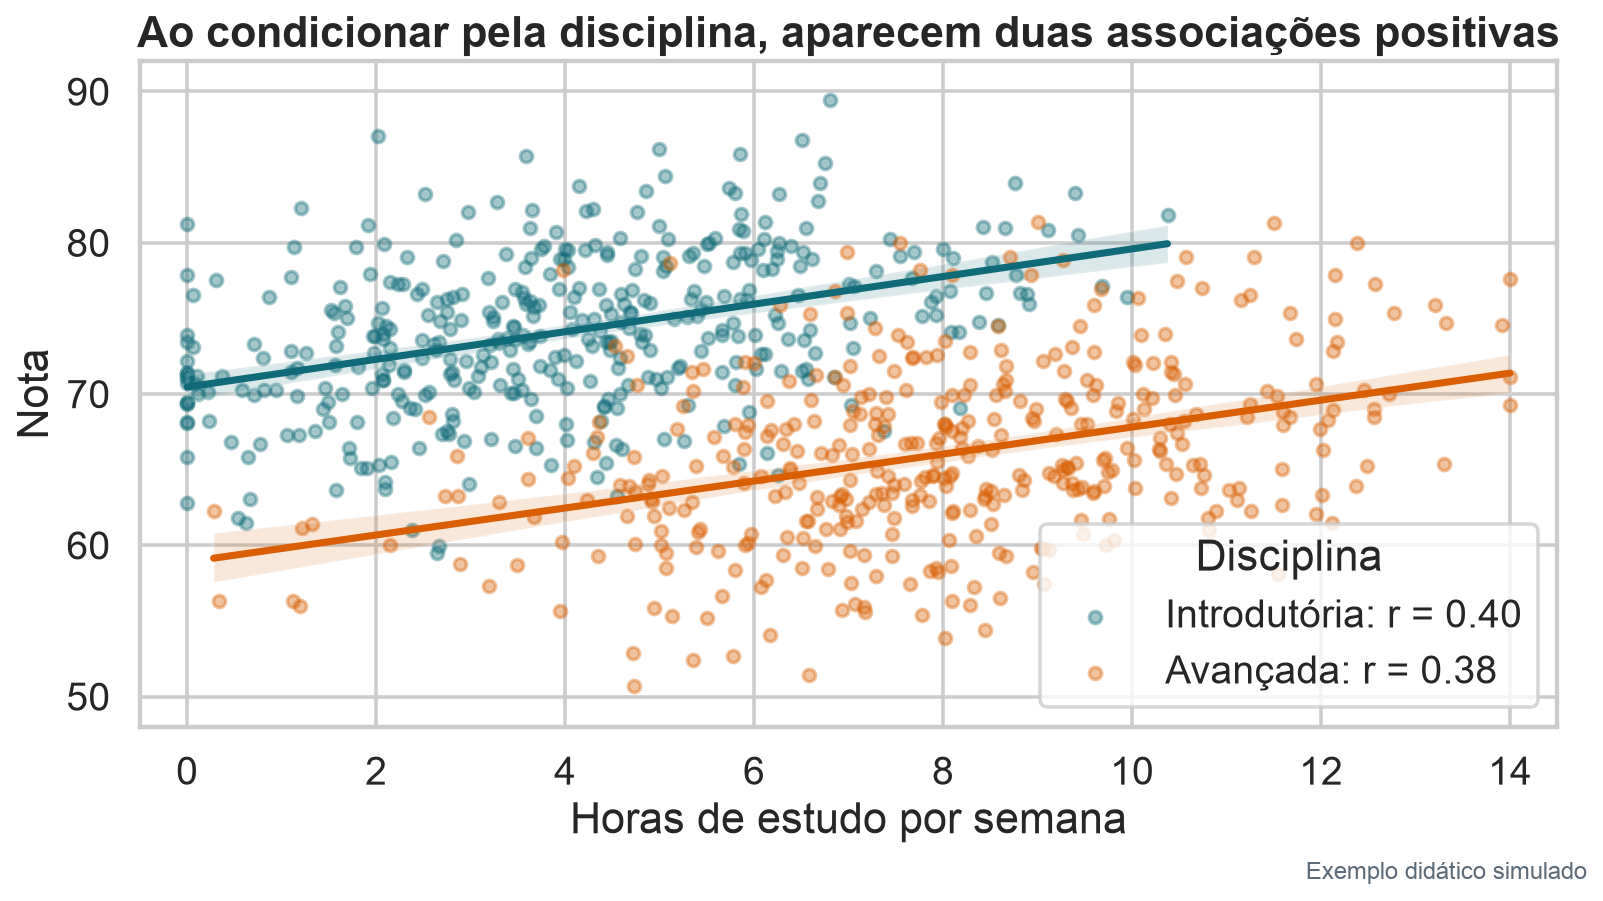
Considere um exemplo didático simulado com duas disciplinas. Na disciplina introdutória, os estudantes tendem a estudar menos e a prova é mais simples. Na disciplina avançada, eles tendem a estudar mais e a prova é mais difícil. Dentro de cada disciplina, mais horas de estudo acompanham notas maiores.
Ao misturar as disciplinas, a correlação vale aproximadamente \(-0{,}14\). Essa comparação combina o efeito da composição dos grupos com a associação existente dentro de cada disciplina.
Depois de condicionar pela disciplina
NotaInterpretação
As correlações condicionais valem aproximadamente \(0{,}40\) na disciplina introdutória e \(0{,}38\) na avançada. A relação positiva dentro dos dois grupos se torna negativa quando eles são agregados. Não há contradição: a correlação marginal e as correlações condicionais respondem a comparações diferentes.
Marginal, condicional e parcial no mesmo exemplo
A correlação marginal usa todos os estudantes sem considerar a disciplina: \(r=-0{,}14\). As correlações condicionais são calculadas separadamente dentro dos estratos: \(0{,}40\) na introdutória e \(0{,}38\) na avançada.
A correlação parcial segue outra lógica. Primeiro retiramos de horas e de nota as diferenças lineares explicadas pela disciplina. Depois calculamos a correlação entre os dois conjuntos de resíduos. Aqui, \(D_i=1\) identifica a disciplina avançada e \(D_i=0\) identifica a introdutória:
A correlação parcial vale aproximadamente \(0{,}39\), próxima das duas correlações condicionais. Isso ocorre porque o ajuste remove a diferença média entre as disciplinas antes de medir a associação linear restante. O ajuste não transforma automaticamente a associação em efeito causal.
Condicionar não é um procedimento mecânico. Uma variável \(Z\) pode ser:
confundidora, por influenciar \(X\) e \(Y\);
mediadora, por estar no caminho de \(X\) para \(Y\);
colisora, por ser consequência de \(X\) e \(Y\).
Controlar confundidores pode reduzir viés; controlar mediadores ou colisores pode mudar a pergunta ou criar viés. O conhecimento causal orienta a escolha.
13. Incerteza da correlação
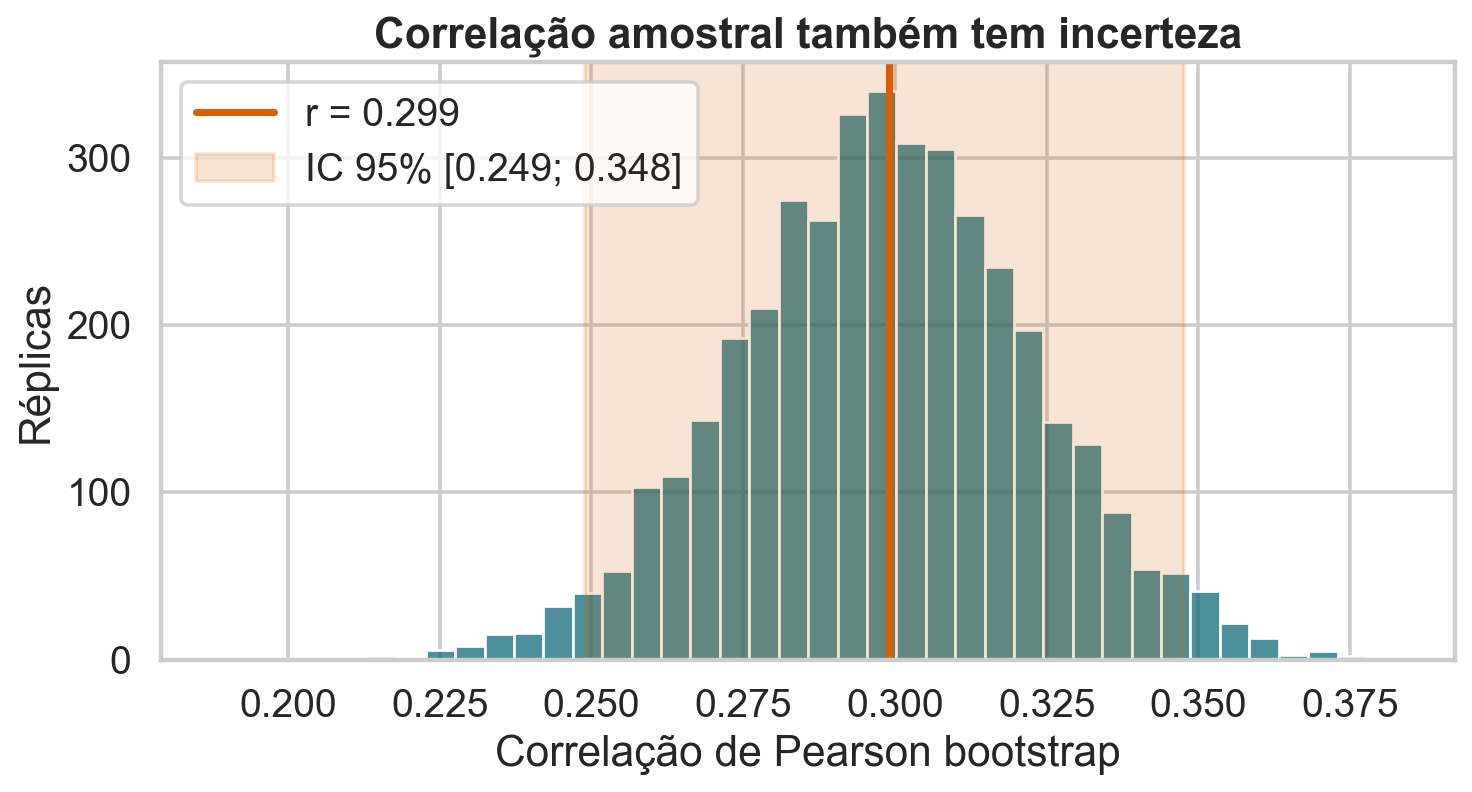
Na população, a correlação é \(\rho\); na amostra, calculamos \(r\). Para obter um intervalo bootstrap, reamostramos linhas completas, preservando cada par \((x_i,y_i)\).
O intervalo de aproximadamente \([0,25;0,35]\) descreve a incerteza amostral sob uma reamostragem i.i.d. das pessoas observadas. Ele não incorpora viés de seleção, erro de medição ou dependência não modelada.
13.1 Testar \(H_0:\rho=0\)
Sob normalidade bivariada, a transformação de Fisher
é aproximadamente normal, com erro-padrão \(1/\sqrt{n-3}\). Aqui, \(Z\) é a correlação transformada, \(r\) é a correlação amostral e \(n\) é o tamanho da amostra.
Uma alternativa é permutar uma variável em relação à outra para representar ausência de associação, desde que a hipótese de trocabilidade seja justificável. Rejeitar \(H_0:\rho=0\) não demonstra independência nem causalidade.
14. Correlação não é causalidade
Uma correlação entre \(X\) e \(Y\) é compatível com:
\[
X\to Y,\qquad Y\to X,\qquad Z\to X\text{ e }Z\to Y,
\]
além de seleção, tendências comuns e acaso. A base de seguros é observacional; portanto, não identifica o efeito causal de fumar, envelhecer ou alterar o IMC.
Também evite a falácia ecológica: uma correlação entre médias de estados ou países não implica a mesma relação entre indivíduos.
15. Guia de decisão
Use Pearson quando a pergunta é sobre associação linear e o gráfico não revela curvatura ou influência extrema dominante.
Use Spearman quando a pergunta é sobre ordenação monotônica, a escala é ordinal ou uma transformação monotônica é plausível.
Em ambos os casos:
descreva a base e a unidade observacional;
visualize os dados;
investigue grupos e pontos influentes;
reporte coeficiente e incerteza;
limite a conclusão à população e ao desenho;
não use linguagem causal sem identificação causal.
16. Questões de revisão
Observe a figura quiz-correlacoes.png dos slides e ordene as quatro nuvens por sinal e magnitude de Pearson antes de calcular.
Por que dividir a covariância por \(s_Xs_Y\) remove as unidades?
Construa dois vetores dependentes com Pearson zero.
Na relação monotônica curva do quiz, por que Spearman é maior que Pearson?
Explique por que reamostrar age e charges separadamente seria errado no bootstrap.
Por que a correlação IMC-despesas muda ao separar fumantes?
Que informação a matriz de correlação não mostra?
Refaça a análise usando children e explique por que o coeficiente é pequeno.
Bibliografia
Para uma primeira leitura, use Introduction to Modern Statistics e o material de Computational and Inferential Thinking. ISLR conecta correlação à regressão; Freedman aprofunda interpretação e riscos em estudos observacionais.
Çetinkaya-Rundel e Hardin, Introduction to Modern Statistics, correlação e regressão linear.