A unidade de observação é um pedido. A partir das datas, calculamos tempo de entrega e indicador de atraso.
Nossa população didática
Após remover pedidos sem datas completas:
Medida
Valor
Pedidos
96.476
Tempo médio
12,56 dias
Desvio padrão
9,55 dias
Entregas atrasadas
8,11%
Trataremos esses pedidos como uma população conhecida para validar os métodos.
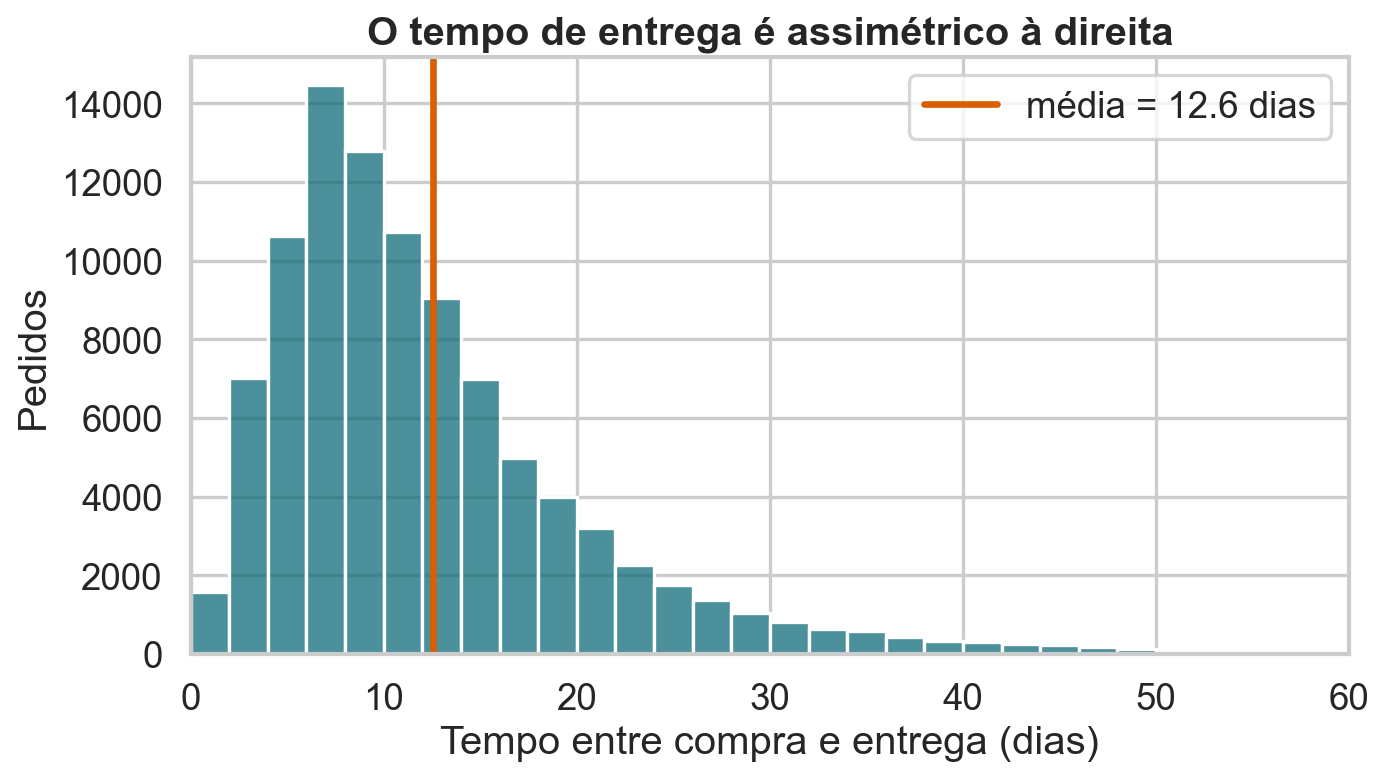
A distribuição não parece Normal
Há uma cauda longa: poucos pedidos demoram muito mais que o típico.
Código do gráfico
plt.figure(figsize=(9, 5.2))sns.histplot(delivery, bins=np.arange(0, 61, 2), color=BLUE)plt.axvline(mu, color=ORANGE, lw=3, label=f"média = {mu:.1f} dias")plt.xlim(0, 60)plt.xlabel("Tempo entre compra e entrega (dias)")plt.ylabel("Pedidos")plt.title("O tempo de entrega é assimétrico à direita")plt.legend()finish("populacao-entrega.png")
Uma amostra é imperfeita
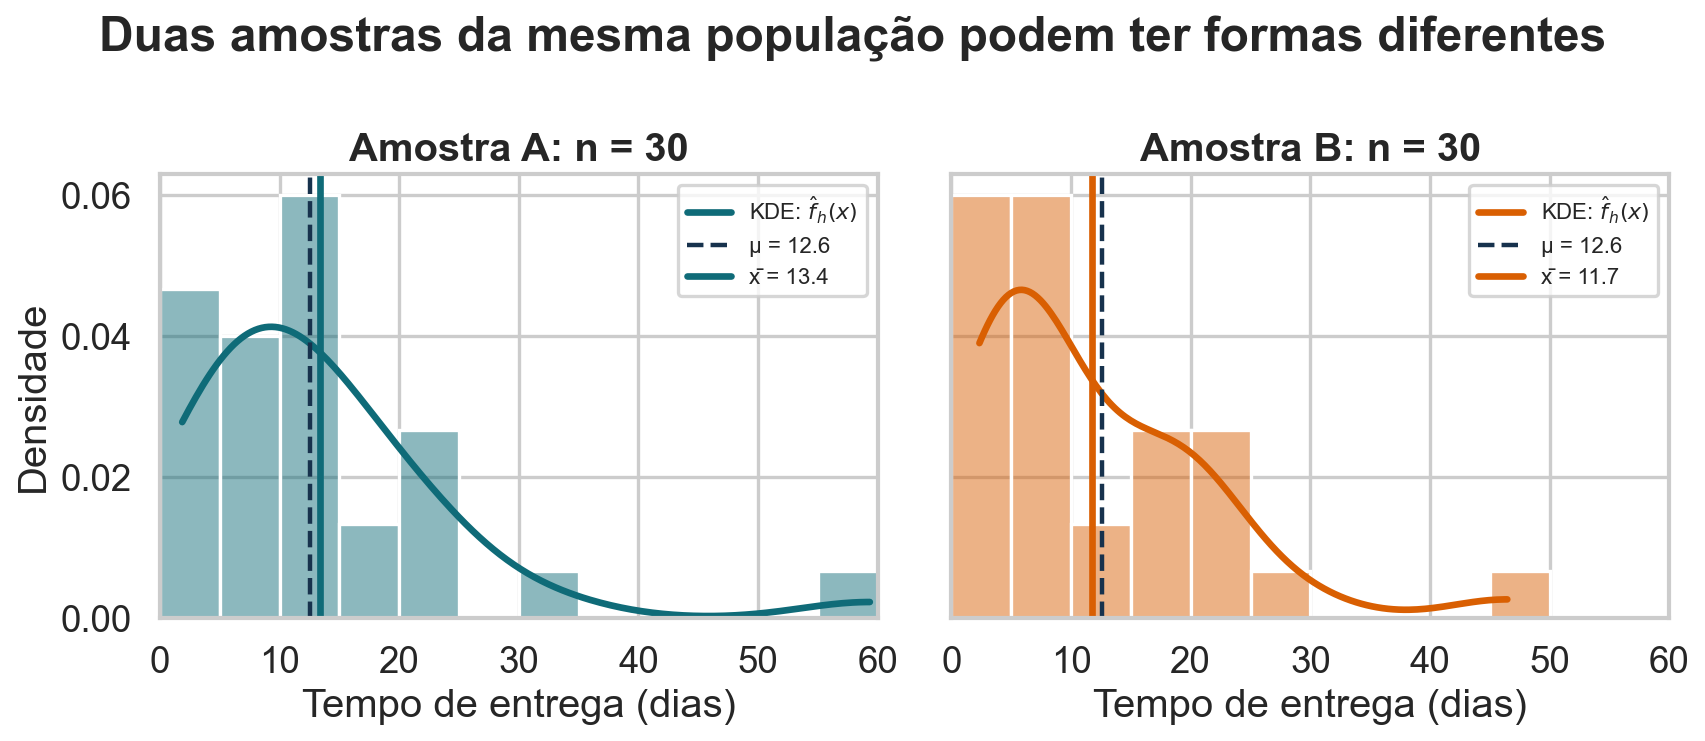
Duas amostras da mesma população produzem histogramas, médias e estimativas da densidade diferentes. Com apenas 30 observações, a variabilidade amostral fica fácil de perceber.
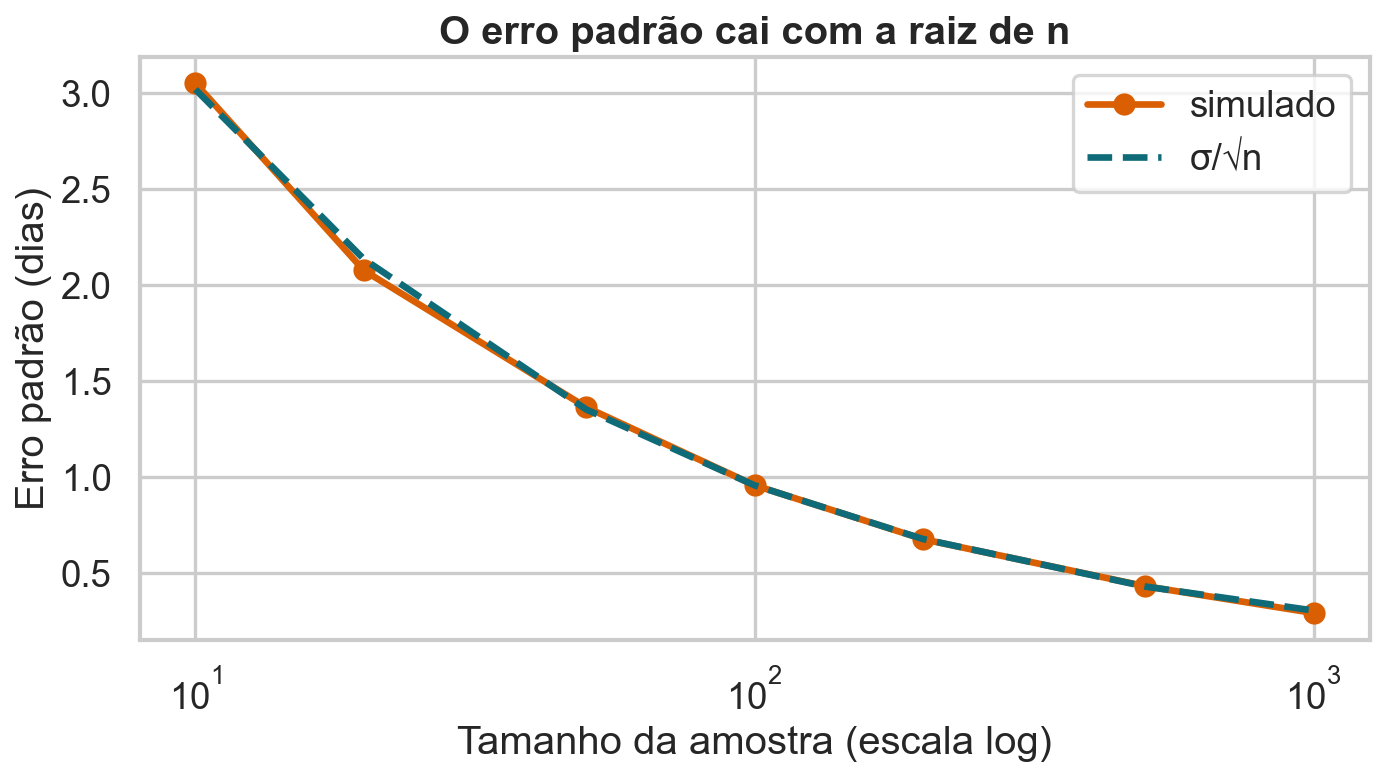
\(\bar X=n^{-1}\sum_iX_i\) é a média amostral; \(n\) é o tamanho da amostra; \(\sigma\) é o desvio padrão populacional. O erro padrão é o desvio padrão da distribuição amostral de \(\bar X\).
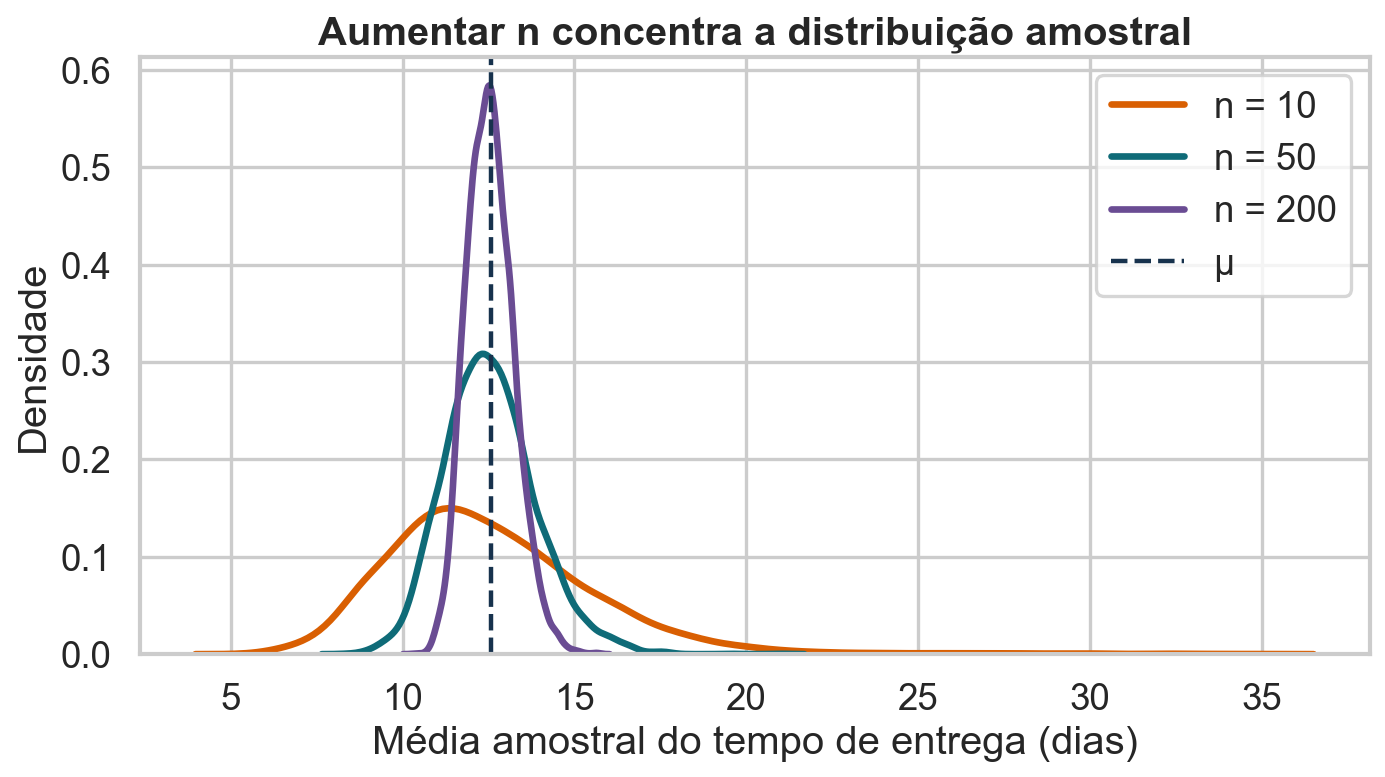
Aumentar n concentra as médias
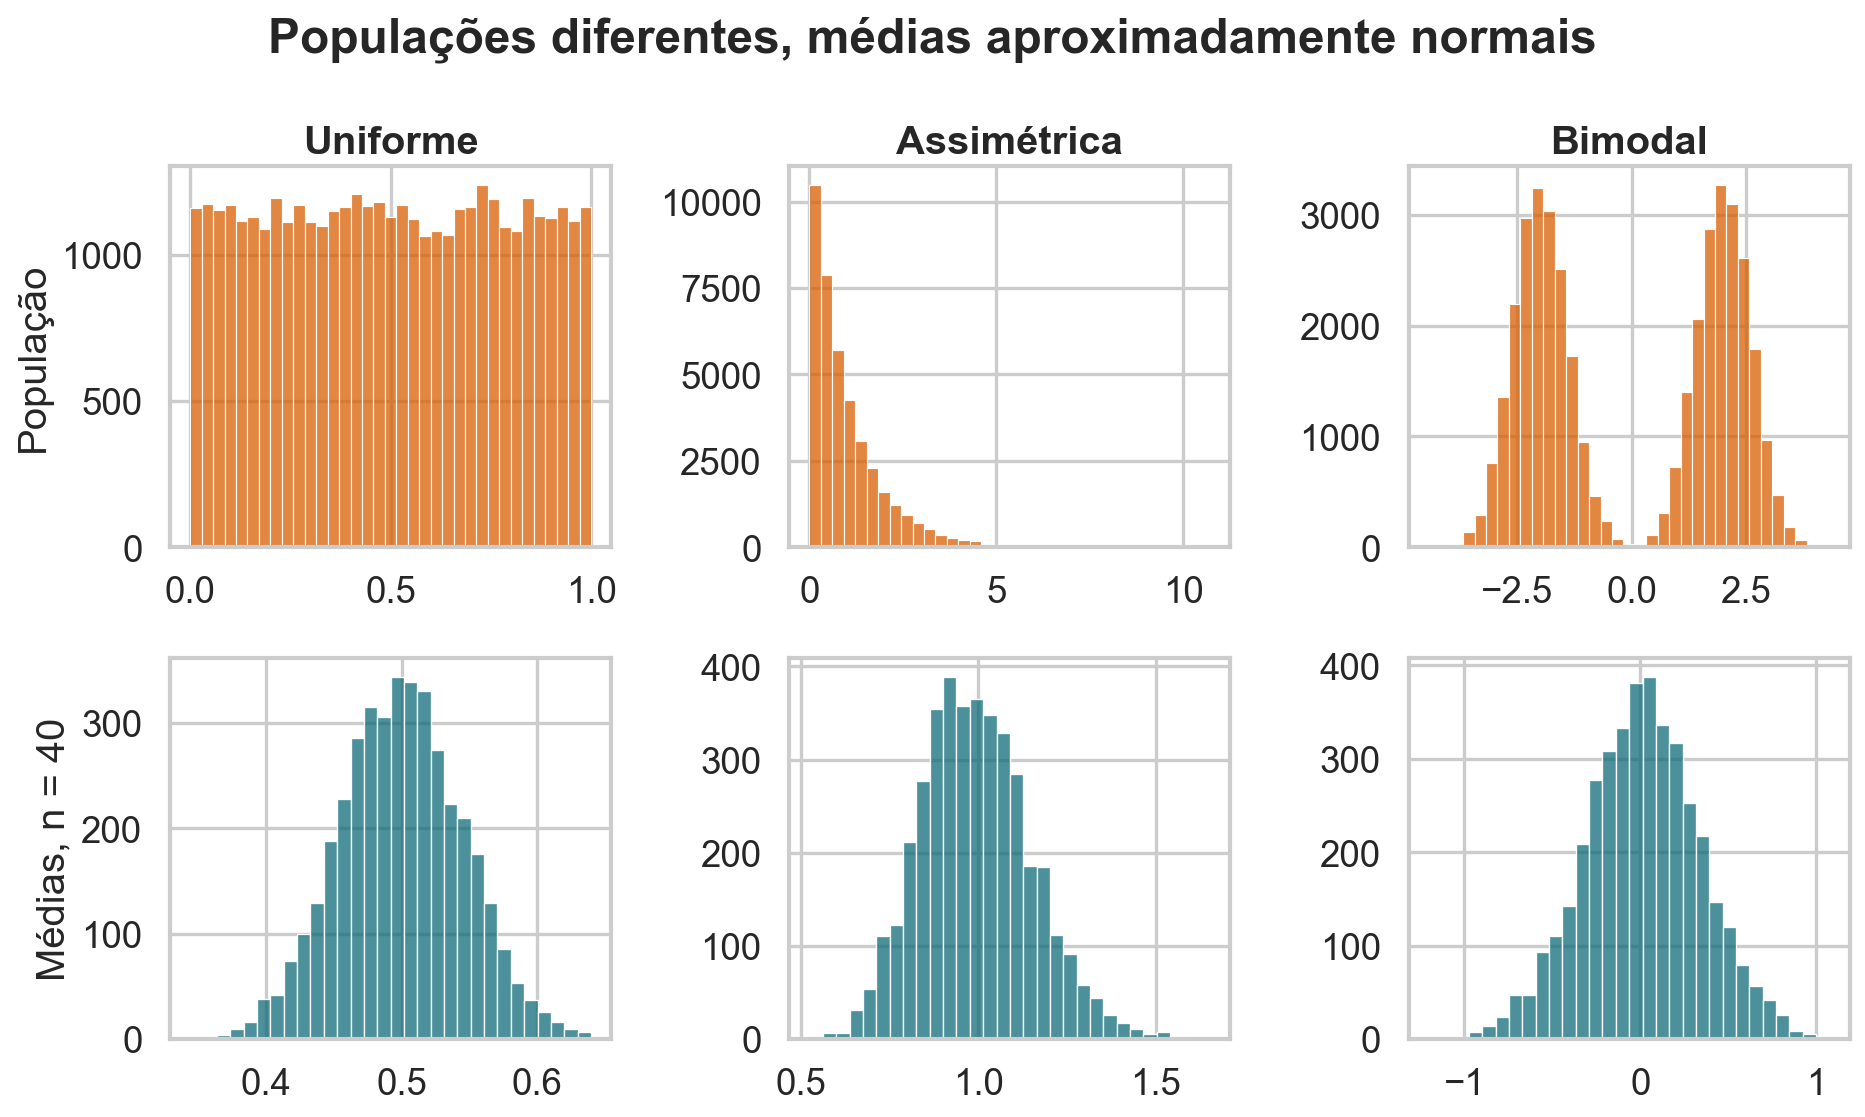
O centro permanece em \(\mu\); a dispersão diminui.
Código do gráfico
means_10 = sample_means(delivery, 10)means_50 = sample_means(delivery, 50)means_200 = sample_means(delivery, 200)plt.figure(figsize=(9, 5.2))for vals, label, color in [(means_10, "n = 10", ORANGE), (means_50, "n = 50", BLUE), (means_200, "n = 200", PURPLE)]: sns.kdeplot(vals, lw=3, color=color, label=label)plt.axvline(mu, color=INK, lw=2, ls="--", label="μ")plt.xlabel("Média amostral do tempo de entrega (dias)")plt.ylabel("Densidade")plt.title("Aumentar n concentra a distribuição amostral")plt.legend()finish("tcl-tamanhos.png")
LGN e TCL respondem perguntas diferentes
Lei dos Grandes Números
\[{\bar X}_n \xrightarrow{P} \mu\]
Pergunta: para onde a média amostral vai?
Resposta:\(\bar X_n\) se aproxima de \(\mu\) quando \(n\) cresce.
Não informa: o formato aproximado da distribuição de \(\bar X_n\).
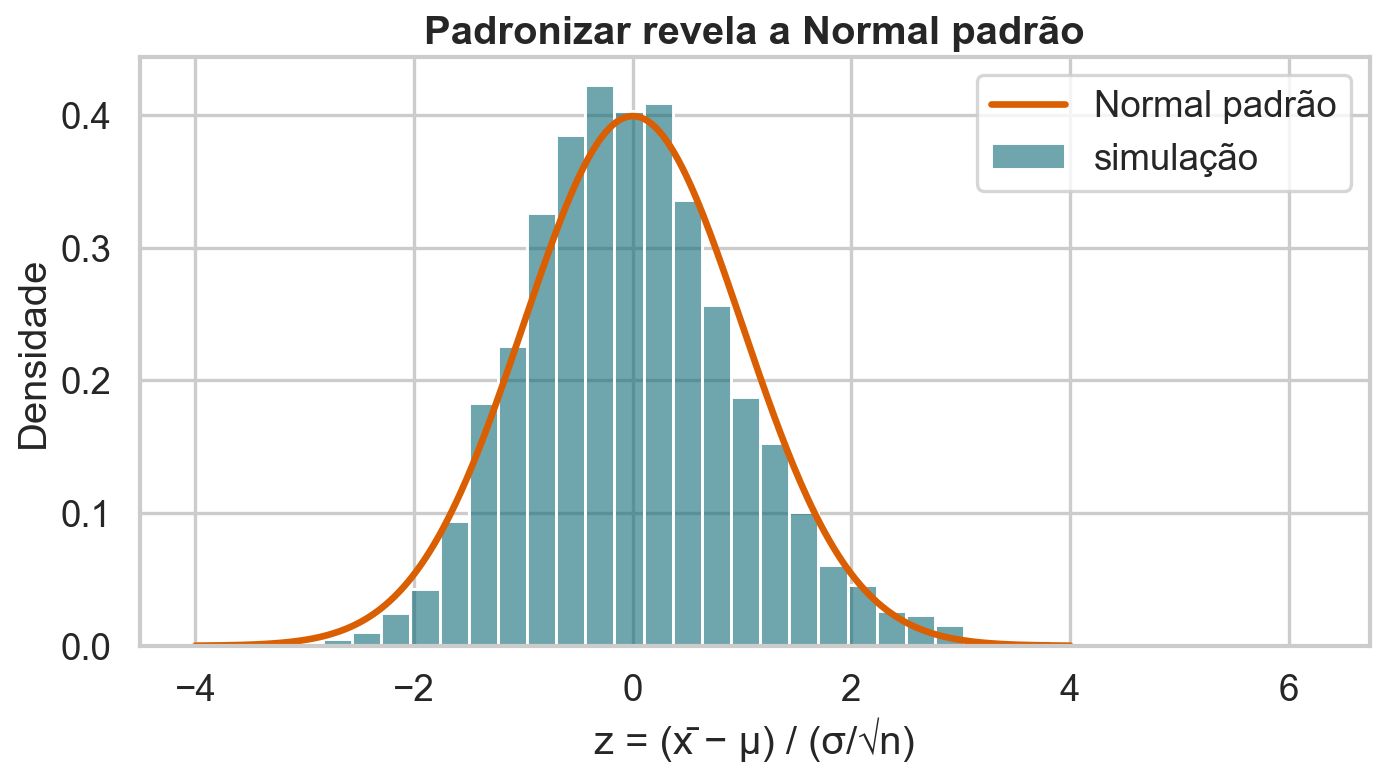
\(\xrightarrow{d}\) significa convergência em distribuição; \(N(0,1)\) é a Normal padrão. A aproximação afirma que \(\bar X\) tem centro \(\mu\) e variância aproximada \(\sigma^2/n\) — não que cada \(X_i\) seja Normal.
Independência é uma condição central
O TCL clássico pressupõe observações independentes ou fracamente dependentes.
Pode falhar quando:
medimos repetidamente o mesmo indivíduo;
eventos vizinhos influenciam uns aos outros;
séries temporais têm forte autocorrelação;
a coleta agrupa unidades muito semelhantes.
A amostra deve representar a população
O TCL descreve variabilidade aleatória dentro do mecanismo assumido.
Ele não corrige:
viés de seleção;
grupos ausentes;
erros sistemáticos de medição;
mudanças da população ao longo do tempo.
Amostragem sem reposição exige cuidado
Quando amostramos grande parte de uma população finita:
Não existe um número mágico universal como \(n=30\).
O tamanho adequado depende de:
assimetria e caudas;
presença de outliers;
dependência entre observações;
estatística utilizada;
precisão desejada.
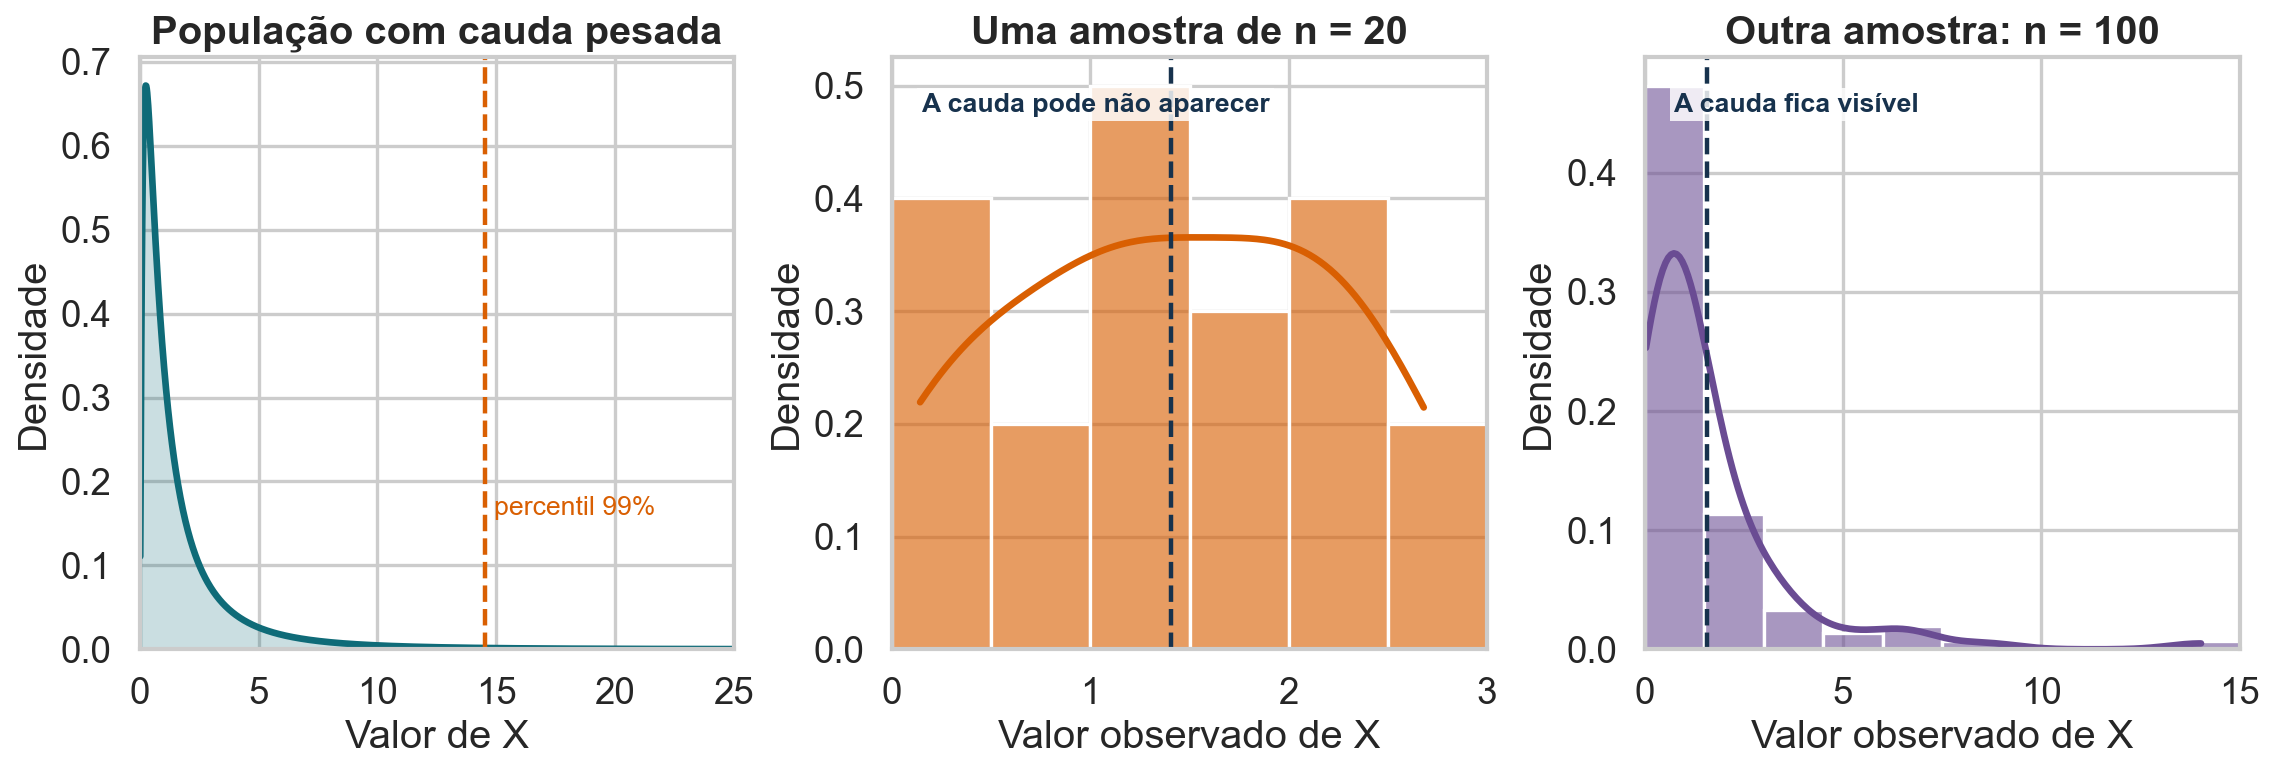
Uma amostra pequena pode esconder a cauda
A aparência de uma única amostra não garante que a população seja simétrica. Com \(n=20\), valores raros podem não aparecer; com \(n=100\), a amostra tem mais oportunidade de revelar a cauda.
\(\bar x\) é a média observada, \(s\) estima \(\sigma\), \(s/\sqrt n\) estima o erro padrão e \(1{,}96\) é o quantil \(0{,}975\) da Normal padrão. A forma geral é estimativa \(\pm\) valor crítico \(\times\) erro padrão.
Um intervalo com n = 100
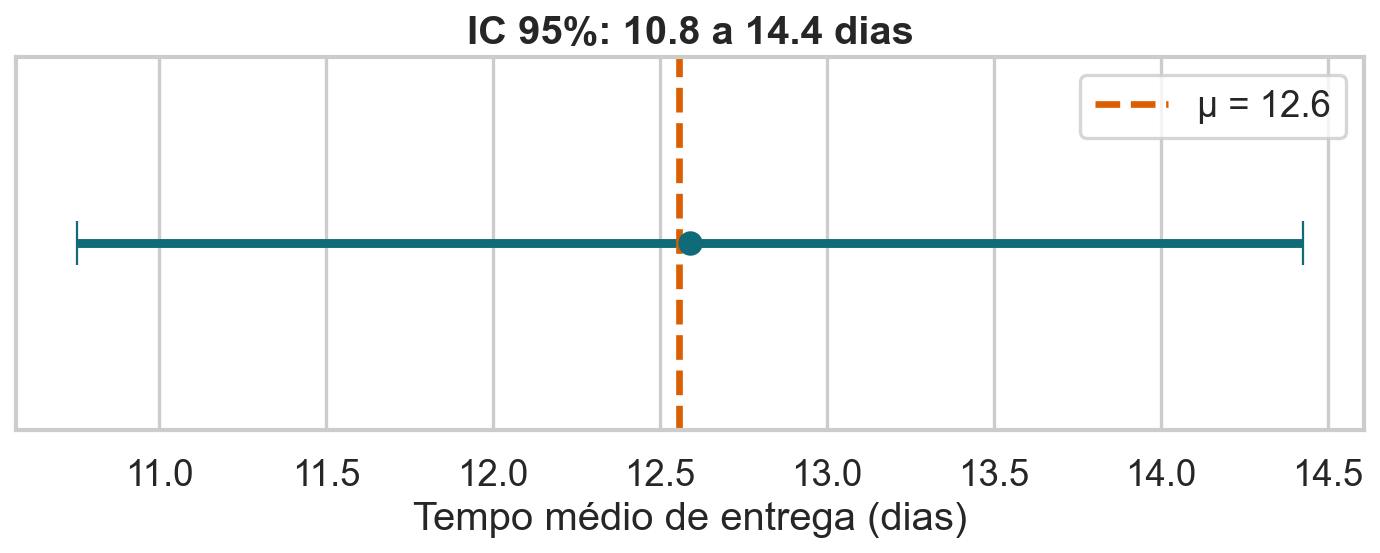
Esta amostra produziu um intervalo de aproximadamente 10,8 a 14,4 dias.
Há 95% de probabilidade de \(\mu\) estar no intervalo já calculado
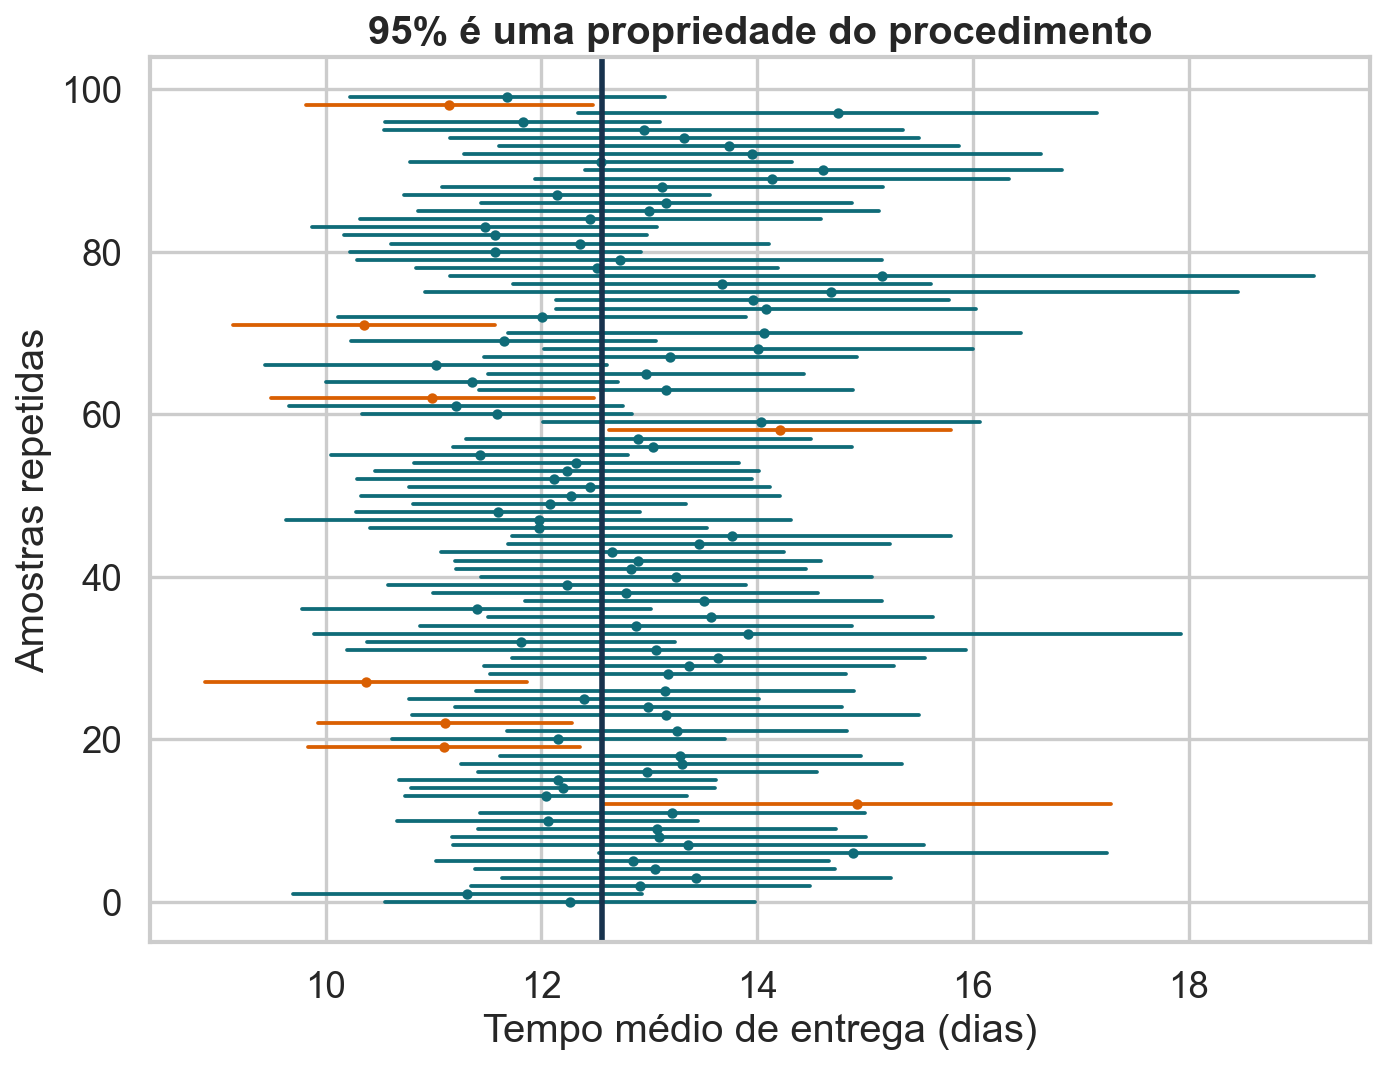
Em repetições, cerca de 95% dos intervalos construídos pelo procedimento cobrem \(\mu\)
95% dos dados individuais ficam dentro do intervalo
A confiança garante ausência de viés de seleção
O parâmetro não é aleatório
Depois de calcular o intervalo, \(\mu\) está ou não está dentro dele.
Evite dizer:
Há 95% de probabilidade de \(\mu\) estar neste intervalo.
Na interpretação frequentista, a aleatoriedade está no procedimento.
Confiança descreve repetição
Se repetíssemos a amostragem muitas vezes, cerca de 95% dos intervalos construídos pelo mesmo método cobririam \(\mu\).
Não esperamos que todos cubram o parâmetro.
Alguns intervalos falham
Os intervalos laranja são erros esperados do procedimento.
Código do gráfico
intervals = []for _ inrange(100): s = rng.choice(delivery, n_ci, replace=True) m = s.mean() se = s.std(ddof=1) / np.sqrt(n_ci) intervals.append((m -1.96* se, m +1.96* se, m))plt.figure(figsize=(9, 7))for i, (lo_i, hi_i, m_i) inenumerate(intervals): covered = lo_i <= mu <= hi_i color = BLUE if covered else ORANGE plt.plot([lo_i, hi_i], [i, i], color=color, lw=1.7) plt.scatter(m_i, i, color=color, s=10)plt.axvline(mu, color=INK, lw=2.5)plt.xlabel("Tempo médio de entrega (dias)")plt.ylabel("Amostras repetidas")plt.title("95% é uma propriedade do procedimento")finish("cobertura-intervalos.png")
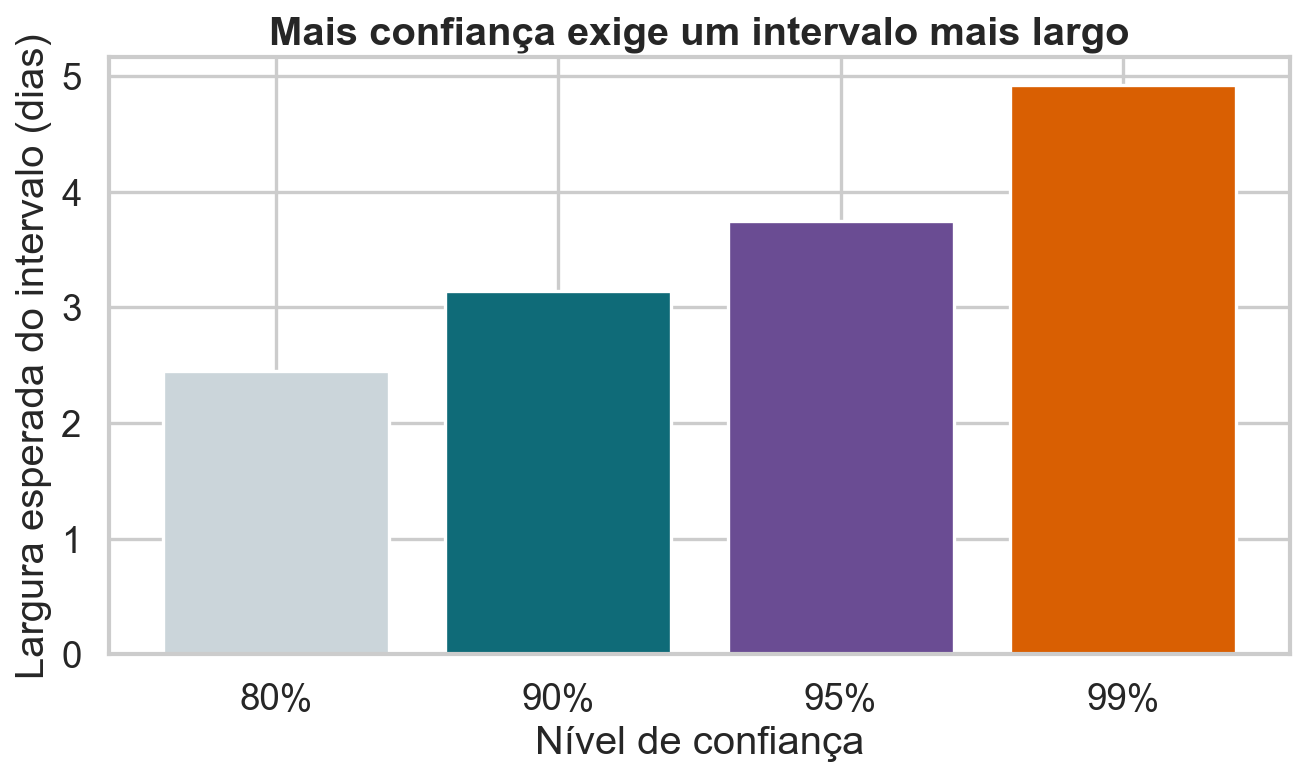
Mais confiança produz mais largura
Não ganhamos cobertura gratuitamente.
Código do gráfico
levels = np.array([0.80, 0.90, 0.95, 0.99])z_values = np.array([1.282, 1.645, 1.960, 2.576])widths =2* z_values * sigma / np.sqrt(100)plt.figure(figsize=(8.5, 5.2))plt.bar(["80%", "90%", "95%", "99%"], widths, color=[LIGHT, BLUE, PURPLE, ORANGE])plt.ylabel("Largura esperada do intervalo (dias)")plt.xlabel("Nível de confiança")plt.title("Mais confiança exige um intervalo mais largo")finish("confianca-largura.png")
Margem de erro
Para 95% de confiança:
\[
ME=1{,}96\frac{s}{\sqrt{n}}
\]
Ela diminui quando:
\(n\) aumenta;
a variabilidade dos dados diminui;
aceitamos menor nível de confiança.
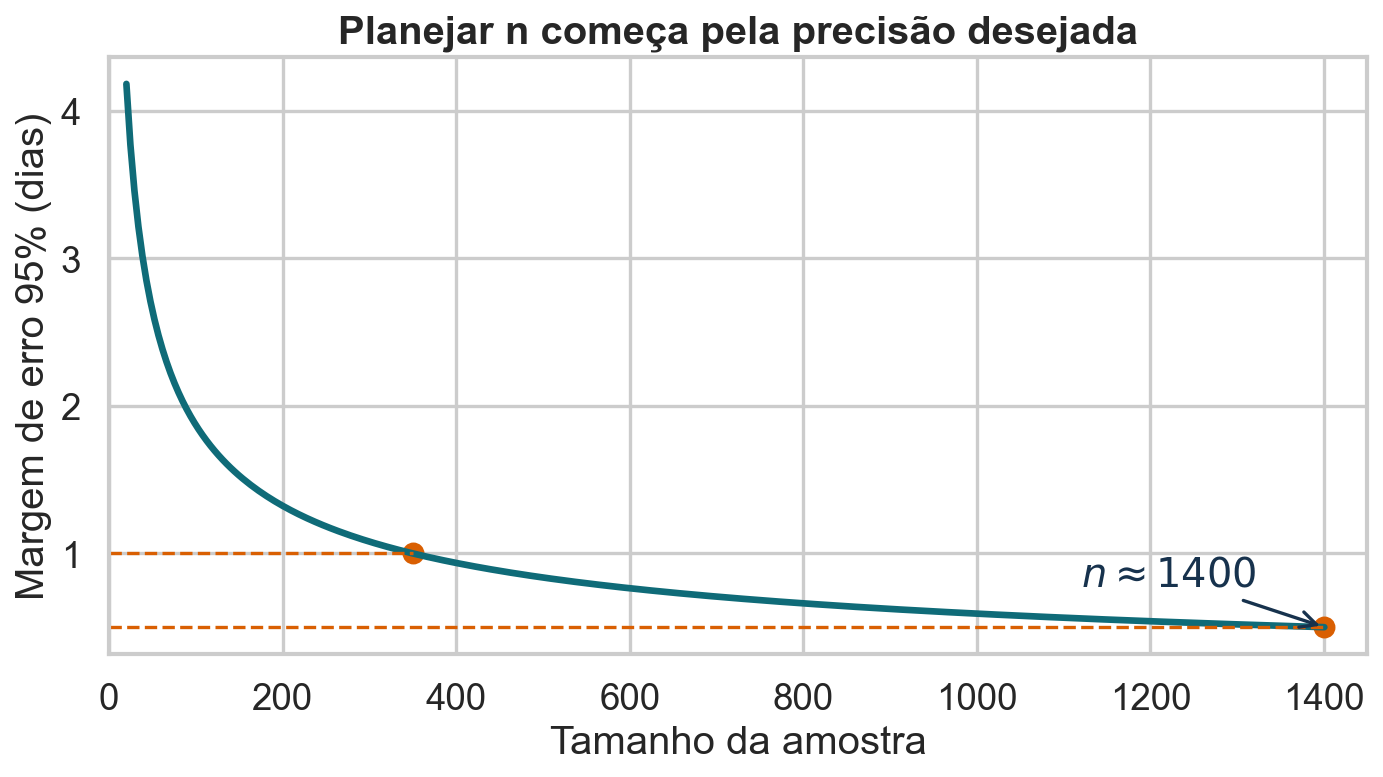
Planejar a amostra pela precisão
Dobrar a precisão exige aproximadamente quadruplicar \(n\).
Código do gráfico
need_half_day = (1.96* sigma /.5) **2ns_margin = np.linspace(20, need_half_day, 300)margin =1.96* sigma / np.sqrt(ns_margin)plt.figure(figsize=(9, 5.2))plt.plot(ns_margin, margin, color=BLUE, lw=3)for target in [1.0, .5]: need = (1.96* sigma / target) **2 plt.hlines(target, xmin=0, xmax=need, color=ORANGE, lw=1.5, ls="--") plt.scatter(need, target, color=ORANGE, s=70)plt.annotate(r"$n\approx 1400$", xy=(need_half_day, .5), xytext=(1120, .78), arrowprops={"arrowstyle": "->", "color": INK})plt.xlim(0, 1450)plt.xlabel("Tamanho da amostra")plt.ylabel("Margem de erro 95% (dias)")plt.title("Planejar n começa pela precisão desejada")finish("margem-tamanho-ate-1400.png")
Como \(\sigma_D\) é desconhecido, usamos \(s_D\). Sob diferenças Normais, \(T=(\bar D-\mu_D)/(s_D/\sqrt n)\) segue \(t_{n-1}\), que tem caudas mais pesadas.
Quando \(t\) se aproxima da Normal?
À medida que \(n\) cresce, \(t_{n-1}\to N(0,1)\). Para \(n>30\), \(t^*\) já costuma ser próximo de \(z^*\); em 95%, \(t^*_{29}=2{,}045\) e \(z^*=1{,}96\).
As duas medidas do par podem ser dependentes; as diferenças \(D_1,\ldots,D_n\) devem ser independentes entre pares.
Exemplo numérico pareado
Cinco pedidos têm prazo estimado \(X_i\) e tempo efetivo \(Y_i\), em dias. Definimos \(D_i=Y_i-X_i\).
IC de 95%:\(13{,}1\pm1{,}96(0{,}9)=13{,}1\pm1{,}764\), portanto \([11{,}34;14{,}86]\) dias.
Interpretação: usando um procedimento que cobre \(\mu\) em cerca de 95% das repetições, estimamos o tempo médio populacional entre 11,34 e 14,86 dias.
Metade da margem: mantendo variabilidade e confiança, precisamos de aproximadamente \(4n=400\) pedidos.
Maior preocupação: os 100 pedidos precisam representar a população-alvo e fornecer observações aproximadamente independentes. Concentração em poucos vendedores ou períodos viola essa condição.
O que aprendemos
O TCL descreve a distribuição amostral da média.
O erro padrão mede a variação entre amostras.
Um IC combina estimativa, erro padrão e valor crítico.
Confiança é cobertura em repetições.
Precisão depende de variabilidade, \(n\) e confiança.
Próxima aula
Um intervalo mostra valores plausíveis. Como avaliar uma afirmação específica?
Na Aula 11, construiremos testes de hipóteses, p-valores e poder estatístico.
Fonte dos dados
Brazilian E-Commerce Public Dataset by Olist, Kaggle: olistbr/brazilian-ecommerce.
Cerca de 100 mil pedidos reais e anonimizados, de 2016 a 2018.
Material conceitual adaptado do PDF fornecido para a disciplina.