Aula 16 — Módulo 3: Modelagem e Aprendizado de Máquina
Idade, índice de massa corporal e despesas médicas parecem associados.
Mas precisamos separar quatro perguntas:
Usaremos Medical Insurance Cost, disponível no Kaggle sob licença CC0.
charges;Fonte: Kaggle, mosapabdelghany/medical-insurance-cost-dataset.
Cada linha representa uma pessoa segurada.
| coluna | significado |
|---|---|
age |
idade em anos |
sex |
sexo registrado |
bmi |
índice de massa corporal |
children |
dependentes cobertos |
smoker |
tabagismo: sim ou não |
region |
região dos Estados Unidos |
charges |
despesas médicas cobradas em US$ |
Uma correlação só é interpretável depois que unidade, população e qualidade dos dados estão claras.
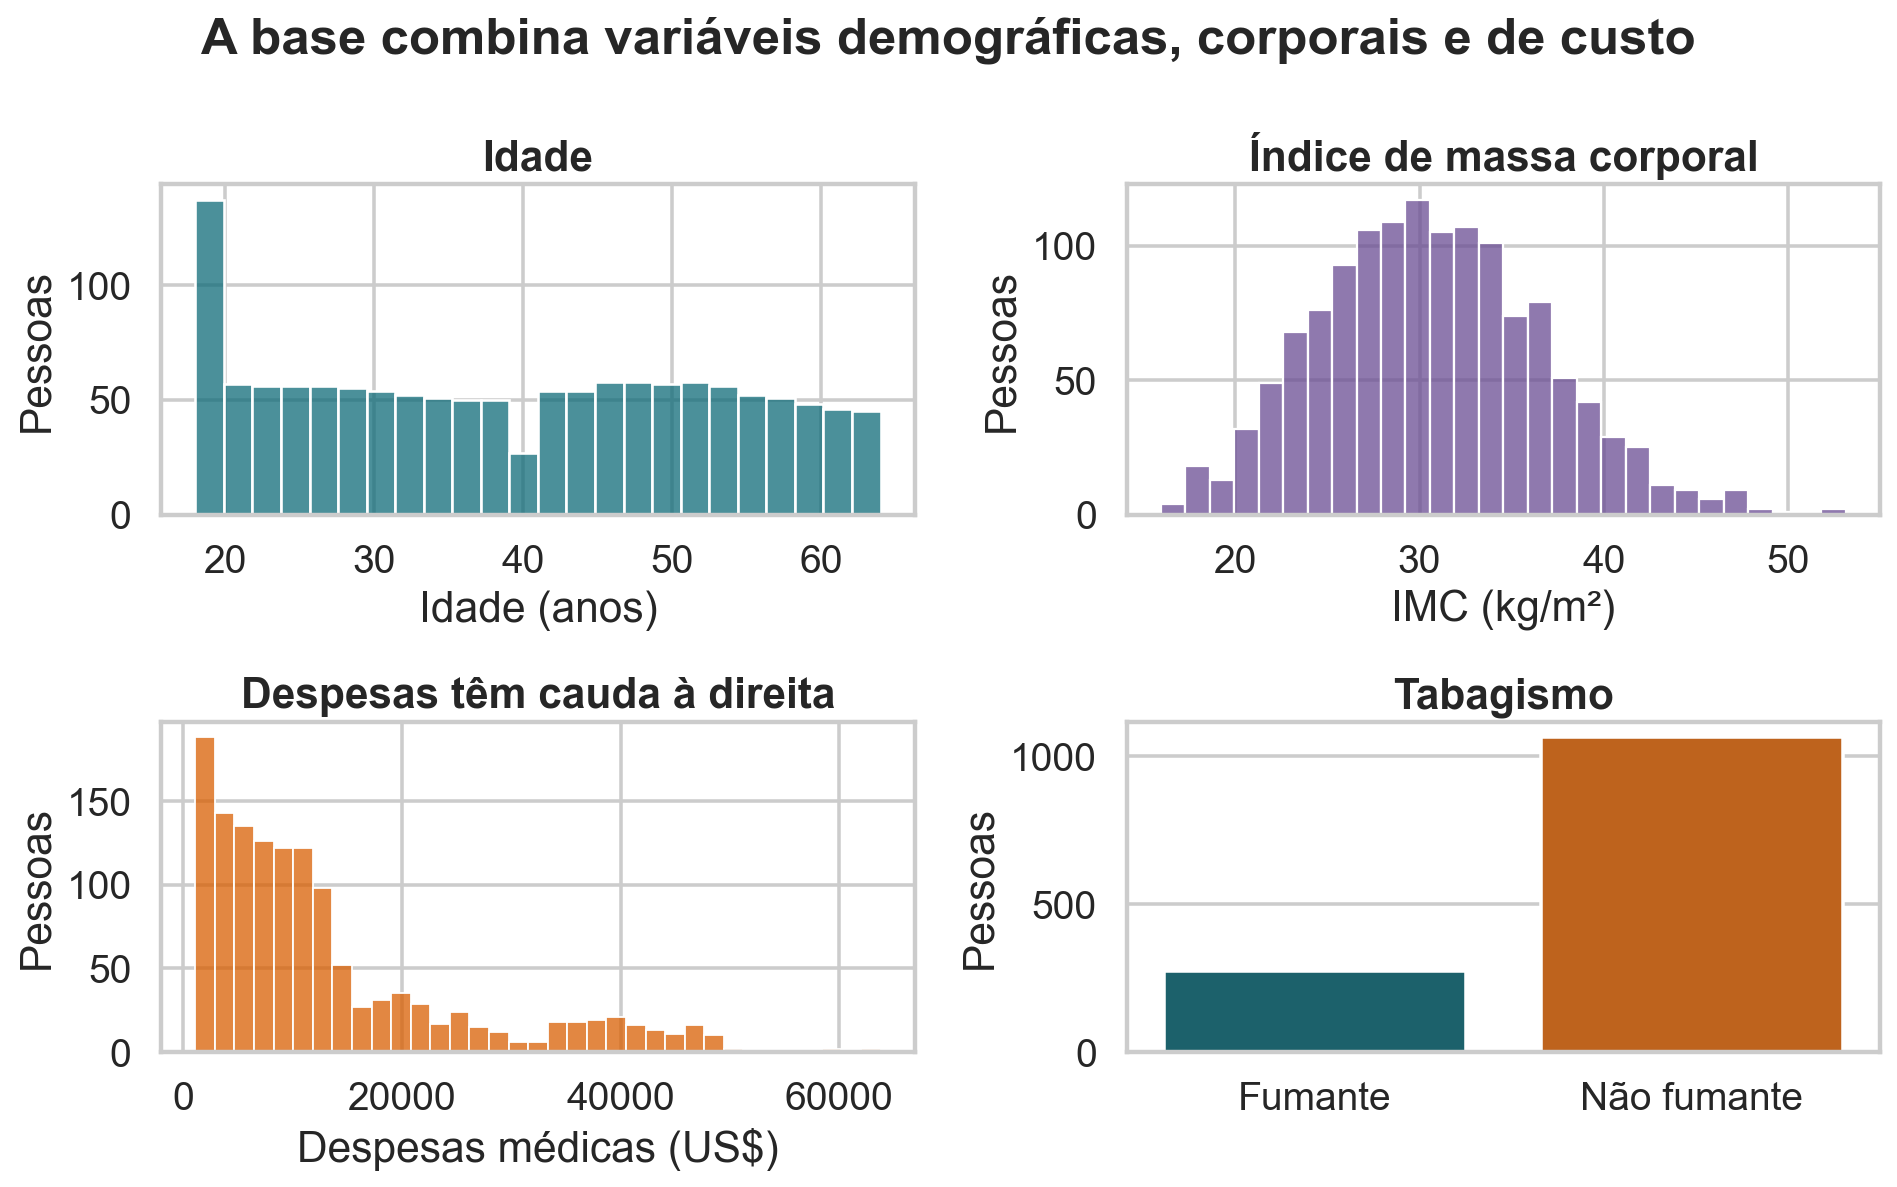
As despesas têm forte cauda à direita. Médias, dispersões e correlações podem ser influenciadas pelas observações mais altas.
| grupo | pessoas | despesa média | mediana |
|---|---|---|---|
| não fumantes | 1.064 | US$ 8.434 | US$ 7.345 |
| fumantes | 274 | US$ 32.050 | US$ 34.456 |
Tabagismo está fortemente associado a despesas. Ignorar esse agrupamento pode misturar relações diferentes.
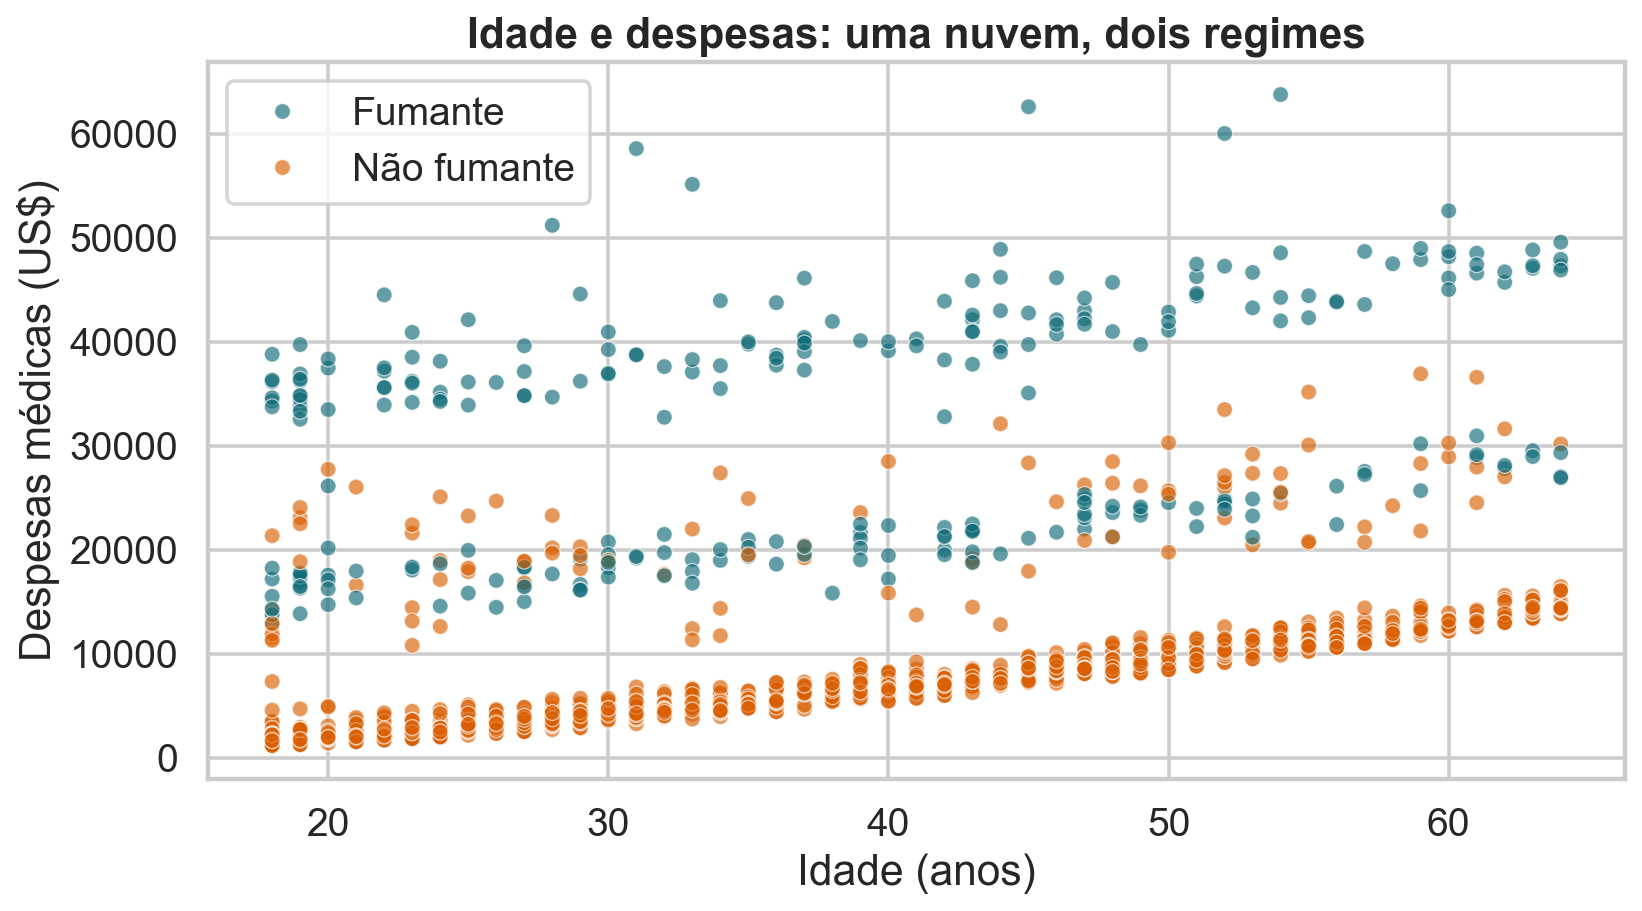
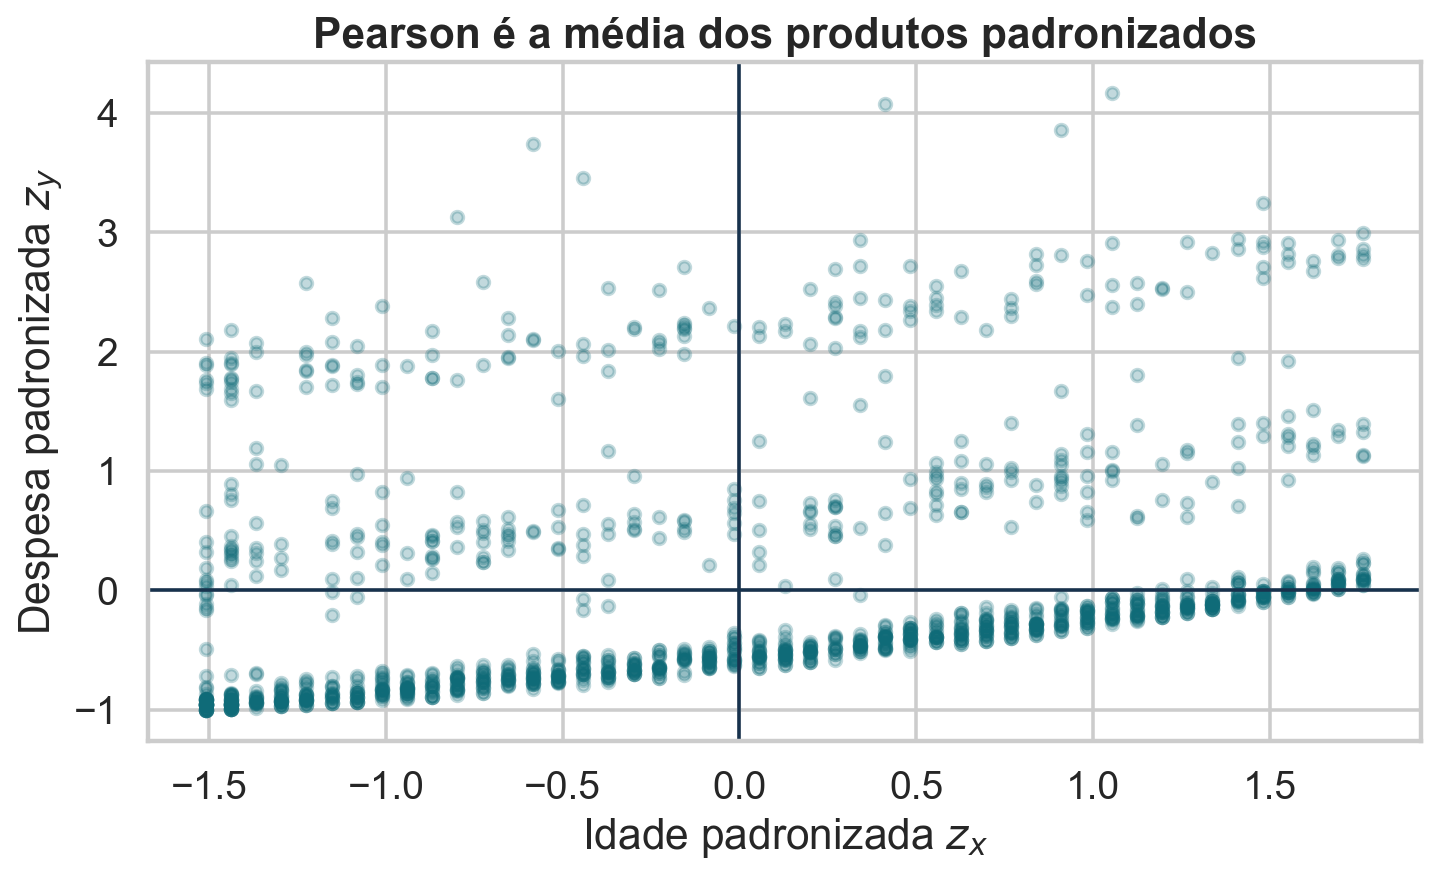
Existe tendência crescente com a idade, mas os fumantes ocupam outro patamar de despesas.
Para duas variáveis quantitativas \(X\) e \(Y\), queremos uma medida que registre:
O gráfico de dispersão vem antes do coeficiente.
Para uma amostra \(x_1,\ldots,x_n\):
\[ s_X^2=\frac{1}{n-1}\sum_{i=1}^{n}(x_i-\bar x)^2. \]
A variância mede a dispersão de uma variável.
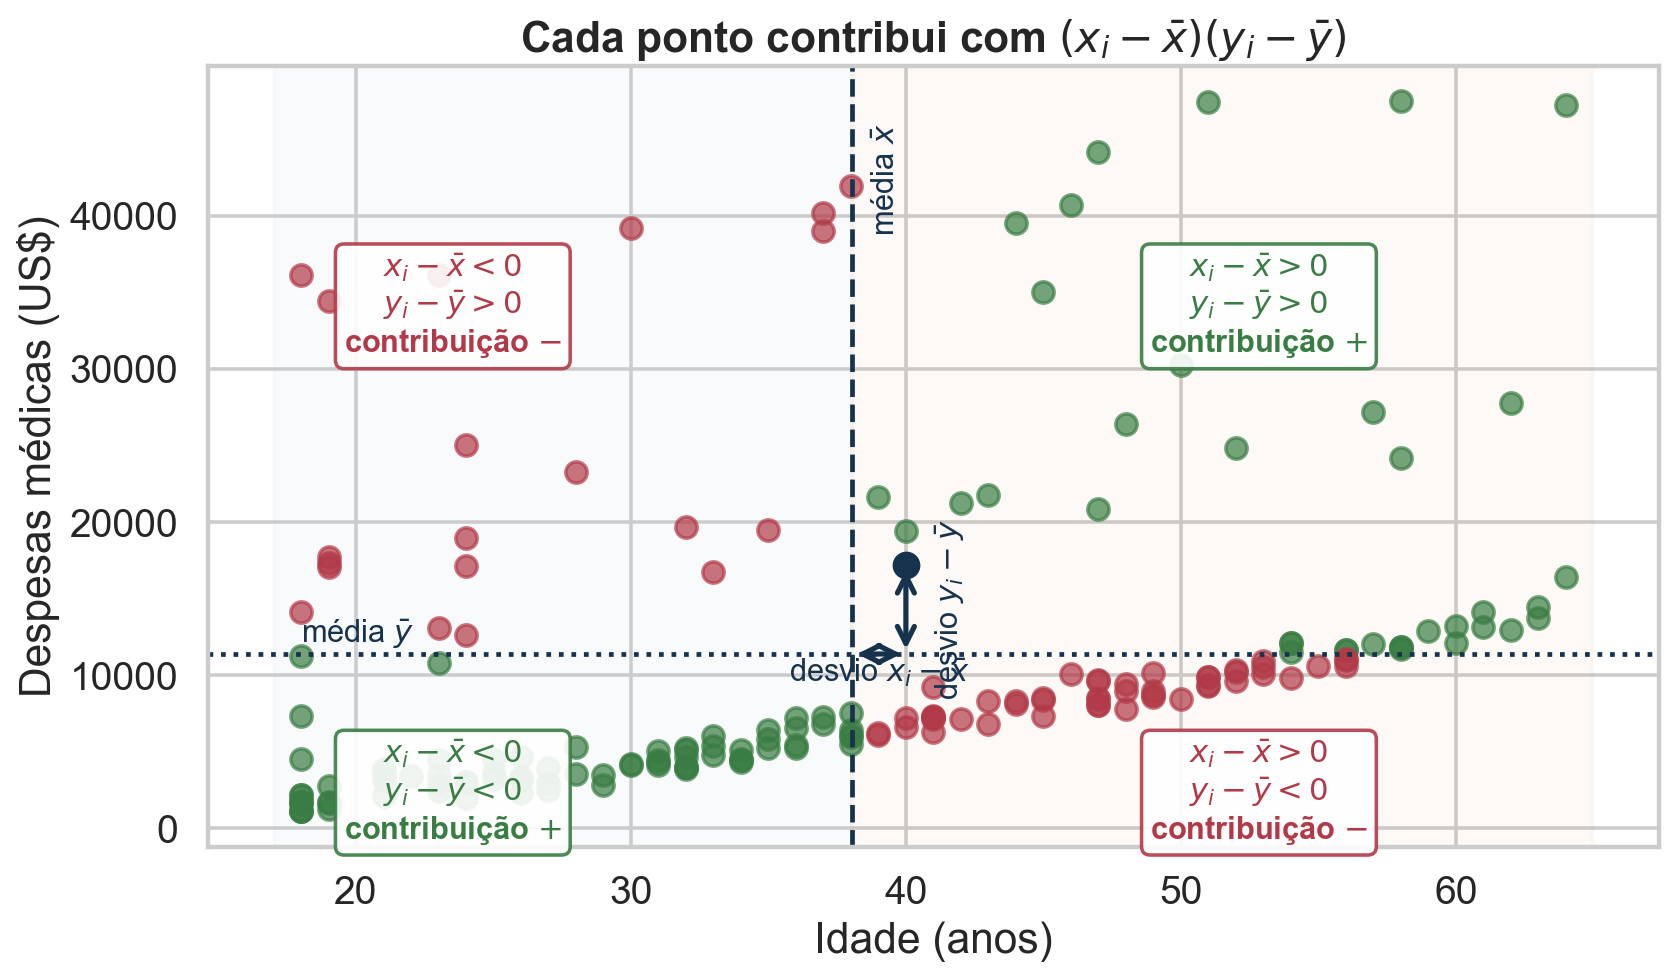
Para cada pessoa \(i\), considere:
\[ (x_i-\bar x)(y_i-\bar y). \]
Somar esses produtos mede variação conjunta.
Para pares \((x_i,y_i)\), a covariância amostral é:
\[ s_{XY}=\frac{1}{n-1}\sum_{i=1}^{n}(x_i-\bar x)(y_i-\bar y). \]
Covariância zero não implica independência.
Considere \(x=(1,2,3)\) e \(y=(2,1,5)\):
\[ \bar x=2,\qquad \bar y=\frac83. \]
\[ \sum_i(x_i-\bar x)(y_i-\bar y) =(-1)\left(-\frac23\right)+0\left(-\frac53\right)+1\left(\frac73\right)=3. \]
Logo,
\[ s_{XY}=\frac{3}{3-1}=1{,}5. \]
A unidade da covariância é o produto das unidades:
\[ [s_{XY}]=[X]\,[Y]. \]
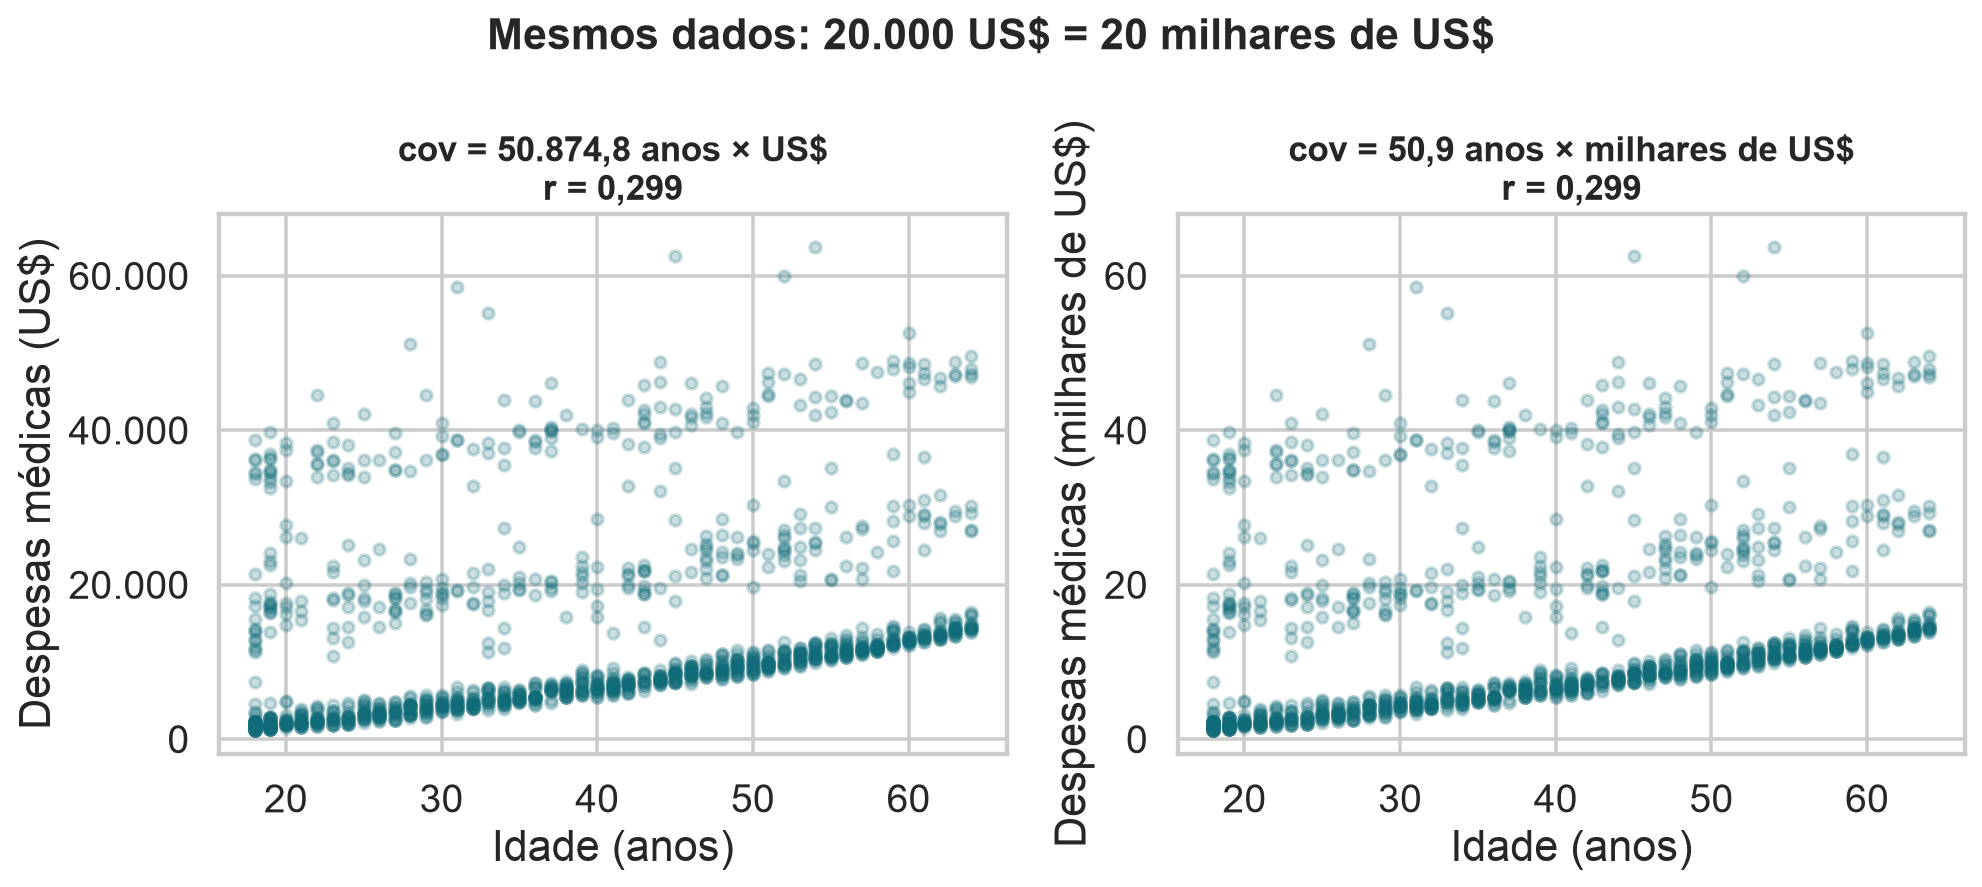
Idade em anos e despesas em dólares produzem ano × dólar. Se despesas forem expressas em milhares de dólares, a covariância é dividida por mil, embora a nuvem seja a mesma.
Precisamos retirar a escala.
À esquerda, despesas em US$; à direita, em milhares de US$. Dividir \(Y\) por 1.000 divide a covariância por 1.000, mas mantém a correlação e o padrão da nuvem.
A correlação amostral de Pearson é:
\[ r_{XY}=\frac{s_{XY}}{s_Xs_Y} =\frac{\sum_i(x_i-\bar x)(y_i-\bar y)} {\sqrt{\sum_i(x_i-\bar x)^2}\sqrt{\sum_i(y_i-\bar y)^2}}. \]
Defina os vetores centrados:
\[ \mathbf{x}_c=(x_1-\bar x,\ldots,x_n-\bar x), \qquad \mathbf{y}_c=(y_1-\bar y,\ldots,y_n-\bar y). \]
Então:
\[ r=\frac{\mathbf{x}_c^\top\mathbf{y}_c} {\|\mathbf{x}_c\|\,\|\mathbf{y}_c\|}. \]
Pela desigualdade de Cauchy–Schwarz, \(|\mathbf{x}_c^\top\mathbf{y}_c|\leq\|\mathbf{x}_c\|\|\mathbf{y}_c\|\); portanto \(|r|\leq1\).
Na expressão anterior,
\[ r=\cos(\theta), \]
onde \(\theta\) é o ângulo entre os vetores centrados.
Essa geometria descreve associação linear, não causalidade.
Com \(z_{xi}=(x_i-\bar x)/s_X\) e \(z_{yi}=(y_i-\bar y)/s_Y\):
\[ r=\frac{1}{n-1}\sum_{i=1}^n z_{xi}z_{yi}. \]
| valor de \(r\) | leitura linear |
|---|---|
| próximo de \(+1\) | forte associação positiva |
| próximo de \(-1\) | forte associação negativa |
| próximo de \(0\) | associação linear fraca |
Não há cortes universais para “fraco”, “moderado” ou “forte”. A relevância depende do domínio, da qualidade da medida e da decisão.
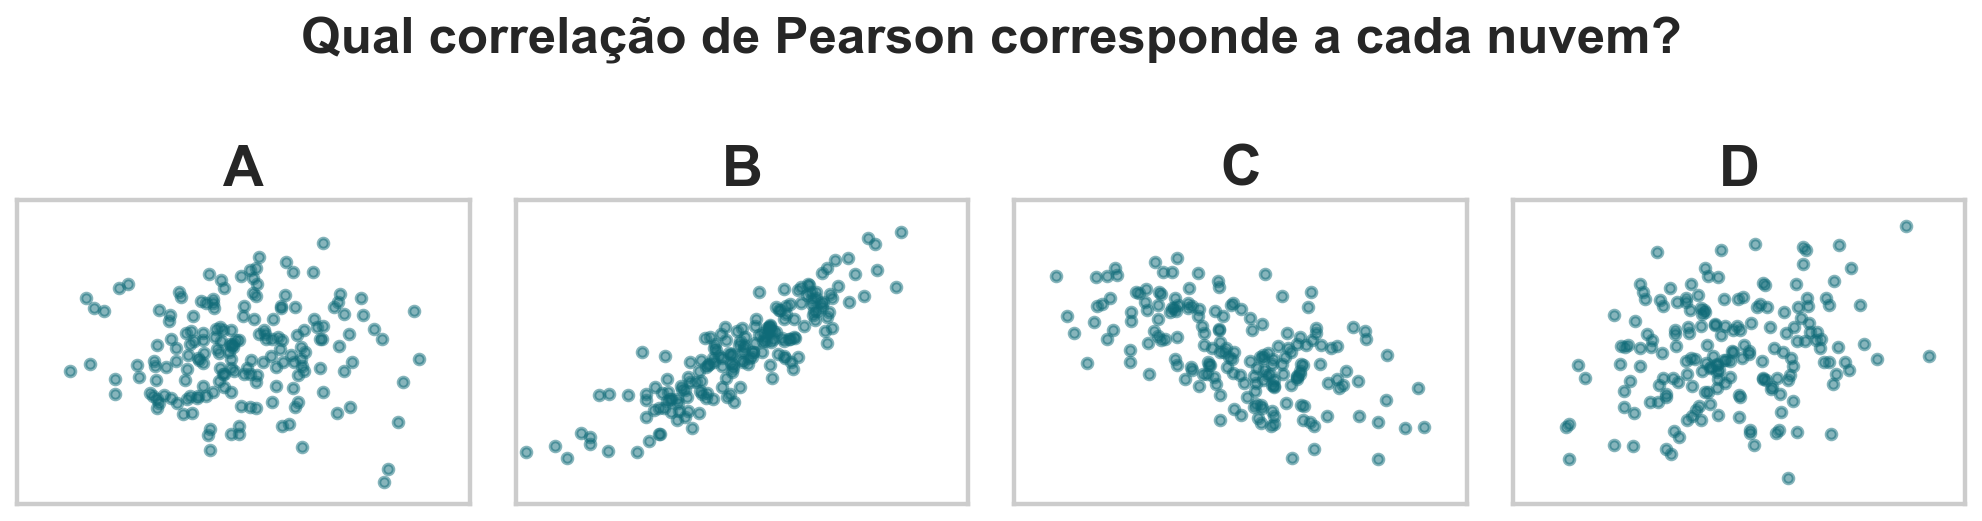
Qual associação é a mais compatível com as figuras?
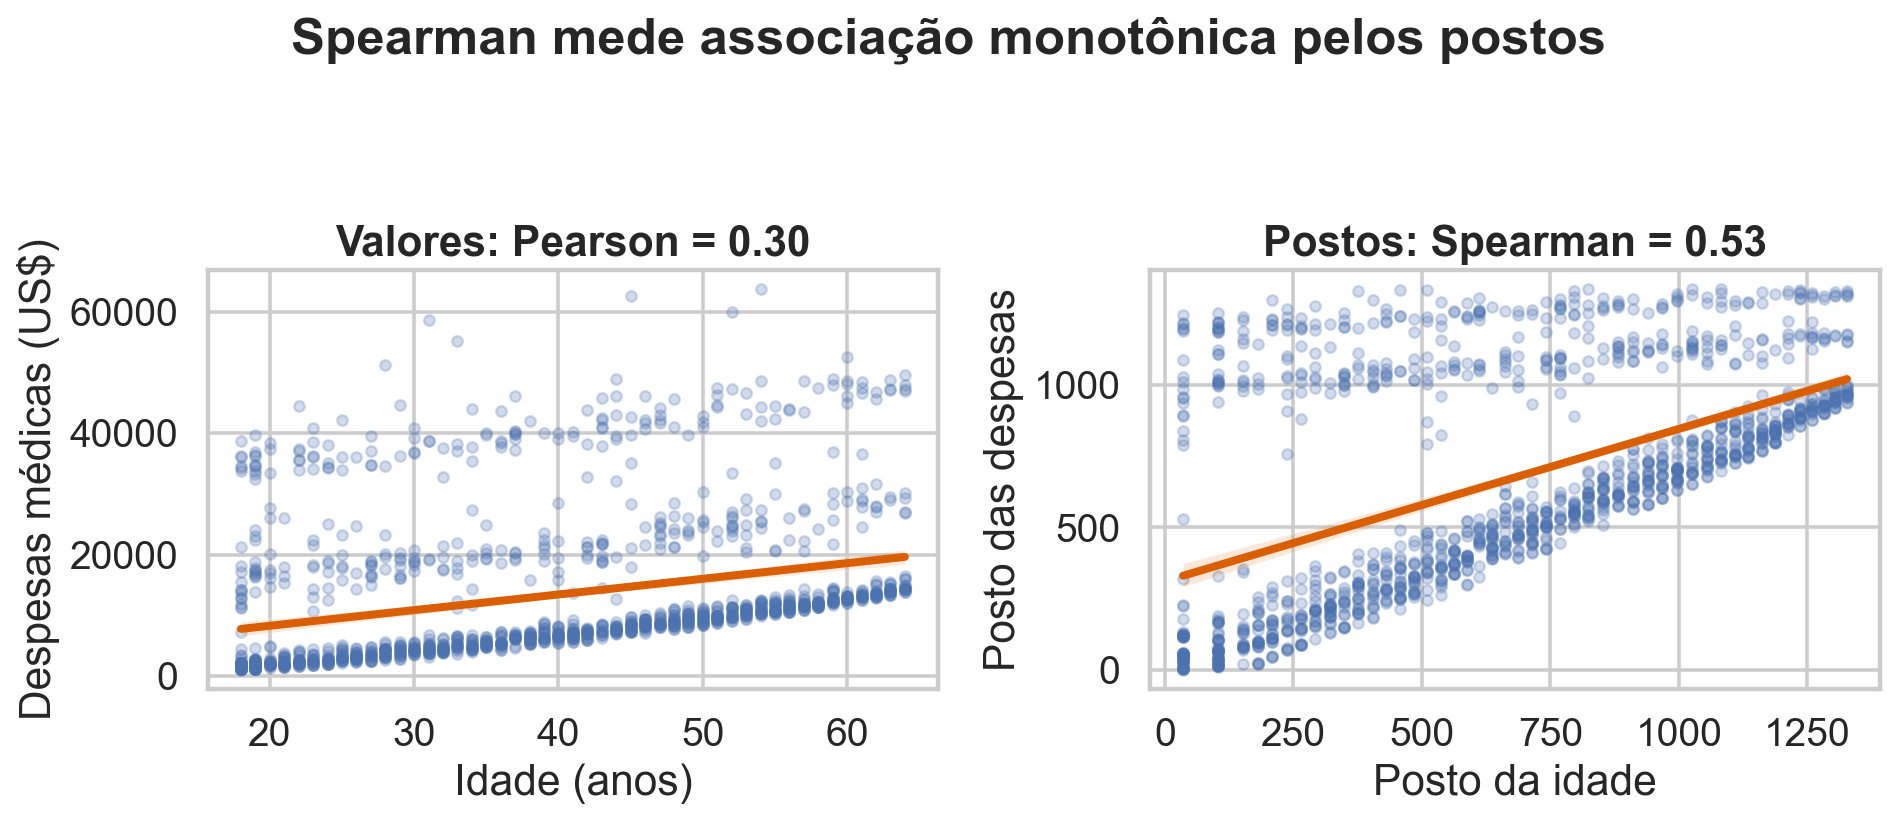
O sinal positivo indica que despesas tendem a crescer com a idade. A magnitude global é modesta porque:
O coeficiente não substitui a figura.
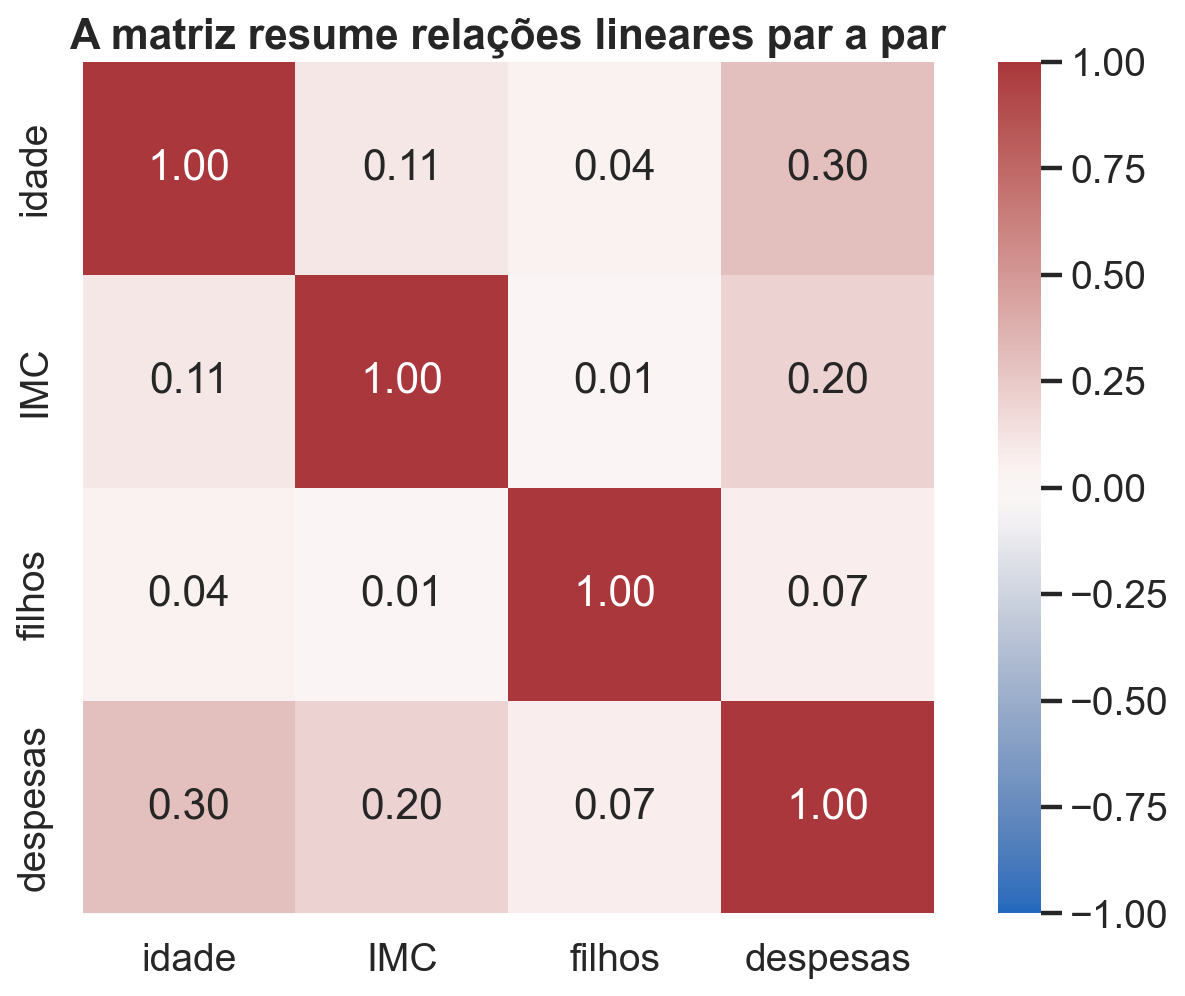
Cada célula descreve apenas uma relação linear par a par. A matriz não controla outras variáveis e não inclui categorias sem codificação.
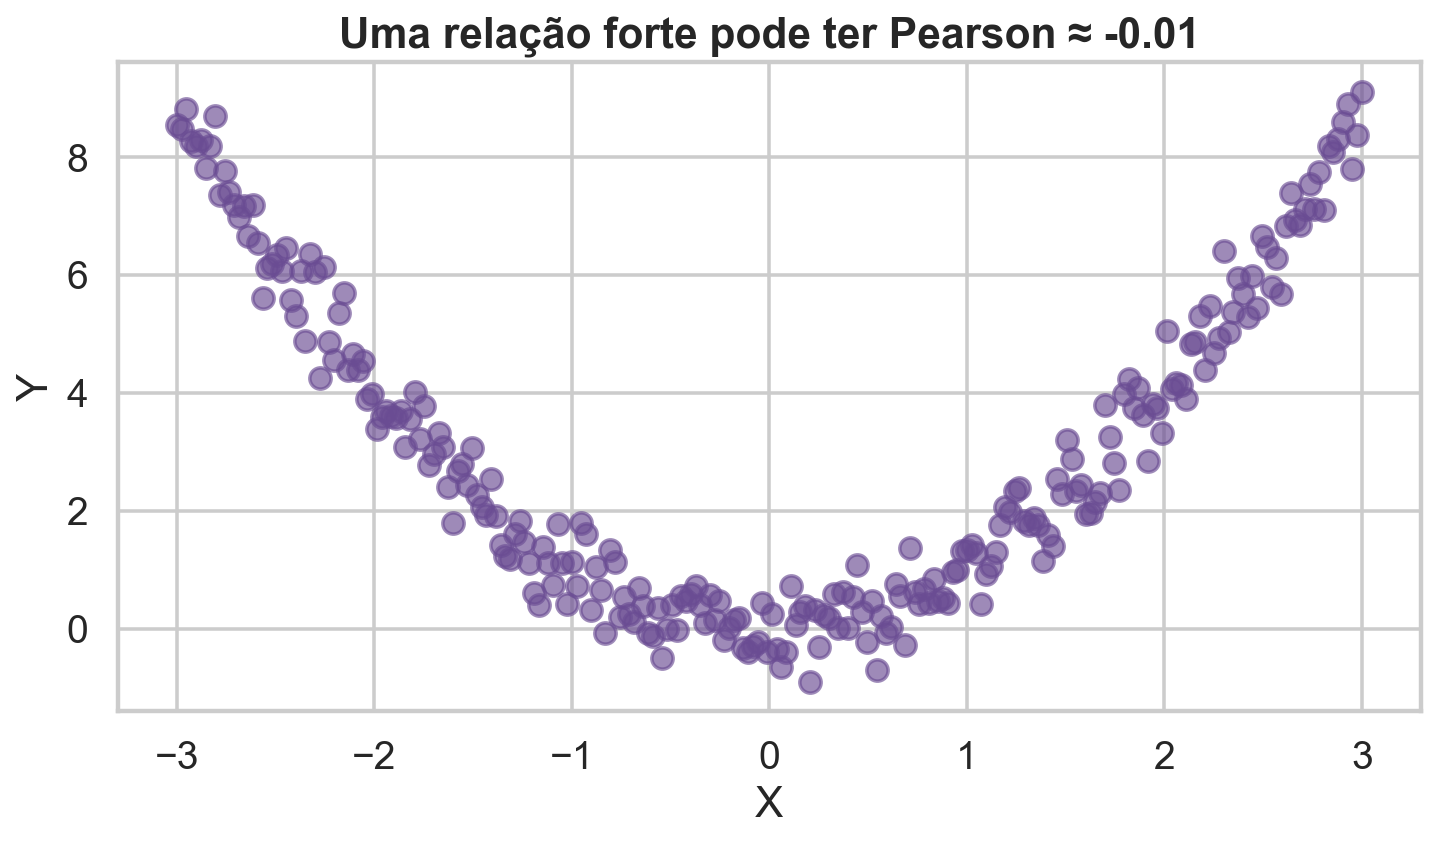
Pearson é grande quando os pontos se aproximam de uma relação afim:
\[ Y\approx a+bX. \]
Ele pode ser pequeno quando:
Aqui \(Y\approx X^2\), mas os braços esquerdo e direito cancelam a tendência linear.
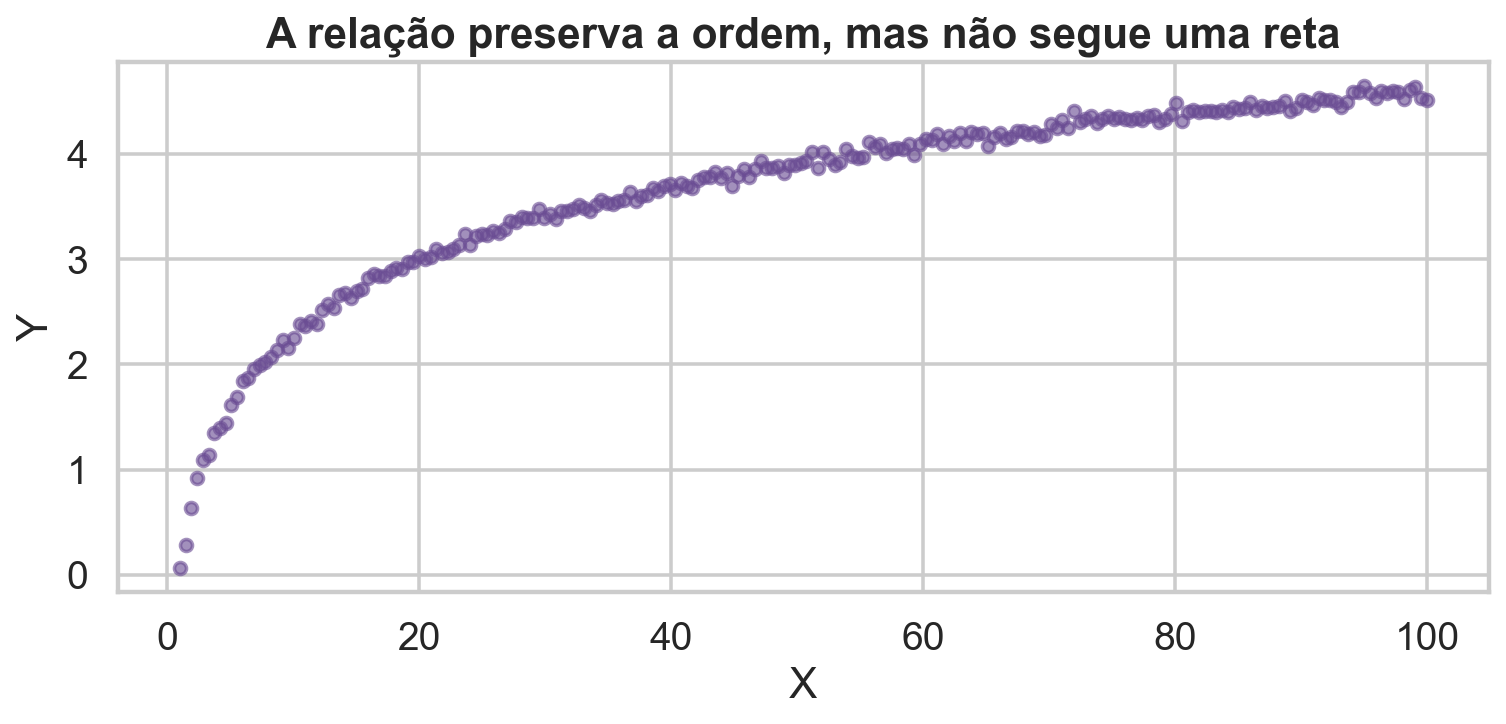
O posto é a posição de uma observação depois de ordenar os valores do menor para o maior.
Se \(R_i=\operatorname{rank}(x_i)\) e \(S_i=\operatorname{rank}(y_i)\), então:
\[ r_S=\operatorname{cor}(R,S). \]
Assim, Spearman mede se as duas variáveis preservam uma ordenação semelhante.
| pessoa \(i\) | \(x_i\) | posto \(R_i\) | \(y_i\) | posto \(S_i\) | \(d_i=R_i-S_i\) | \(d_i^2\) |
|---|---|---|---|---|---|---|
| 1 | 10 | 1 | 12 | 2 | −1 | 1 |
| 2 | 20 | 2 | 8 | 1 | 1 | 1 |
| 3 | 30 | 3 | 15 | 3 | 0 | 0 |
| 4 | 40 | 4 | 20 | 4 | 0 | 0 |
Os valores numéricos são substituídos por suas posições. Aqui, \(\sum_i d_i^2=2\): apenas as duas primeiras observações trocam de ordem.
Quando não existem valores empatados:
\[ r_S=1-\frac{6\sum_{i=1}^{n}d_i^2}{n(n^2-1)}, \qquad d_i=R_i-S_i. \]
No exemplo, \(n=4\) e \(\sum_i d_i^2=2\):
\[ r_S=1-\frac{6\cdot2}{4(4^2-1)} =1-\frac{12}{60}=0{,}80. \]
Quanto menores as diferenças entre os postos, mais próximo \(r_S\) fica de 1.
Na base: Pearson \(=0{,}30\) e Spearman \(=0{,}53\). A ordenação por idade acompanha melhor a ordenação por despesas do que uma única reta acompanha os valores em dólares.
Idade é registrada em anos inteiros, portanto muitas pessoas empatam.
Para valores \((18,18,19,21)\), os postos seriam:
\[ (1{,}5,1{,}5,3,4). \]
Os dois valores 18 ocupam as posições 1 e 2 e recebem o posto médio \((1+2)/2=1{,}5\).
Bibliotecas como scipy.stats.spearmanr tratam empates dessa forma.
Com empates, use a definição geral \(r_S=\operatorname{cor}(R,S)\); a fórmula abreviada baseada apenas em \(\sum d_i^2\) precisa de correções e não deve ser aplicada diretamente.
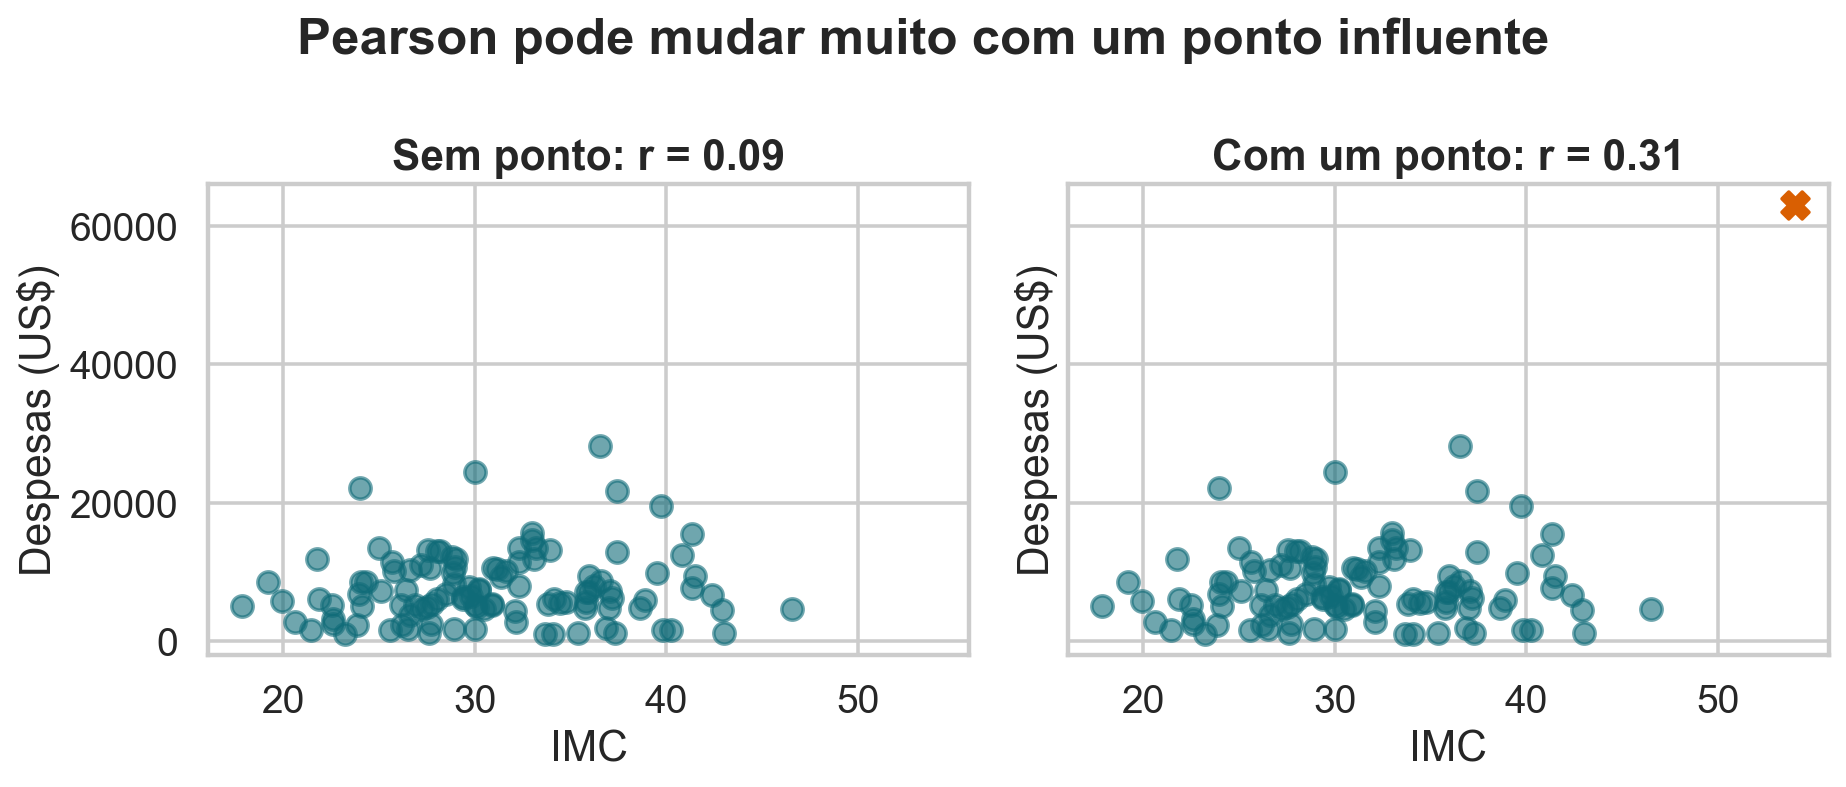
Um único ponto distante pode aumentar ou reduzir \(r\). Removê-lo só é defensável com justificativa substantiva ou erro documentado.
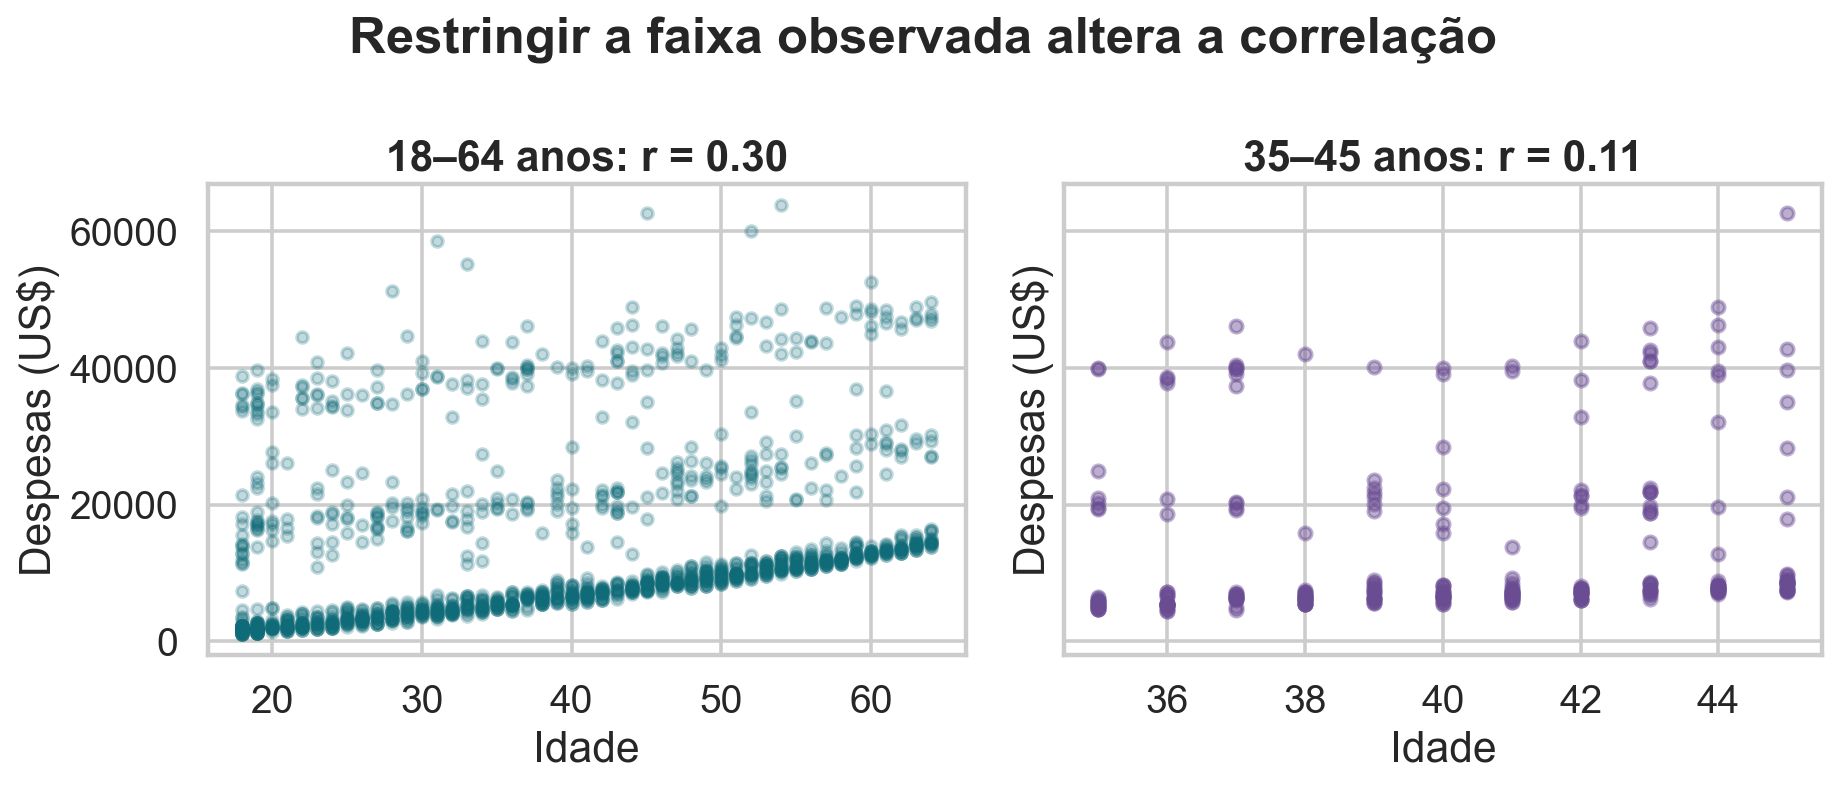
Selecionar apenas uma faixa estreita de idade remove parte da variação necessária para enxergar associação.
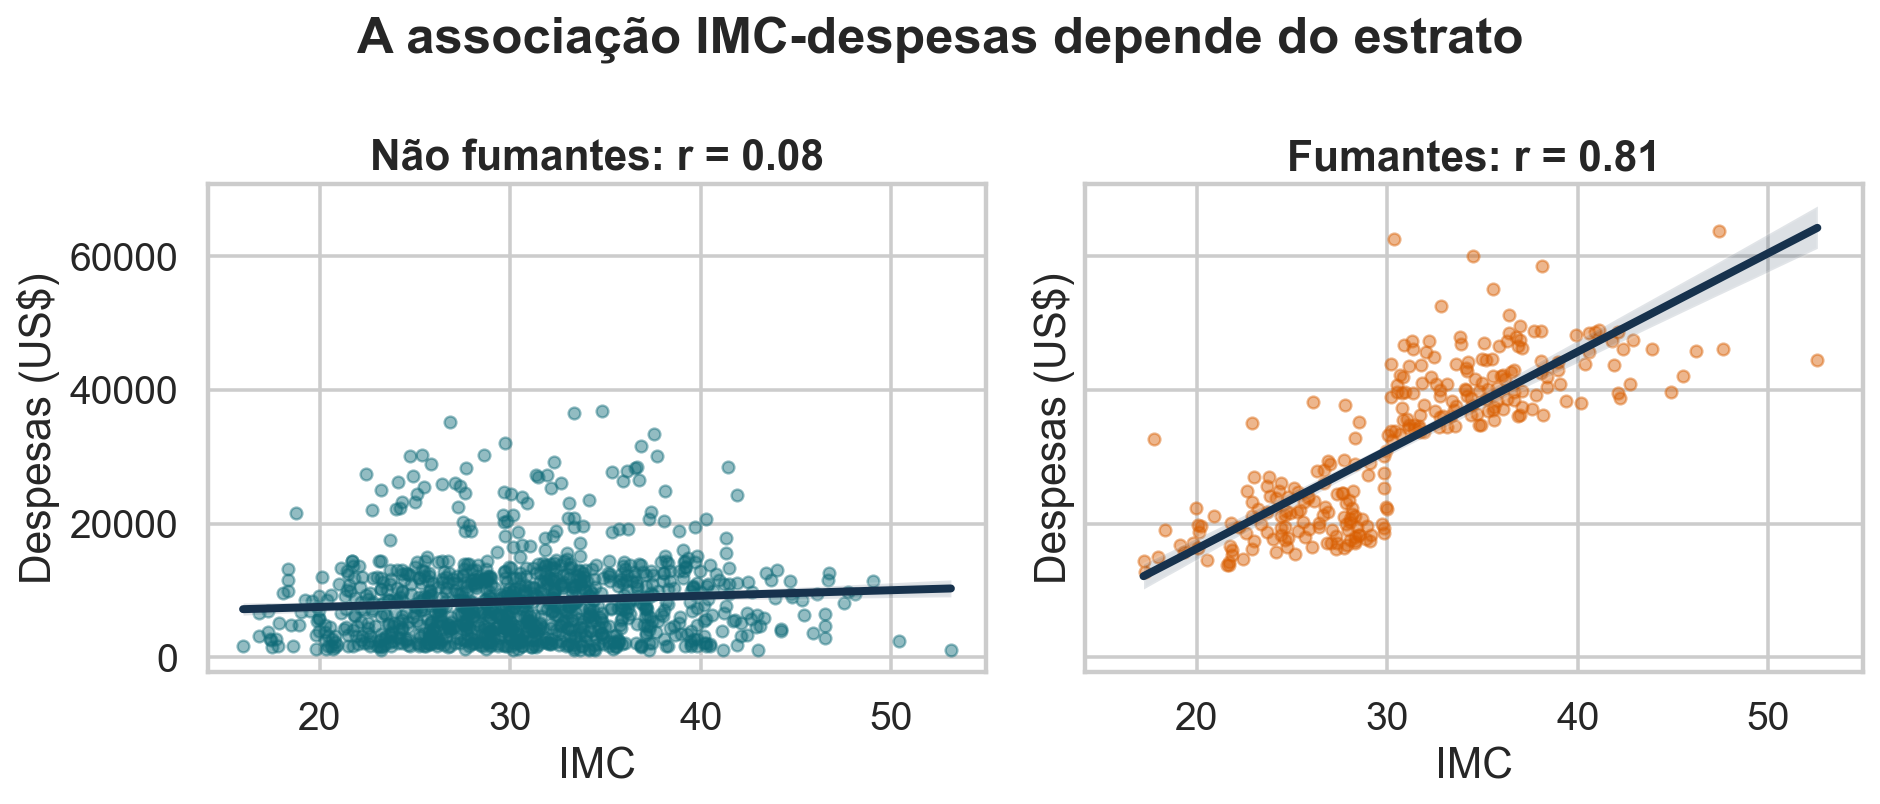
Para IMC e despesas, a correlação global é:
\[ r_{\text{global}}=0{,}20. \]
Mas tabagismo altera drasticamente tanto o nível das despesas quanto a associação com IMC. Uma única correlação marginal combina:
Na base de seguros, separar os grupos revelou associações diferentes. Será que misturar grupos pode até inverter o sinal da correlação?
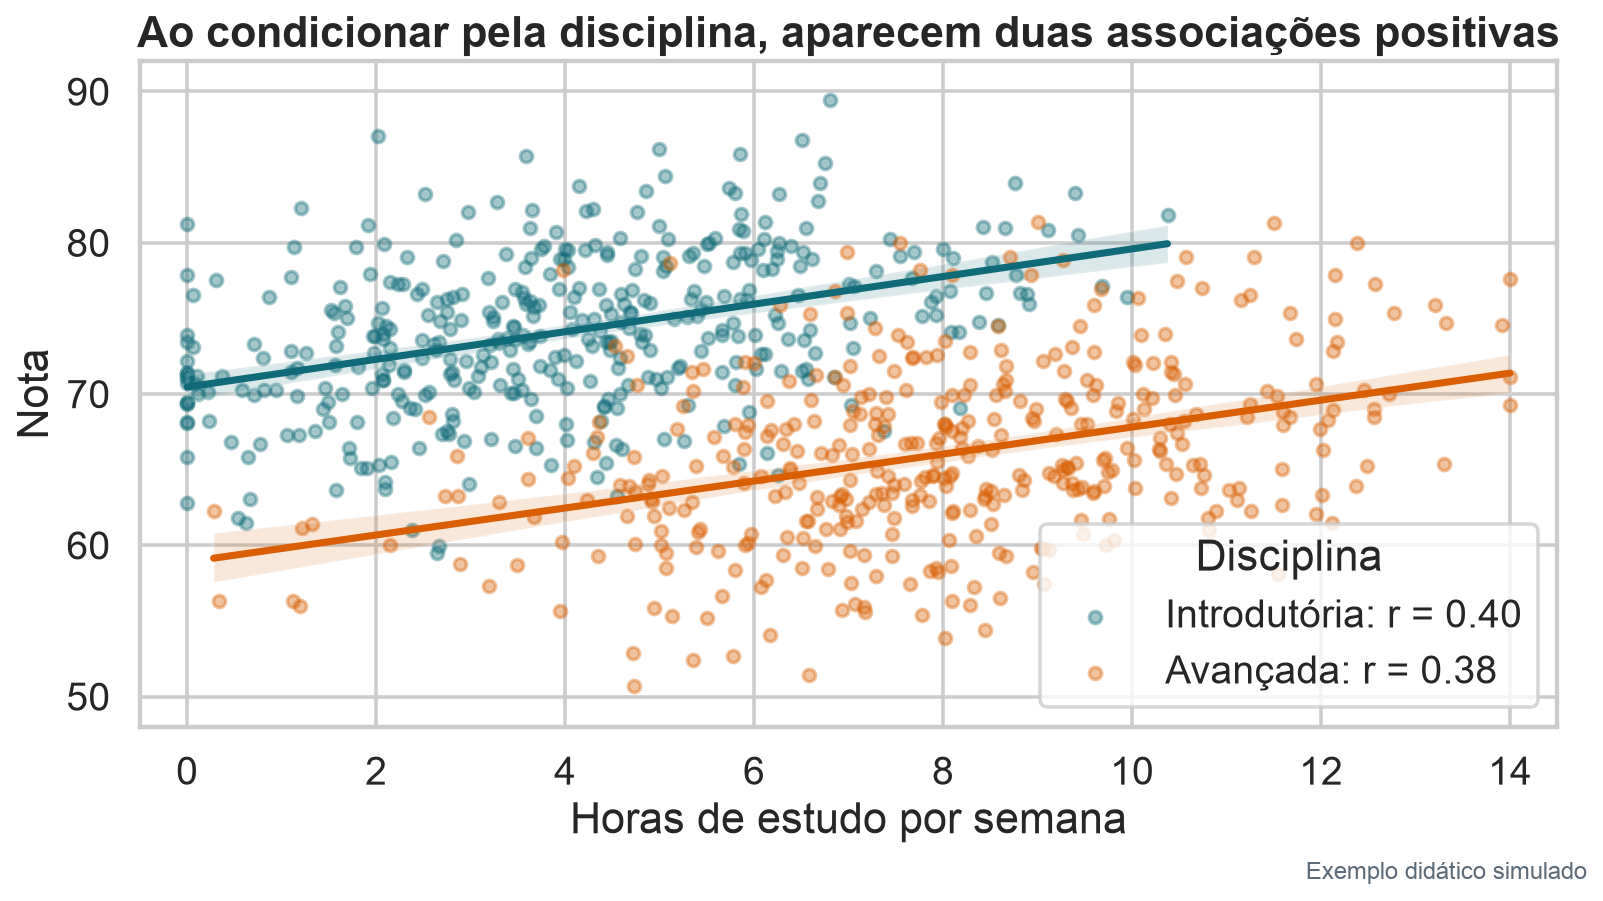
Vamos investigar com dados simulados de 800 estudantes, divididos igualmente entre uma disciplina introdutória e uma avançada.
O exemplo é didático: não representa uma pesquisa real nem permite concluir que estudar mais causa determinada nota.
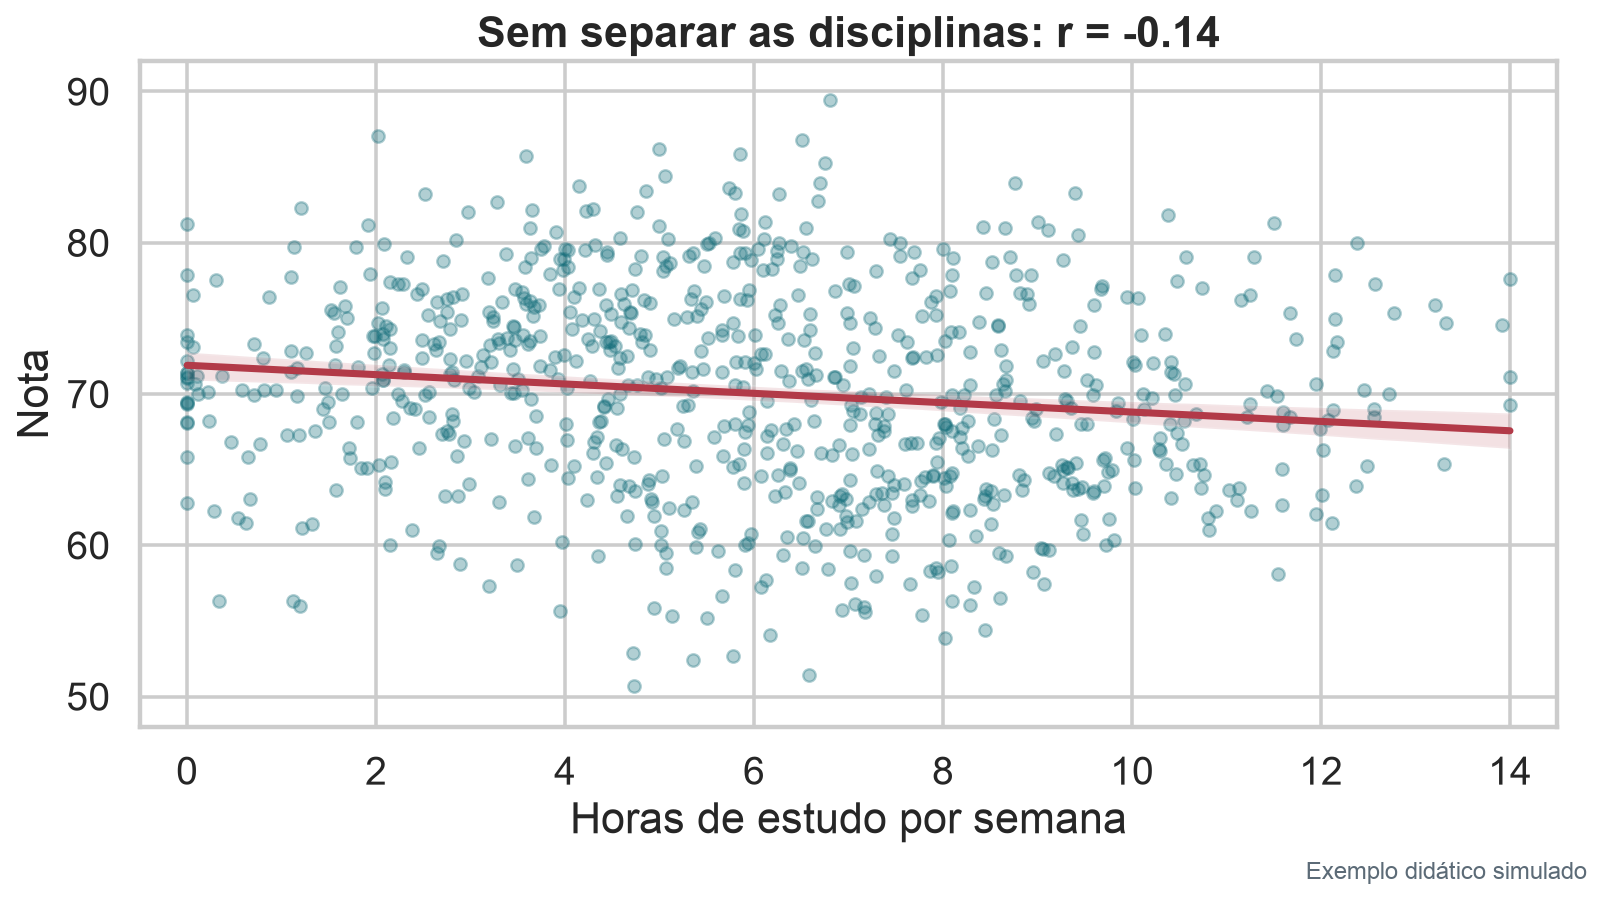
Todos os estudantes juntos:
\[r_{\text{horas, nota}}=-0{,}14\]
Resume a nuvem sem considerar a disciplina.
Dentro de cada disciplina:
\[r_{\text{intro}}=0{,}40,\qquad r_{\text{avançada}}=0{,}38\]
Resume a relação entre horas e nota dentro de cada disciplina.
Separar por disciplina pode revelar uma relação que fica escondida nos dados agregados. Essa comparação, por si só, não demonstra que estudar mais causa notas maiores.
Primeiro, reunimos os 800 estudantes sem distinguir a disciplina. Cada ponto representa um estudante.
Sem distinguir as disciplinas, quem estuda mais parece obter notas menores: \(r=-0{,}14\).
sim_rng = np.random.default_rng(1616)
x_intro = np.clip(sim_rng.normal(4.0, 2.3, 400), 0, 14)
y_intro = 74 + .8*(x_intro-4.0) + sim_rng.normal(0, 5, 400)
x_advanced = np.clip(sim_rng.normal(8.0, 2.3, 400), 0, 14)
y_advanced = 66 + .8*(x_advanced-8.0) + sim_rng.normal(0, 5, 400)
simpson = pd.DataFrame({
"horas": np.r_[x_intro, x_advanced],
"nota": np.r_[y_intro, y_advanced],
"disciplina": ["Introdutória"]*400 + ["Avançada"]*400,
})
sns.regplot(simpson, x="horas", y="nota")
simpson.horas.corr(simpson.nota)A ampla sobreposição esconde os grupos no gráfico agregado. A disciplina avançada combina mais horas de estudo com uma avaliação mais difícil. Essa composição inverte a associação: esse é o paradoxo de Simpson.
Mesmo com \(r\neq0\), várias explicações permanecem:
\[ X\rightarrow Y,\qquad Y\rightarrow X,\qquad Z\rightarrow X\text{ e }Z\rightarrow Y,\qquad \text{seleção ou acaso}. \]
Na base de seguros, idade, tabagismo, acesso à saúde e regras de cobrança podem estar associados simultaneamente. O coeficiente não decide o mecanismo.
Com muitas séries temporais, categorias ou transformações, algumas correlações altas aparecem por acaso.
Sinais de alerta:
Visualização, validação externa e desenho do estudo importam mais que um número impressionante.
Uma correlação entre médias de estados não implica a mesma relação entre indivíduos.
Esse erro é chamado falácia ecológica.
Se a unidade da linha muda de pessoa para município, estado ou país, mudam também:
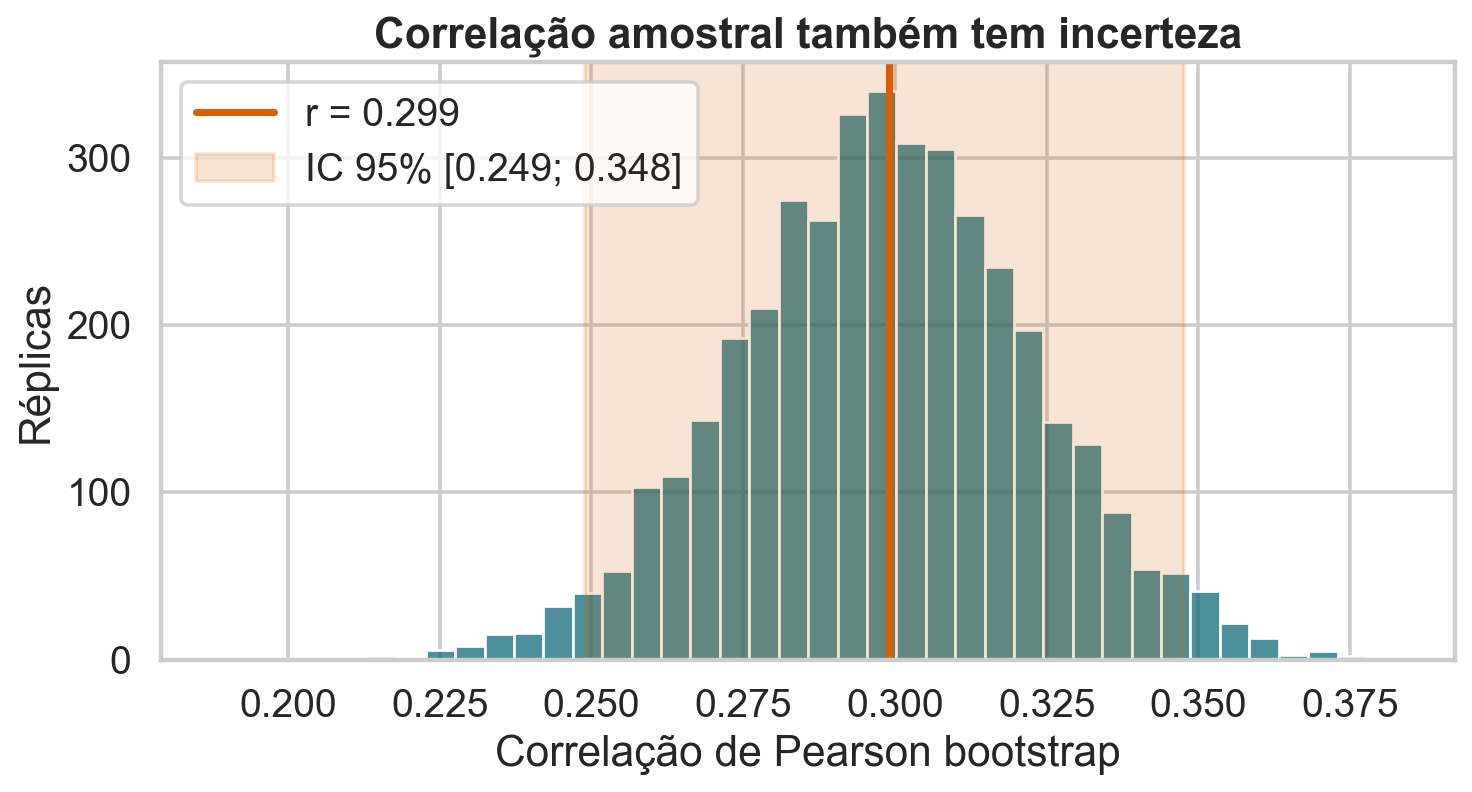
Na população, denotamos a correlação por \(\rho\). Na amostra, calculamos \(r\).
Uma nova amostra produziria outro valor. Para quantificar a incerteza, podemos:
\(H_0:\rho=0\) é uma hipótese sobre correlação linear, não sobre ausência de toda dependência.
Para idade e despesas, o IC bootstrap de 95% é aproximadamente \([0{,}25;0{,}35]\).
Sem calcular, qual resultado é mais plausível?
A correlação resume o quanto duas variáveis se movem juntas. A regressão transforma essa associação em um modelo explícito para a resposta média de \(Y\) em função de \(X\).
ICD: Aula 16 — Correlaçãovoltar para a Aula